8.1 核数据评价与库制作
8.1 核数据评价与库制作
本节摘要:评价核数据库是"整编过的实验"——把全球数十年的截面、衰变、裂变产额测量按严谨规则加权裁决,输出自洽的数字档案(ENDF/B、JEFF、JENDL、CENDL等),并附协方差矩阵量化不确定度。基准实验(临界安全基准、屏蔽基准)是数据库的"期末考试"。本节讲清核计算的这块奠基石如何铸成。
堆芯设计的签字责任落到纸面,第一步引用的不是论文,而是一套数据库。核工程师口中的"ENDF"(评价核数据格式)既是文件格式也是数据体系的代称:每个核素一份档案,记录着从10⁻⁵电子伏到20兆电子伏的中子截面、共振参数、角分布、裂变产额、衰变链、光子产生数据——粗略地说,一个堆芯可能用到的每个"如果……那么……"都被编进了这套档案。
从实验到"评价":一门裁决的手艺
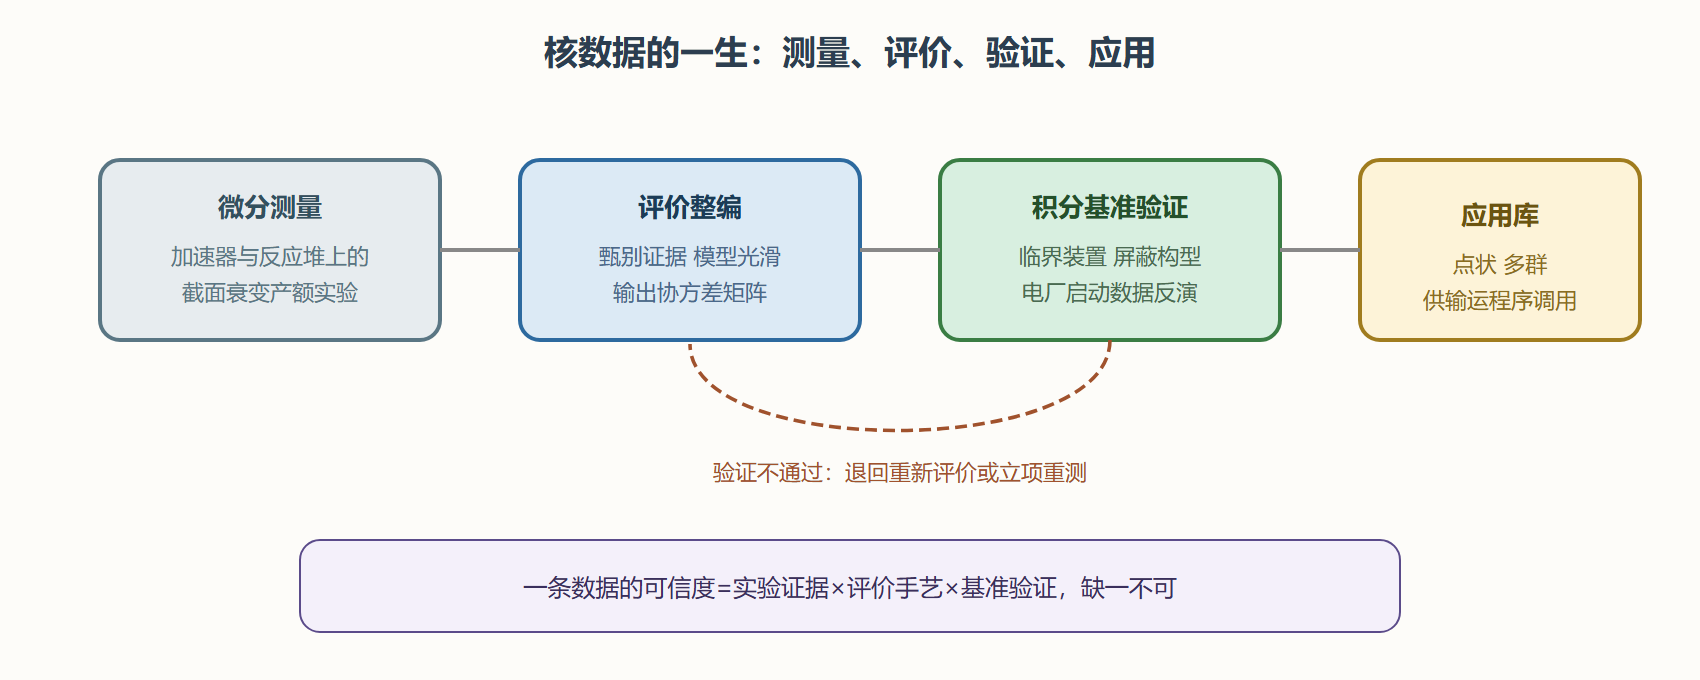
原始截面实验散布在七十年的期刊与实验室报告里,同一反应往往有多个来源、彼此矛盾、各带误差棒。**评价(evaluation)**就是把这些证据裁决成一条"最佳曲线"的手艺:
- 搜集与甄别:汇集全部相关测量,审查每项实验的系统性(探测器刻度、样品纯度、本底扣除),剔除有已知缺陷的。
- 理论拟合与模型:截面曲线不是点点连线——用核反应模型(R矩阵、光学模型、统计模型)做物理光滑,共振区用共振参数拟合,让数据服从物理约束。
- 协方差量化:不仅给出中心值,还给出不确定度与关联矩阵——两个能量的截面误差是否同源、多大程度共变。这是现代评价库与旧曲线册的本质区别。
- 格式化发布:按ENDF格式写成机器可读档案,配处理程序(把点数据处理成连续能谱、多群结构)供计算程序调用。
世界主要评价库构成平行竞争的族谱:美国 ENDF/B、欧洲 JEFF、日本 JENDL、中国 CENDL、俄罗斯 BROND。各家独立评价、定期互查,重大差异(如某个共振参数的分歧)会被国际测量计划专门立项重测——评价库体系本质上是核领域的"全球同行评议基础设施"。
衰变数据与裂变产额
截面之外,两套数据支撑着本册半数章节:
- 衰变数据:半衰期、衰变分支比、射线能量与强度——第一章的衰变账、第五章的显像核素选择、第六章的源项计算全靠它。裂变产物的衰变数据尤其密集(三百多种核素的衰变链),是"源项"计算的原料。
- 裂变产额:铀-235裂变时产氙-135的概率、产碘-131的概率……独立产额与累积产额分开记录(第二章氙毒、事故源项释放清单的原料)。产额随裂变核素与中子能量变化,独立产额曲线就是第一章那张"双峰图"的数字化版本。
基准与验证:数据库的期末考试
评价库发布前必须通过积分基准实验的检验——用已知装置的实测结果反推数据是否合格:
- 临界基准:数以百计的已知几何与成分的临界装置(高浓铀溶液、钚金属、燃料棒阵列),计算的keff必须落在实验不确定度内。国际临界安全基准评价项目(ICSBEP)把全球实验整理成手册,是临界安全分析的法定依据(运输与贮存方案都要对着它算)。
- 屏蔽基准:中子与伽马穿过标准屏蔽构型的透射谱实测,检验截面的正确性。
- 堆芯基准:真实电厂的启动实验数据(临界硼浓度、棒价值、温度系数)反演核数据。
# 演算:核数据不确定度如何传导到keff(一阶传播示意) # 假设keff对各主要核数据的敏感度系数已由微扰计算给出 contribs = { "铀235裂变截面": (0.55, 1.2), # (敏感度, 数据相对不确定度%) "铀235俘获截面": (-0.15, 1.5), "铀238俘获截面": (-0.30, 1.0), "氢散射截面": (0.10, 0.3), } var = sum((s * u) ** 2 for s, u in contribs.values()) print(f"由核数据不确定度贡献的keff标准差约 {math.sqrt(var):.2f}%") import math # 放前面演示亦可
输出:
由核数据不确定度贡献的keff标准差约 0.77%
0.77%的keff不确定度(约1000 pcm)直接吃掉设计裕量的一大块——这就是为什么各国持续投入巨资重测关键截面、更新评价库,也是"核数据外交"(共享测量以分摊成本)在国际核合作中地位特殊的原因。敏感度-不确定度量化(TSURFER类的调整方法)甚至能把实验测量"反哺"回数据调整,让库与基准互相校准。
⚠️ 常见坑:把评价库当"查表软件"随手用。同一核素在不同库、不同版本的数据可能差异显著(共振区的分歧尤其常见);报告计算结果时必须注明所用库的版本——换一个库,keff变化几百pcm是常事。工程评审第一问往往是"用的哪个库"。
💡 关键直觉:评价库是带不确定度的实验共识,不是自然真理。读核计算报告时,除了看结果数字,要看它引用的数据库版本与不确定度声明——后者才是这份报告的"可信度附言"。
图:从原始实验到应用的数据流水线
本节要点回顾
- 评价库是整编过的实验共识:甄别、模型光滑、协方差量化三步铸成;ENDF/B、JEFF、JENDL、CENDL 是平行竞争又互查的族谱。
- 协方差让不确定度一路传导到keff等应用结果,直接决定设计裕量的可信度。
- 衰变数据与裂变产额支撑源项、氙毒、医疗核素等半数应用场景。
- 积分基准是期末考试:临界、屏蔽、堆芯三级验证,不通过就退回重评。
- 用库必须报版本:换库即换结果,评审第一问是"哪个库"。
数据就绪,下一节进入求解器:蒙特卡罗如何逐粒子追出答案,确定论如何在速度与精度间安身。
值班备注:一次库版本升级的连锁反应
评价库发新版本,对下游是一场小型地震。某主力库升级后,几个基准装置的复算结果集体偏移,审评方要求所有在役分析报告注明所用库版本,并在限定年限内完成新版复算——涉及换料安全分析、临界安全评价、屏蔽设计成百上千份文件。更麻烦的是自研程序群:群常数制作程序、燃变链库、裂变产额库要与主库同步更新,任何一处遗漏都会造成混库计算,结果不可追溯。这次教训后,行业建立了库版本管理的强制规范:计算输入必须自动记录库标识,报告模板单列数据来源栏。数据基础设施的严肃性,就在这些看似繁琐的规矩里。