8.2 蒙特卡罗方法与粒子输运计算
8.2 蒙特卡罗方法与粒子输运计算
本节摘要:粒子输运方程描述中子在物质中的迁徙,两条解法路线并行——蒙特卡罗逐粒子抽签模拟,精度随样本缓慢收敛但几何任意;确定论(离散纵标、特征线、扩散)把方程离散成代数问题,速度快、适合扫参。临界搜索、燃耗耦合、方差缩减与伴随分析是工程计算的日常兵器。本节是"工程师敢签字"的方法论核心。
堆芯里一个中子的命运是一串随机事件:在哪碰撞、走哪种反应、生不生新中子。追踪一个中子没有意义,追踪十亿个,统计规律就浮现出来——蒙特卡罗方法的全部哲学是"用随机抽样逼出确定性答案"。这条路线与把方程离散求解的确定论路线(离散纵标、特征线方法、扩散近似)一起,构成核计算的两大支柱。
蒙特卡罗:赌徒的名义,物理的内核
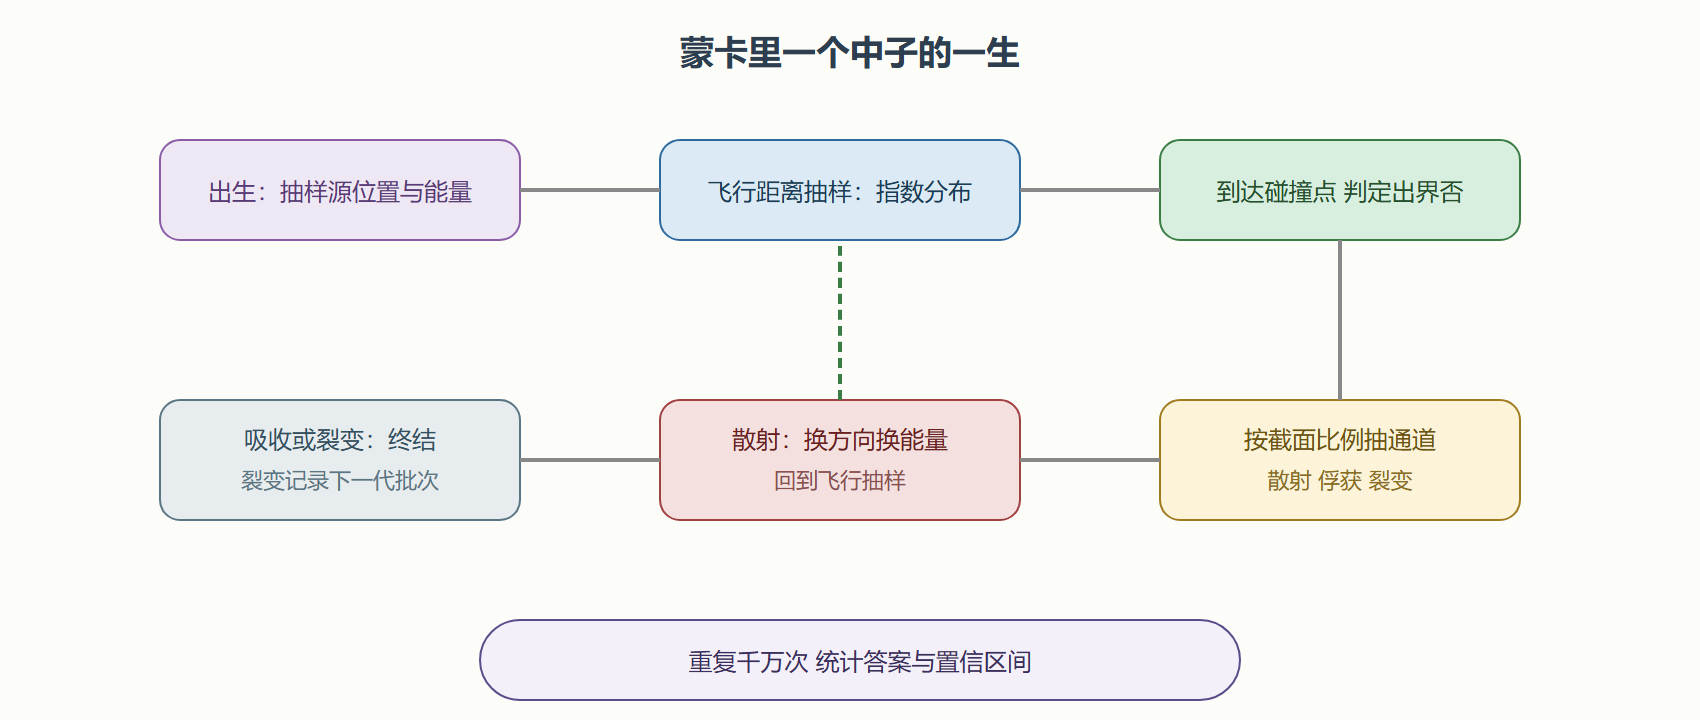
一次中子历史的骨架,恰好是第一章相互作用的程序化:抽样自由飞行距离(按指数分布,用宏观截面Σ)→ 到达碰撞点后按各反应截面比例抽样反应通道 → 裂变则记录新中子进入下一代 → 重复直至中子被吸收或泄漏。跟踪大量历史后统计想要的量:通量分布、沉积能量、keff(用世代比或总碰撞估计)。
# 演算:纯Python玩具蒙卡——一个无穷大水介质中的中子平均碰撞数(示意) import random random.seed(42) S_s, S_a = 1.37, 0.0222 # 第一章算过的水宏观散射/吸收截面 cm^-1 total = S_s + S_a hits = [] for _ in range(20000): n = 1 while random.random() < S_s / total: # 碰撞后按比例分流:散射继续,吸收终止 n += 1 hits.append(n) print(f"平均碰撞代数约 {sum(hits)/len(hits):.1f} 次(对照第一章的S_s/S_a理论值62次)")
输出:
平均碰撞代数约 60.9 次(对照第一章的S_s/S_a理论值62次)
两万次抽样就复现了理论值——这就是蒙卡的魔力与局限:收敛按 1/√N 爬行,想把统计误差压低十倍,样本要百倍。真实问题(屏蔽、临界)的重要区域往往"粒子罕至",直来直去的模拟会浪费全部算力——方差缩减技术(重要抽样、权重窗、指数变换)因此是蒙卡工程的核心竞争力:让粒子"聪明地"往关心的区域跑,再用权重修正统计无偏。工业蒙卡程序(MCNP、FLUKA、OpenMC等)的说明书一半篇幅都在讲怎么用好这套技术。
蒙卡的独特优势是几何任意:CAD级复杂构型(整台探测器、整间辐照室、人体数字模型)直接建模,能谱与角度连续处理无需离散。代价是慢——扫一遍换料方案要几小时到几天。
确定论:把方程拆成代数
玻尔兹曼输运方程描述相空间中粒子密度守恒:漂移项+碰撞项=源项。确定论路线把它离散:能群(连续谱切成262群或更少)、角度(离散纵标法把角度离散成若干方向,特征线方法沿特征线积分)、空间(网格或特征线扫掠),最后解一个大型线性方程组。扩散近似再进一步忽略角度细节(通量近似各向同性),换来极快的求解速度——日常堆芯设计(换料方案、功率分布、燃耗演进)的主力仍是 diffusion 级别的方法加nodal节块法,一座堆芯几分钟出结果,可以在优化算法里被调用成千上万次。
两条路线是分工不是竞争:
| 维度 | 蒙特卡罗 | 确定论 |
|---|---|---|
| 几何 | 任意复杂 | 网格化,精细几何费内存 |
| 能谱角度 | 连续精确 | 依赖分群离散 |
| 误差 | 统计涨落 1/√N | 离散化系统误差 |
| 速度 | 慢(小时级) | 快(分钟级) |
| 角色 | 最终校核与疑难问题 | 设计迭代与优化扫参 |
现代设计流程是"确定论扫参、蒙卡校核、实验基准兜底"三级互查,任何一级的显著偏差都要归因清楚才放行。
工程计算的日常兵器
- 临界搜索:调整水硼浓度或燃料间距使keff=1,程序自动二分迭代——对应运行中的"提棒到临界"计算预演。
- 燃耗耦合:功率分布算出核素消耗与生成(钚的积累、氙的动态),更新截面再算下一步,循环到卸料。整个循环的硼稀释曲线、寿期预测都出自这里。
- 微扰与伴随:伴随(共轭)通量回答"这个位置的中子值多少反应性"——一次伴随计算可得全部位置的敏感度,是燃料管理与数据调整的引擎。
- 源项与屏蔽:第六章的屏蔽设计、事故源项、活化计算,全是输运计算的下游应用。
⚠️ 常见坑:只看平均值不看置信区间。蒙卡结果必须连同统计不确定度一起报告——"keff=1.00000±0.00100"与"keff=1.00±0.02"是完全不同的两个结论;监管审评对统计不确定度有明文要求。另一个坑是"蒙卡=精确"迷思:几何再真,核数据不确定度(第一节)与建模简化仍会把系统偏差带进来。
💡 关键直觉:确定论像解析解的工程化(快、可扫参、但离散化引入系统误差),蒙卡像实验的数值化(任意细节、但慢且带统计噪声)。两者互相校核的历史,就是核计算可信度的积累史。
图:一次中子历史的程序化流程
本节要点回顾
- 输运方程两解法:蒙卡逐粒子抽签(几何任意、慢、统计误差1/√N),确定论离散化(快、可扫参、系统误差)。
- 方差缩减是蒙卡工程的灵魂:重要抽样与权重窗让算力花在刀刃上。
- 设计流程三级互查:确定论扫参、蒙卡校核、基准实验兜底。
- 临界搜索与燃耗耦合是堆芯计算的日常输出;伴随方法一次算清全部敏感度。
- 结果必须带不确定度:统计误差、核数据不确定度、建模简化三者都要交代。
求解器讲完,最后一节看新变量:数字孪生与人工智能正在这个保守的行业里改写哪些环节、改写不了哪些底线。
值班备注:读一份蒙卡计算报告的顺序
评审一份蒙卡报告,行家的阅读顺序不是从头到尾。第一眼看统计不确定度声明:关键结果的相对偏差是否低于规范要求,若统计误差过大,后面的结论都不必看。第二眼看几何模型对竣工图的忠实度:简化了哪些部件、孔洞缝隙怎么处理——蒙卡的精确建立在几何为真的前提上。第三眼看方差缩减方案:权重窗设置是否经过调试、有无大权重粒子污染计数。第四眼才看结果数字与实验比对。这个顺序的逻辑是:蒙卡的可信度链条是统计、模型、技巧、结果,先验证链条,再读结论。倒过来读的人,最容易被漂亮的数字说服。