8.3 核工业数字化与人工智能
8.3 核工业数字化与人工智能
本节摘要:核工业的数字化沿三条战线推进——设计端的数字孪生与蒙卡加速、运行端的预测性维护与故障诊断、监管端的数字取证;机器学习以代理模型、图像识别、异常检测三种姿态渗透。但验证与确认(V&V)、可解释性与数据稀缺仍是硬约束——AI 可以加速,签字责任仍是人的。本节是第八章也是全册技术篇的收官。
核电是一个有趣的数字化样本:它同时是最保守的行业之一(仪控系统更新以十年计)与最早的重计算行业之一(第二节那套数值方法在计算机诞生初期就开始用)。理解这对矛盾,就理解了人工智能进入核工业的姿态:不是颠覆叙事,是找缝隙落子。
三条战线:设计、运行、监管
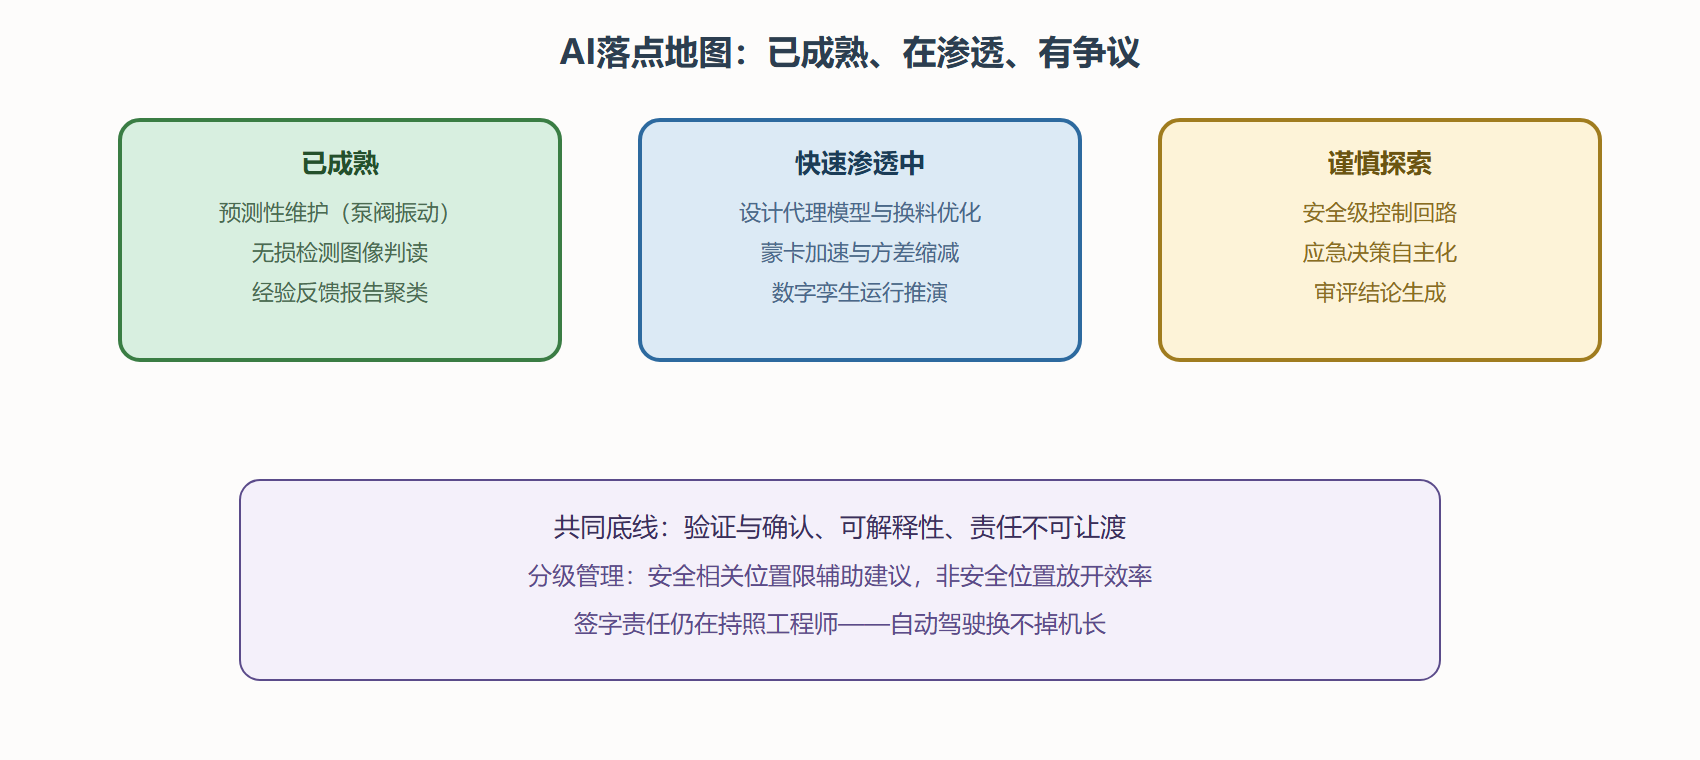
设计端:数字孪生是当红概念——给电厂建一套实时同步的物理模型,设计阶段做"虚拟调试"(在数字堆上试运行方案、试换料计划),运行阶段做状态推演(把当前状态外推,预判参数走向)。更实际的进展在蒙卡加速:用机器学习代理模型(神经网络学蒙卡结果的映射)替代部分昂贵计算,换料优化从"每循环几十次仿真"变成"上千次搜索";也用于智能方差缩减参数的自适应调节。第一节讲的核数据调整、第二节的伴随敏感度分析,都在被代理模型加速。
运行端:预测性维护是最成熟的一块——水泵振动谱、变压器油色谱、蒸汽发生器传热管涡流信号,交给异常检测算法提前数周发现劣化趋势,把"定期检修"换成"状态检修"。经验反馈系统用自然语言处理扫描全球运行事件报告(每件事件都是宝贵样本),自动聚类相似根因——核电的安全改进高度依赖"别人的教训",NLP 把这件事的效率提高了几个量级。声学监测(松脱部件监测的智能分类)、管道腐蚀超声导波的AI判读,都已商用。
监管端:数字孪生被监管机构视为评审工具的升级——审评方与设计方在同一套模型上对质;检查数据的自动分析、安全指标的实时仪表板也在推进。监管对AI的态度是行业风向标:国际原子能机构与各国监管机构都出台了AI在核安全相关应用中的立场文件,共同基调是"分级管理、可追溯、人责不可让渡"。
机器学习的三种姿态
- 代理模型(学物理):神经网络逼近输运计算或热工分析的输入输出关系,快数千倍——用于优化循环内部。风险在"训练域外",外推即不可信,必须圈定适用范围。
- 模式识别(学信号):识别焊缝射线底片缺陷、涡流信号分类、振动谱诊断——这类任务与医学影像同构,卷积网络表现好。瓶颈是标注数据稀缺(缺陷样本天然稀少),行业靠合成数据与迁移学习补课。
- 异常检测(学正常):只学"正常长什么样",一切偏离即报警——不需要缺陷标签,特别适合核电这种"故障样本少、代价高"的场景。
# 演示:残差异常检测的最小原型(正常参数基线 + 新观测的偏离度) baseline = [241.2, 239.8, 240.5, 241.0, 240.3, 240.8] # 主泵振动均方根 mm/s 历史 mu = sum(baseline) / len(baseline) sigma = (sum((x - mu) ** 2 for x in baseline) / (len(baseline) - 1)) ** 0.5 for new in [241.1, 243.9]: z = (new - mu) / sigma print(f"观测 {new} mm/s:偏离 {z:.1f} 个标准差", "→ 报警" if z > 3 else "→ 正常")
输出:
观测 241.1 mm/s:偏离 0.3 个标准差 → 正常 观测 243.9 mm/s:偏离 8.9 个标准差 → 报警
八倍标准差的偏离在真实设备上几乎必然对应机械状态改变——统计过程控制的思路与第六章第一节"泊松统计"的裁判精神一脉相承。真实系统更复杂(多变量、时序、缓变漂移),但骨架就是如此朴素。
硬约束:AI 改写不了的底线
验证与确认(V&V):安全相关软件必须经历"代码验证(数学对不对)—程序确认(物理对不对)—质量保证(流程可控)"三重审查,动辄十年。AI模型的黑箱性与V&V体系天然紧张——监管的解法是把AI限定在"非安全分级或辅助建议"位置,或要求可解释性证明。
数据稀缺:核电事件是低频事件,真实故障数据永远不够训练;福岛级样本全球只有一份。合成数据、物理信息神经网络(把守恒律写进损失函数)、小样本学习是当前的补课方向。
责任归属:算法建议+人决策的框架下,签字责任仍在持照工程师——这与航空业"自动驾驶不换掉机长"的逻辑一致。核行业的信任是靠"可追溯的保守"攒出来的,任何技术入场都要过这道安检。
⚠️ 常见坑:把"上了AI"当成果本身。评估一个核工业AI应用,先问三题:训练数据从哪来(真实还是合成)?适用边界圈了吗(外推如何拦截)?出错时责任链在哪(谁复核、怎么降级)?三题答不清的演示系统离工程还有几个验收周期。
图:人工智能在核工业的落点地图
本节要点回顾
- 三条战线:设计端(数字孪生、代理模型)、运行端(预测性维护、经验反馈挖掘)、监管端(评审工具与AI立场文件)。
- 机器学习三姿态:学物理(代理模型)、学信号(模式识别)、学正常(异常检测)——姿态决定数据需求与风险形态。
- 数据稀缺是行业宿命:低频事件+高代价,靠合成数据与物理先验补课。
- V&V与责任归属是底线:AI加速一切,签字仍是人的。
- 评估AI应用三问:数据哪来、边界在哪、责任链如何。
第八章合卷,全册的技术叙事到此完整。最后一章离开机房,走进谈判桌、听证会与电价表——核政策、经济、监管与公众沟通,是这门技术最终安身立命的社会土壤。
值班备注:一个预测性维护项目的验收单
某电厂上马水泵振动智能预警系统,验收时业主要求同时提交四份材料:训练数据的来源与时间跨度清单;混淆矩阵与漏报率专项测试报告——漏报比误报致命,权重不同;现场连续运行六个月的实战记录,期间每一次真实劣化是否预警、预警提前了多少天;以及降级方案:算法失效或模型漂移时,如何自动回退到传统阈值报警。这份验收单的要点在于,它把算法当设备而不是魔法来验收:有铭牌、有失效模式、有备用通道。项目最终通过,但漏报率测试逼出了两轮模型迭代——监管化的验收标准,正是这个行业把新技术驯化的方式。