2.1 基因组行囊:七种核酸打包方案
2.1 基因组行囊:七种核酸打包方案
一句话结论:病毒基因组只有四种化学形态(双链 DNA、单链 DNA、双链 RNA、单链 RNA),加上"正义或反义""是否逆转录"两个开关,组合出 Baltimore 七类打包方案;再叠加"线性或环状、分节段与否、重叠基因与否"三个包装属性,就构成每粒病毒的行囊清单。
承接第 1 章的档案卡:分类学问的是"你带什么基因组",本节要回答的是"这种打包方式对旅程意味着什么"。同样叫核酸,一条双链 DNA 和一条负链 RNA 的旅行体验天差地别——前者稳定、可大、可慢,后者轻、快、但极易出错。理解这些权衡,是读懂第 4 章复制剧本和第 7 章演化速度的前提。
化学形态与两个开关
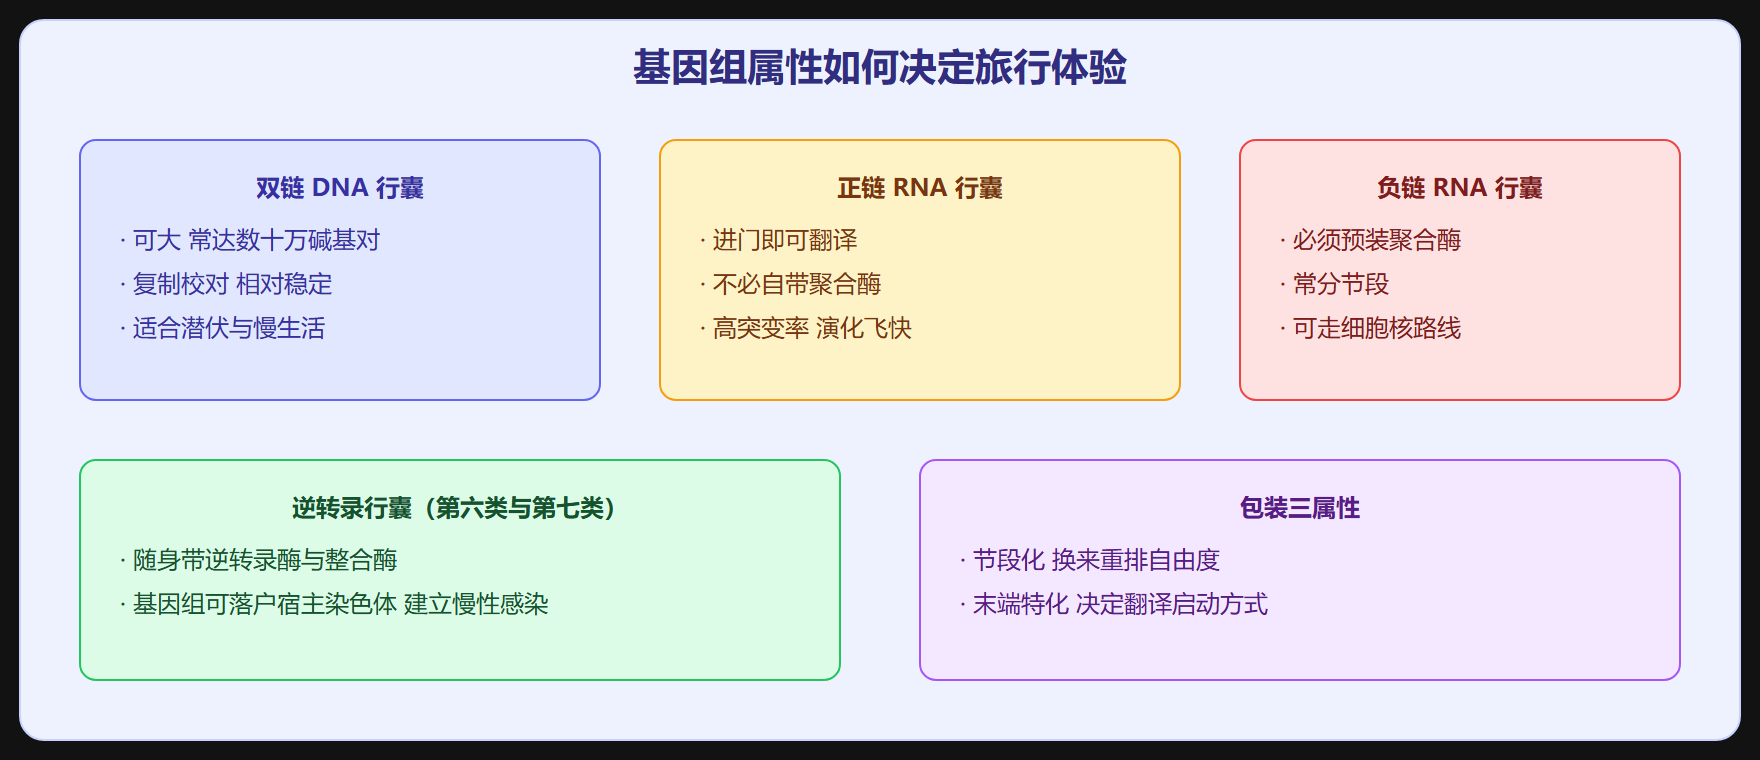
四种化学形态里,双链 DNA 最稳定,没有 RNA 那种 2 位羟基参与的水解反应,所以疱疹病毒敢带着十几万碱基对的大基因组到处走;RNA 则普遍短小,动辄几 kb 到十几 kb,再长就会被复制错误率压垮。两个开关:单链 RNA 有极性之分——正义链(正链)序列与信使 RNA 相同,进细胞即可翻译;反义链(负链)是信使 RNA 的互补链,必须先拷贝一道才能用,因此负链病毒粒子内必须预装一个聚合酶。逆转录开关则造就两个特殊类群:HIV 把 RNA 基因组逆转录成 DNA 再整合进宿主染色体;乙肝病毒反过来,带着 DNA 却要经由 RNA 中间体扩增。
包装属性:节段、末端与压缩
三个包装属性决定行为的差异常常被低估。
分节段。流感病毒基因组分八段(甲型),轮状病毒分十一段。分段的收益是基因重排——两种毒株共感染同一细胞,子代可以拿到全新的段组合,这是流感大流行株的生成机制;代价是必须保证每个颗粒恰好装齐所有段,否则"缺失感染颗粒"比例升高(这也解释了为什么流感疫苗种子株的产量那么难稳定)。
末端结构。脊髓灰质炎病毒基因组 5 端挂着一个病毒蛋白 VPg 而不是帽子结构;冠状病毒 5 端有帽子、3 端有 poly(A) 尾,伪装成细胞信使 RNA 来骗翻译机器;细小病毒做成线性末端发卡结构,解决末端复制问题。末端结构直接决定翻译启动方式,也就决定第 4 章的转录策略细节。
重叠基因。乙肝病毒约三千二百碱基对,四个读码框中多个基因首尾相叠,同一段序列被翻译两遍;噬菌体 phiX174 更极端,一段 DNA 里嵌套 B 在 A 内、E 在 D 内。压缩的驱动力很明确:衣壳容积有限,少一个碱基就少一分包装压力。
一个算术题:为什么 RNA 病毒都不敢长大
可以做个粗略估算。RNA 依赖的 RNA 聚合酶没有校对功能,每个碱基每轮复制出错概率约在十万分之一上下(冠状病毒因带校对外切酶略低)。基因组长度乘以错误率,得到每轮每基因组的突变数:一万碱基的基因组,每个子代平均带零点一个突变;如果基因组长到十万碱基,每个子代平均带一个突变——致命突变会迅速累积,群体滑向"错误灾变"。这道简单的乘法,给出了 RNA 病毒的尺寸上限,也解释了 RNA 病毒为何普遍是小基因组高变异、DNA 大病毒则可以携带上百个基因慢慢经营。第 7 章讲抗原漂移速度、第 8 章讲耐药突变出现频率时,用的都是这条乘法。
顺带一个实用的伪代码,演示如何从测序读数粗判基因组类型(科研与诊断中的常见预处理思路):
输入: 宏基因组拼接得到的重叠群序列 C 步骤1 统计碱基组成偏离与读码框密度 排除宿主来源 步骤2 搜索标志结构域: RdRp(聚合酶)、RT(逆转录酶)、 衣壳蛋白折叠指纹 步骤3 若找到 RT 且基因组为 RNA → 第六类 逆转录病毒样 若找到 RT 且基因组为 DNA → 第七类 嗜肝DNA样 若找到 RdRp 且含负链基因排列顺序 → 第五类 若 RdRp 且读码框带帽子模仿信号 → 第四类 若双链RNA分节段保守末端 → 第三类 若 DNA 且复制期进入细胞核 → 第一或第二类 步骤4 系统发育建树 定科属 输出: Baltimore 类别候选 加 ICTV 定位
易错点辨析
三组概念最容易混。正链与负链是相对于信使 RNA 的极性描述,不是"好与坏"或"强与弱";冠状病毒虽是正链,致病力照样凶猛。单链 DNA 病毒进入细胞后要先变成双链才能转录,所以它复制慢、依赖细胞分裂期——细小病毒偏爱分裂旺盛的组织(如骨髓红系前体),原理即在此。"分节段"与"多组分"也不同:流感八段装在一个颗粒里,而某些植物病毒的不同基因组片段分装在不同颗粒中,必须一组颗粒同时感染才能复制。
一张速记表:DNA 能大、RNA 求快;正链轻装、负链带泵;逆转录两边站(第六类从 RNA 到 DNA,第七类从 DNA 经 RNA);节段换重排、重叠省空间、末端定翻译。
打包方案速记卡与推演练习
给一张"打包即预言"的速记卡,把本节知识压成可执行的推理规则:看到双链 DNA,预言"大基因组、潜伏能力、低突变、药物靶点在 DNA 聚合酶或更晚";看到正链 RNA,预言"进门即译、胞质复制、复制快、变异快、疫苗需追新";看到负链 RNA,预言"粒子带聚合酶、常分节段、重配风险";看到逆转录标志,预言"存在库、慢性化、联合用药、功能性治愈叙事"。四条规则覆盖七类,实际用的时候再细分。
再做一个双向推演练习巩固。正向:给"冠状病毒"这个词,你能推出它的行囊是正链 RNA、带帽子与聚腺苷尾、有校对外切酶、基因组约三万碱基。反向:给"某病毒粒子内检出依赖 RNA 的 RNA 聚合酶、基因组分八段、核内复制",你能推出它是负链分节段病毒(正黏科候选)、必然走帽子掠夺路线、有重配造新株的风险、疫苗需要年度评估。正反两个方向都流畅,本节的目标就达到了。最后提醒一个易漏点:打包方案描述的是"病毒粒子里装的东西",不是"细胞里复制的中间体"——中间体的形态(如逆转录病毒的 DNA 中间体、嗜肝病毒的 RNA 前基因组)属于第 4 章复制剧本的内容,两套概念要分开记账。
补一个常见考点辨析:病毒基因组的"单链"不等于"只含一条链"——逆转录病毒粒子内是两条相同的正链 RNA(二聚体),呼肠孤病毒的"双链"是真正的互补双链。初学者常把"颗粒内核酸分子数"与"链的极性"混为一谈,考试与文献阅读时先分清这两个维度再下判断。
最后一个观察练习:打开任何病毒基因组数据库页面,先看三个字段——核酸类型、基因组长度、分节段与否。三个字段即是"打包方案速查"的入口;再点开注释看读码框数量与重叠情况,就能估出它的信息压缩程度。五分钟的数据库习惯,胜过一小时的名词背诵。