5.2 别挤垮舞台:拥塞控制与能量效率
5.2 别挤垮舞台:拥塞控制与能量效率
拥塞控制在队列溢出前后调节入网流量,避免缓冲区挤爆引发雪崩丢包;能量效率把每比特的传输成本压到最低。两者在多跳网络里深度纠缠:拥塞的重传烧的是电池,节能的睡眠又抬升排队时延。
拥塞在多跳网络里有个帮凶:反馈太慢。有线互联网的 TCP 靠丢包或时延信号感知拥塞,收端到发端的反馈只要几十毫秒;多跳无线网里,等源节点通过丢包"感觉到"拥塞时,中间节点的队列早就溢出几轮了,而且源节点的反应(降速)要穿越同样拥挤的路径才能生效。所以自组织网络的拥塞控制讲究"在离拥塞最近的地方动手"。
队列管理三部曲
缓冲区是网络里最容易被误用的部件。尾部丢弃是最简单的策略:队列满了丢新来的。它在无线网里有两个恶果:一是突发误伤——一串突发的语音帧可能整队被丢;二是全局同步——大量流同时被丢、同时退避、同时重发,吞吐曲线呈锯齿状荡秋千。随机早期检测(RED 类思路)治这个病:队列还没满就按概率丢少量报文,丢谁随机挑,早丢、轻丢、分散丢,让发送端提前减速而不是集体撞墙。概率随队列占用率上升,拐点两个参数(开始丢的低阈值、丢满的高阈值)决定性格。区分服务再加一层公平:队列按业务等级分几个子队列,语音进高优先级、采集数据进尽力而为、固件升级进背景级——挤的时候先牺牲背景级,等级间的比例可调。
RED 风格的入队决策(示意): q = 当前队列长度; qmin = 0.3 * 容量; qmax = 0.7 * 容量 若 q < qmin:全部入队 若 qmin <= q < qmax:按概率 p 丢弃,p 随 q 从 0 线性升到 pmax 若 q >= qmax:全部丢弃(保守版可改为标记而非丢弃) 配合指数加权平滑队列长度,避免被突发误触发
队列之外,拥塞信号还有两个更早的信源:MAC 层的信道占用率(媒介几乎一直忙,说明空口已饱和)与队列增长速率(排队的速度超过排走的速度)。把这两个信号逐跳向上游回传,让上游节点提前限速或分流,比等源端丢包反应快一个数量级——这叫逐跳反压,代价是每跳都要维护一点状态。
能量账本与拥塞的纠缠
能量效率的度量不只是"少耗电",而是每成功传输一比特花多少能量。这个复合指标很无情:重传的能耗全部计入分子,成功率全部计入分母——一条高误码链路省下的发射功率,会被重传加倍奉还。所以省电的正确姿势不是一味压功率,而是找"每比特能量最低"的工作点,通常在中等速率档、中等功率档附近(速率太低浪费通话时间,功率太高重传少但每比特贵)。
拥塞与能耗的纠缠有三条线。其一,拥塞即浪费:排队与重传的每一毫焦都不产生有效载荷,控制拥塞就是控制能耗。其二,睡眠除了拥塞:睡眠节点不占空口,客观上给清醒节点腾了容量——但被寻址时找不到人又抬高时延。其三,占空比与突发两难:同步周期睡眠(4.2 的方案)在低负载时极省,高负载时数据在窗口里挤成突发,反而诱发窗口期拥塞。工程解法是自适应占空比:负载低睡长些,负载高醒长些,用一条简单的负载阈值带滞回实现。
一段能量效率的对比计算:
# 两种速率档的每比特能量比较(示意数值) # 档A:低速率 高成功率;档B:高速率 低成功率 p_tx = 0.10 # 发射功率,瓦 t_bit_A, t_bit_B = 4e-6, 1.2e-6 # 每比特空口时间,秒 succ_A, succ_B = 0.98, 0.70 # 单次传输成功率 e_bit_A = p_tx * t_bit_A / succ_A e_bit_B = p_tx * t_bit_B / succ_B print(f"档A每比特能量 {e_bit_A*1e6:.2f} 微焦") print(f"档B每比特能量 {e_bit_B*1e6:.2f} 微焦") # 输出:档A每比特能量 0.41 微焦 # 档B每比特能量 0.17 微焦 # 但注意:档B单包期望发送次数约 1.43 次,时延与队列压力上升 # 结论:能量视角选档B,时延视角选档A,负载轻选B、负载重选A
一次窗口期拥塞的排障记录
背景:传感采集网,四百节点,同步周期睡眠(每分钟醒六秒)。一期运行良好,二期把采集频率翻倍后丢包率从百分之零点八涨到百分之六。操作:单看日均值完全正常,按时间切片才发现丢包全部集中在清醒窗口内——窗口期信道占用率高达九成五,队列尾部丢弃成灾。处置三选一:拉长清醒窗口(多耗电)、提高发送功率与速率档(重传风险)、错峰分批发送(不动硬件)。最终选错峰:按节点编号把四百个节点分成四批,批间隔一点五秒,窗口期从"全员齐射"变成"四波轮射"。结果:丢包率回落到百分之零点九,能耗基本不变(总清醒时长没变,只是错开)。解读:拥塞的本质是时间上的集中,错峰是零成本的容量扩容;这案例也说明日均值会撒谎,时间切片才说真话——与时延预算表一样,统计口径决定结论。变式:若采集频率再翻倍,错峰也无济于事,就要动睡眠参数或加网关分片,容量问题终究要回到容量手段。
判断拥塞位置的快速三板斧
现场排障时,先定位"挤在哪"再动手。第一板斧,看队列分布:如果只有个别节点(通常是网关邻接、骨干汇聚点)队列长期高位,是结构性拥塞——漏斗口问题,按本节的分流与错峰处理,或按第7章加骨干。第二板斧,看时间分布:队列全天平稳说明容量整体不足;只在特定窗口(如错峰失败后的清醒窗口、业务高峰)尖峰,是调度性拥塞——调时序就够,不用动硬件。第三板斧,看控制面占比:如果数据还没起来、控制消息已占空口两三成,是自干扰性拥塞——路由风暴或信标过频,回第7章的广播管制。三斧头按顺序劈下来,拥塞的类型与位置基本现形,避免"一拥塞就加带宽"的粗放治疗。
阈值要有基线
三板斧里的"队列高位""控制占比偏高"都依赖阈值,而阈值的死敌是一刀切。正确做法是先采一周基线(分时段、分区域记录正常值),再在基线上加余量定阈值;网络结构一变(加节点、调业务),基线重采。没有基线的阈值等于拍脑袋,要么常年误报被静音,要么形同虚设。这一条同样适用于 5.1 的告警与 8.2 的异常检测——所有"异常"都是相对"正常"而言的,正常长什么样必须先量出来。
三种队列策略的对照图
队列管理三部曲画在同一张图上最容易记:同一个缓冲区,尾部丢弃在满时一刀切,早期随机在半满时零星丢,分级队列把不同业务分道行驶。图的下半部分是三种策略下的时延曲线对比——锯齿荡秋千的是尾部丢弃的典型签名。
图:一个缓冲区的三种管法
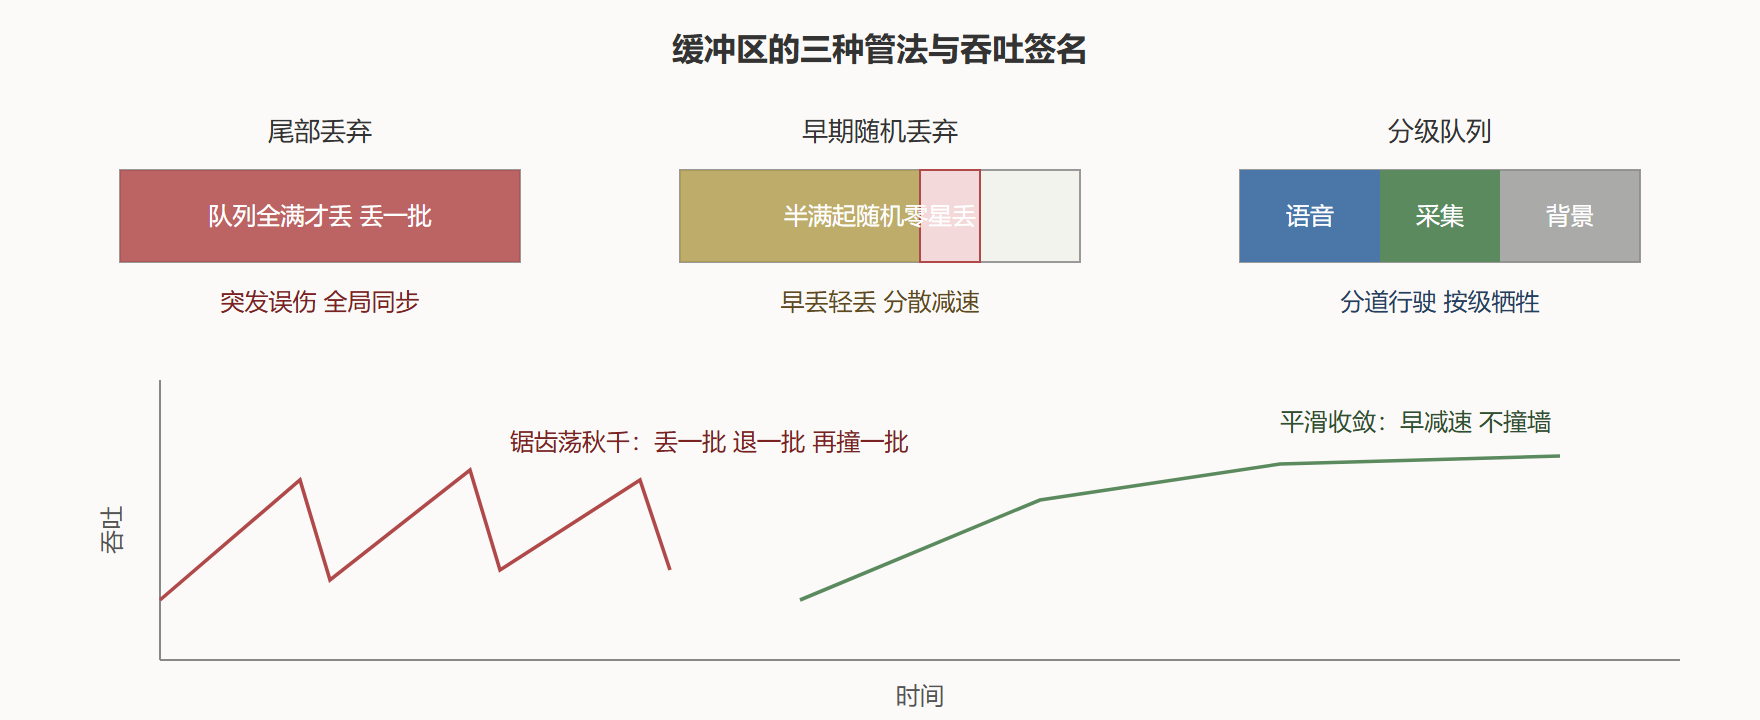
这张图也是排障速查表:监控里看到吞吐呈锯齿、丢包成批出现,先怀疑尾部丢弃在起作用;看到某类业务时延稳定而另一类排队飙升,去看分级队列的比例配置;丢包零星但持续、吞吐却上不去,多半是早期随机在正常工作——它丢的那几个包正是让全局不撞墙的代价。把图里的签名认熟,拥塞类故障的定位时间能缩短一大半。
台词摘录
- 就近动手:多跳网络反馈慢,拥塞控制要在离拥塞最近的跳位处理。
- 早丢轻丢分散丢:随机早期检测的六字诀,治尾部丢弃的误伤与同步。
- 逐跳反压:信道占用与队列增速是比丢包更早的信号,向上游回传提前限速。
- 每比特能量:省电的正确度量是分母带成功率的复合指标,重传是能量刺客。
- 均值会撒谎:按时间切片与分场景统计,是质量归因的基本功。