5.3 彩排场:仿真评估与实测方法
5.3 彩排场:仿真评估与实测方法
仿真评估在 NS-3、OMNeT++ 这类离散事件平台上复现网络行为,用可控实验回答"如果"问题;实测方法用试验床与现场试点校验仿真的结论。两者的配合纪律是:仿真管因果、实测管校准,任何一方的结论都不能直接当成另一方的。
没有彩排就上舞台,是部署大忌。真实网络只有一次机会,而你想试的方案有十种——仿真存在的意义就是让"试错"变得廉价且可重复。但彩排永远不是演出本身:仿真器的每一个模型都是对现实的简化,简化错的方向恰好是你关心的方向,结论就整体作废。这一节讲怎么搭一个可信的彩排场,以及怎么让实测反过来校准它。
三层实验体系
第一层是算法仿真(比如用 Python 写个网络模拟脚本):只模拟拓扑变化与协议逻辑,忽略无线细节,跑得飞快,用来扫参数、找趋势。第二层是网络仿真(NS-3、OMNeT++、GloMoSim 一类):离散事件驱动,带无线信道模型、MAC 模型与协议栈实现,跑得慢但贴近真机行为,用来出论文级与方案级结论。第三层是试验床实测:几十上百台真设备放在真实环境(楼顶、车辆、野外),无线传播、干扰、硬件时序全是真的,用来最终验收。三层的关系是漏斗:算法层一天能扫一千个参数组合,网络层筛出十个,实测验证两三个。跳层是大忌——从算法仿真直接下结论部署的人,会在现场重新认识世界。
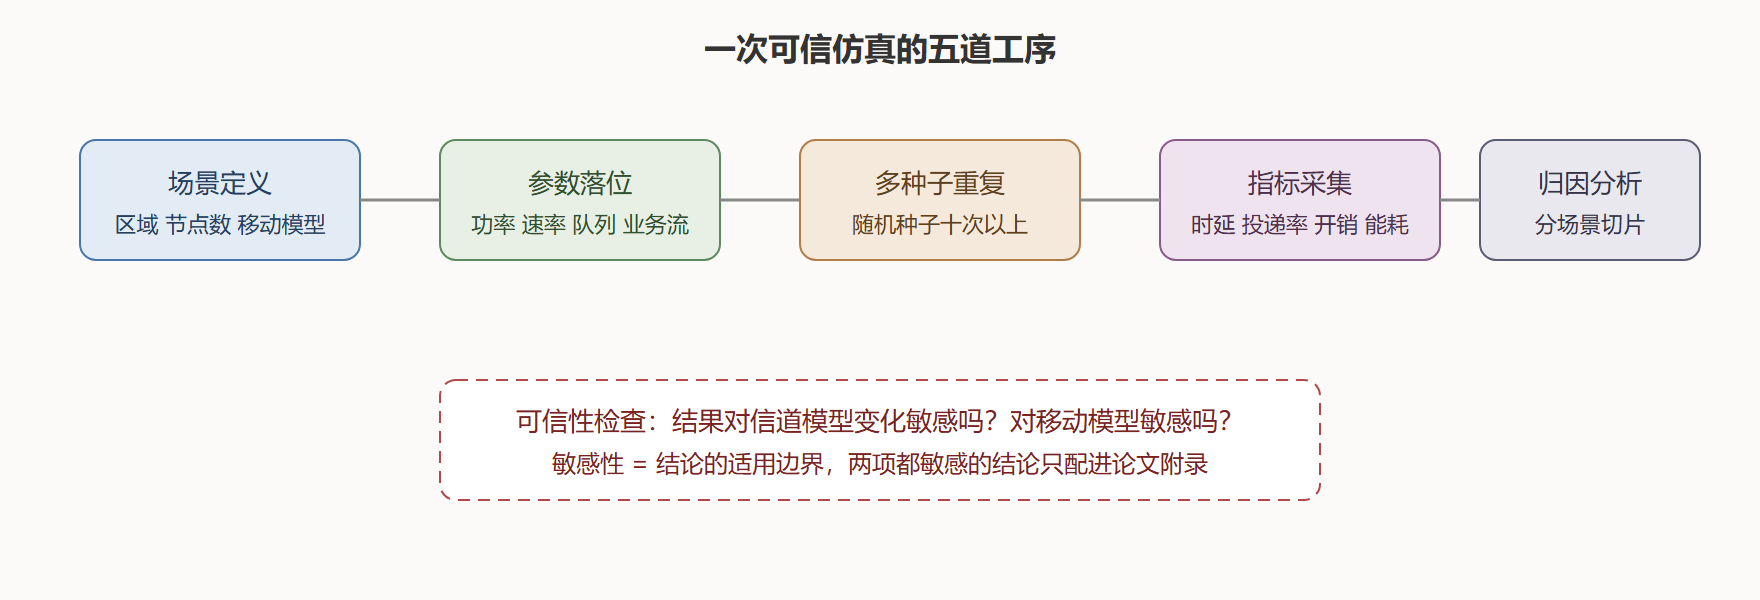
图:仿真实验的流水线
可信性从哪里来
第一个来源是统计纪律。随机性(节点位置、移动、业务到达)意味着单次仿真只是抽样,至少十次不同随机种子、报告均值与置信区间是底线;只报最好一次结果的材料,可信度按零处理。第二个来源是敏感性检查:把信道模型从自由空间换成带遮挡的经验模型,把移动模型从随机路点换成轨迹回放,结论若发生质变,说明结论依附于模型假设而非机制本身——这样的结论只能带条件发布。第三个来源是实测校准:把试验床实测的时延分布、投递率曲线拿回来,调仿真参数直到分布吻合,校准过的仿真器结论才有"预测力"。校准一次不够,环境换了要重校准——仿真器不是通用真值机,是某片环境的方言翻译。
以 NS-3 为例跑一组对比实验的骨架(命令行示意):
场景脚本:100 节点,随机路点,速度 5 m/s,AODV 对 OLSR 对比 对每个协议跑 10 个种子: ./ns3 run "scratch-manet-compare --protocol=aodv --seed=7 \ --nodes=100 --simTime=300 --tracing=true" ./ns3 run "scratch-manet-compare --protocol=olsr --seed=7 ..." 输出每次的投递率、平均时延、路由开销字节数 后处理:对 10 个种子算均值与置信区间,输出对比表 关键:两种协议除协议名外全部参数一致,一次只动一个变量
试验床与现场实测的门道
实测不是"把设备摆出去看跑不跑"。要抓三样东西:有基准的指标(跑一套已知负载,记录时延分布与投递率作为基线,之后任何改动都有对照)、故障注入的能力(能人为关节点、屏蔽链路,验证自愈指标——不主动弄坏它,你永远不知道它坏起来什么样)、可回溯的日志(每节点的时间戳对齐——3.3 的对时在这里派上用场——控制消息全量落盘)。现场试点的额外一条:环境档案。温度、湿度、人流、干扰源频谱快照,这些"背景变量"决定了试点结论能不能迁移到下一个场地。
一个反复出现的教训值得写下来:仿真里投递率百分之九十八的方案,到现场常掉到九十以下,差距大头往往不在协议,而在仿真器没建模的东西——同频干扰(旁边楼里的 Wi-Fi)、多径衰落的时间相关性、硬件的开关机时序。所以实测指标普遍比仿真差一个档位,这几乎是规律;方案设计时预留这个落差(仿真里做到九十九才敢承诺现场九十五),是工程成熟度的标志。
一次三层漏斗的完整使用
背景:为桥梁监测选路由方案,候选 AODV 与一个分簇方案。操作:算法层用两百行脚本扫"断链率从每分钟零次到两次"区间,发现分簇方案在断链率超过每分钟零点五次后重构开销反噬;网络层用 NS-3 复现该区间,确认拐点存在但位置右移到零点八次;实测在试验床(二十节点)人为关节点制造断链,实测拐点约每分钟零点六次。最终方案:桥面主体用分簇(实测断链率约零点二次/分,安全区),伸缩缝附近的六个易动节点单独划域跑按需路由。解读:三层各自给出的拐点数字不同,但"拐点存在且分簇怕高频断链"这个结构性结论贯穿三层——数字属于具体环境,结构才可迁移。变式:换一座钢结构桥,干扰环境更差,断链率升到零点七,分簇域就要再收窄——结论的结构不变,参数随环境重标定。
复现别人结果的三条纪律
借鉴文献与开源报告的仿真数字时,三条纪律能救命。纪律一,抄场景不抄数字:节点数、密度、移动模型、业务负载、指标口径全部对齐了,数字才有可比性——文献里"投递率提升百分之十二"在你自己的场景可能是负数,差异往往就藏在没写的参数里(包长、队列大小、种子数)。纪律二,问模型不问结论:对方用哪个信道模型、有没有建模干扰,直接决定结论的适用边界;自由空间模型得出的结论,搬到室内环境等于换了一个世界。纪律三,复跑最小案例:真正重要的方案,花半天把它在开源仿真器里跑起来,用自己的一组参数对照——能复现的方案才进了你的工具箱,复现不了的引用时打个问号。这三条纪律与三层漏斗同属一件事:让每一个被采信的数字都有可追溯的出生证明。
工具怎么配对
仿真器与试验床不必二选一,成熟团队是三件套配对使用:仿真器做主战场,试验床做校准器,真实轨迹与负载记录做燃料库。工具间要提前约定"同一套指标口径"——投递率在仿真里按发送计数、在实测里可能按接收计数,口径没对齐前,两边的数字不要出现在同一张表里。配置与脚本进版本库,实验日志与结果归档编号,三个月后还能复现当时那组数字,才算通过了彩排场的基本验收。
台词摘录
- 三层漏斗:算法层扫趋势、仿真层出结论、实测层做验收,跳层就是跳坑。
- 统计纪律:十种子起步,报均值加置信区间,单次最优结果等于没有结果。
- 敏感性即边界:对信道模型与移动模型双敏感的结论,只配带条件发布。
- 校准才可信:仿真器是某片环境的方言翻译,换环境要重新校准。
- 预留落差:现场比仿真差一档是规律,仿真做到九十九才承诺九十五。