5.1 图像增强与直方图拉伸
5.1 图像增强与直方图拉伸
本节摘要:传感器的量化动态范围远超显示器与人眼的呈现能力,未处理影像常显得"又暗又闷"。本节讲三种最基本的增强手法——线性拉伸、直方图均衡、假彩色合成,并用一段完整的 NumPy 演算走通从反射率到可视影像的过程;同时划清增强与定量的边界:增强服务视觉判断,定量运算必须回到原始反射率。
先让地物看得见
预处理交付的反射率数据是"忠实"的,但往往不好看:地表反射率大多落在零点几的窄区间,按满量程显示时影像灰暗、层次压缩,人眼很难判读。增强不产生新信息,它把已有的数值区间映射到显示动态范围上,让信息对眼睛"摊开"。这件事必须先做的原因很实际——解译样本的选取、分类结果的人工核查、专题图的制图表达,全依赖一版看得清的显示底图。
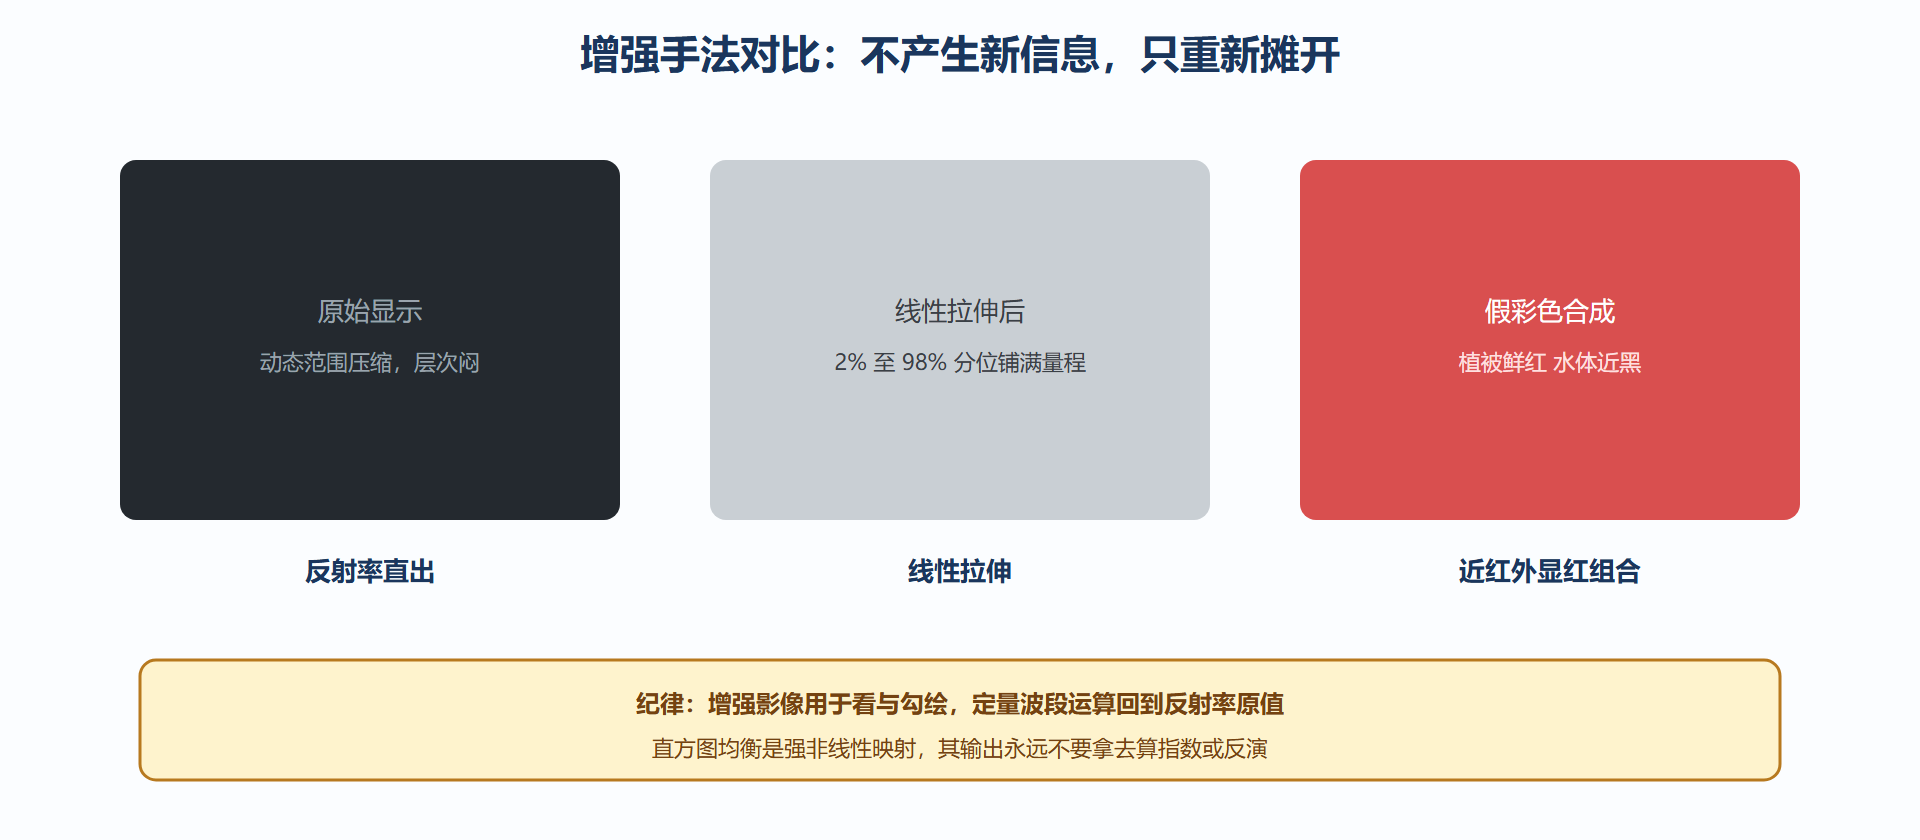
线性拉伸是最常用的手法:取直方图的低分位与高分位(例如百分之二与百分之九十八)作为映射端点,把区间线性扩展到零至二百五十五,舍弃的尾部是噪声与极值。直方图均衡更进一步:按累积分布函数重映射,让每个灰度级占据大致相同的像元数,细节对比被全面拉开,代价是灰度关系被非线性扭动,适合目视、忌讳定量。假彩色合成则利用波段组合的解码能力:近红外显红、红光显绿、绿光显蓝的标准组合下,植被呈鲜红色(因为近红外反射高),水体近黑,城市青灰——植被边界与长势差异一眼可辨,这是目视解译几十年的看家配色。当三显色仍不够用时,再叠加主成分变换把多波段信息压缩到前几个分量里显示。
# 图像增强演算:从反射率到可视影像(NumPy 实现) import numpy as np np.random.seed(7) ref = np.random.beta(2, 8, (200, 300)) * 0.45 # 模拟某波段地表反射率 ref[30:60, 40:120] = 0.02 # 一片"水体" ref[120:160, 180:280] = 0.38 # 一片"稠密植被" def linear_stretch(band, low_pct=2, high_pct=98): lo, hi = np.percentile(band, [low_pct, high_pct]) stretched = (band - lo) / (hi - lo) return np.clip(stretched, 0, 1) vis = (linear_stretch(ref) * 255).astype(np.uint8) print("原始反射率 均值 {:.3f} 区间 {:.3f} 至 {:.3f}".format(ref.mean(), ref.min(), ref.max())) print("拉伸后灰度 均值 {:.1f} 区间 {}".format(vis.mean(), (vis.min(), vis.max()))) w = vis[30:60, 40:120].mean(); v = vis[120:160, 180:280].mean() print("水体均灰 {:.0f},植被均灰 {:.0f} —— 对比从 {} 倍拉开到 {} 倍".format( w, v, 0.38/0.02, v/w)) # 反射率差异 19 倍,经拉伸与显示映射后灰度对比更直观 # 注意:vis 只能用于显示与解译,定量计算请继续用 ref
图 5-1:同一景影像的三种呈现
波段运算:从显示到测量的第一座桥
增强的下一步自然衔接波段运算——把几个波段的反射率按公式合成一个新"波段",它既是产生新显示通道的手段(如冰雪指数、火烧迹地指数),也是第 6 章参数反演的起点。演算只涉及数组四则,但工程纪律重要:参与运算的必须是反射率原值,除法要防零(分母加极小量),结果要按理论值域裁剪。下面用 NDVI 与水体指数做一次完整演算,顺带体会"指数对噪音的免疫力"差异:
# 波段运算:NDVI 与水体指数的稳健性对比 red = np.array([0.05, 0.10, 0.20, 0.06]) nir = np.array([0.50, 0.28, 0.28, 0.02]) # 密植、疏草、裸土、清水 mndwi = (np.array([0.09]) - np.array([0.03])) / (np.array([0.09]) + np.array([0.03]) + 1e-9) ndvi = (nir - red) / (nir + red + 1e-9) labels = ["密植农田", "稀疏草地", "干燥裸土", "清水"] for lb, v in zip(labels, ndvi): print(f"{lb} NDVI = {v:+.2f}") # 全部落在 -1 至 +1,水的极负值与植被的高值分野清晰; # 分母加 1e-9 防止除零,是波段运算的肌肉记忆
两个实用提醒。其一,指数各有擅长与失效域:NDVI 对土壤背景与大气敏感、在高覆盖区饱和,业务上常换成抗土壤背景的 EVI 或红边指数,选择依据回到第 2 章的光谱机理。其二,所有指数结果都该带着"原始值域"做合理性检查——NDVI 算出负一点五一定意味着输入不是反射率(多半误用了 DN 值或增强后影像),这种自检比任何算法调优都便宜。
主成分显示与大批量增强的工程化
两个常被一起问到的实操话题放在一起说。主成分显示:多波段影像直接选三个波段显示会浪费其余波段的信息,主成分变换把全部波段的方差集中到前几个分量上——第一分量通常是"亮度"(地物明暗),第二分量常对应"绿度"对比(植被与背景的反差)。用第一、二、三分量配成假彩色,往往比任何三波段组合都更"全面",且压缩了噪声;代价是分量失去了直接的物理含义,出图时要注明"主成分合成,非真实彩色"。大批量增强的参数管理:业务项目动辄几百景影像,逐景手工调拉伸既慢又不一致。工程做法是制定全局拉伸规则(如统一按百分之二至九十八分位、统一裁剪域),把参数写进处理脚本与日志;展示类产品允许逐景微调,但定量流程严格走固定规则——一致性在这里再次比单景的最优更值钱。
排错手记:显示与定量的边界事故
事故一:NDVI 图出现负零点五的"沙漠绿洲"。 排查发现有人把直方图均衡后的影像当输入算的指数——增强的非线性映射彻底改写了比值。处置:回到反射率原值重算,并把"定量输入禁用增强产物"写进项目规范。事故二:同一项目两批影像色调对不上。 两名成员用了不同的拉伸分位数,拼接图上成色断层。处置:统一拉伸规则重出,今后规则随脚本走、不随人走。事故三:指数值域莫名越界。 输入被误当成反射率的 DN 值,除法后数值飘出理论区间。处置:所有指数计算前加值域断言,越界即报警——一行检查代码,拦下整批废品。三起事故的共同教训:显示与定量的边界要用流程锁死,而不是靠自觉。
要点回顾:增强不产生新信息,只把数值区间摊开给眼睛,线性拉伸按分位铺满量程、均衡化拉开细节、假彩色解码波段语义;波段运算是从显示走向测量的桥梁,反射率原值、防零分母、值域自检是三条纪律;主成分合成信息全面但无物理色彩,出图要注明;大批量项目用统一拉伸规则保一致性;增强产物与定量产物分开管理,误用增强影像做定量是最常见的静默错误。下一节把"每个像元孤立的光谱"升级为"邻域与目标的特征"。
附:增强速记卡与练习
速记四条。一、拉伸选分位:两端各留百分之二给噪声,宁可舍弃极值也要把主体层次铺满。二、假彩色先近红:看植被先试近红外显红组合,这是解译的第一眼配色。三、均衡不上桌:直方图均衡的结果只留在显示器上,绝不进入任何公式。四、原值保险箱:所有定量运算的输入从"反射率保险箱"取,增强影像放"展示柜",两把钥匙两个人管。练习建议:找一景免费数据,分别用直方图均衡、线性拉伸、主成分合成出三张图,同一区域同一配色比较——亲眼看过三者的差异,比读三遍文档都记得牢。
案例复盘:一次虚惊的报告
某项目提交的旱情旬报里,有一期 NDVI 区域均值突然下坠,值班同事按"真实旱情"起草了预警。复核发现:当期影像换了处理链版本,拉伸参数不同导致指数计算的输入口径漂移——虚惊一场,但流程漏洞暴露了。改进措施有三:定量输入统一从反射率产品库取数,展示影像永不入库;指数计算前加值域与分布断言,均值漂移超阈值自动复核;旬报模板加"数据口径"字段,版本变化必须显式标注。这则案例值得讲给每位新人:增强与定量的边界事故,多数不是知识问题,而是"哪条数据能进公式"的纪律问题。把纪律做进脚本与模板,人才可以从重复的警惕中解放出来,去关注真正的地物变化。
附:配色与出图速记
出图配色三条纪律:一、专题图的色带要服务判读——分类图用高区分度的类别色,连续量用单色渐变并在图例标数值区间;二、永远附图例与单位,"红色是植被还是火点"取决于图例而不是读者的想象;三、打印与投影场景做一次试色——屏幕上鲜艳的配色投影后可能糊成一片。另外记一个显示细节:拉伸参数影响的是视觉对比,不改变像元值本身,但在截图汇报时务必注明所用拉伸,否则别人屏幕上的同一景对不上你的色调,沟通成本陡增。