5.2 特征提取:光谱、纹理与形状
5.2 特征提取:光谱、纹理与形状
本节摘要:单像元光谱只是特征家族里的一员,邻域统计给出纹理、目标轮廓给出形状、空间关系给出上下文。四类特征各有擅长的地物对象:光谱分材质、纹理分结构、形状分对象、上下文分角色。本节建立特征体系并动手演算最常用的灰度共生矩阵纹理与主成分变换。
特征是解译的原料
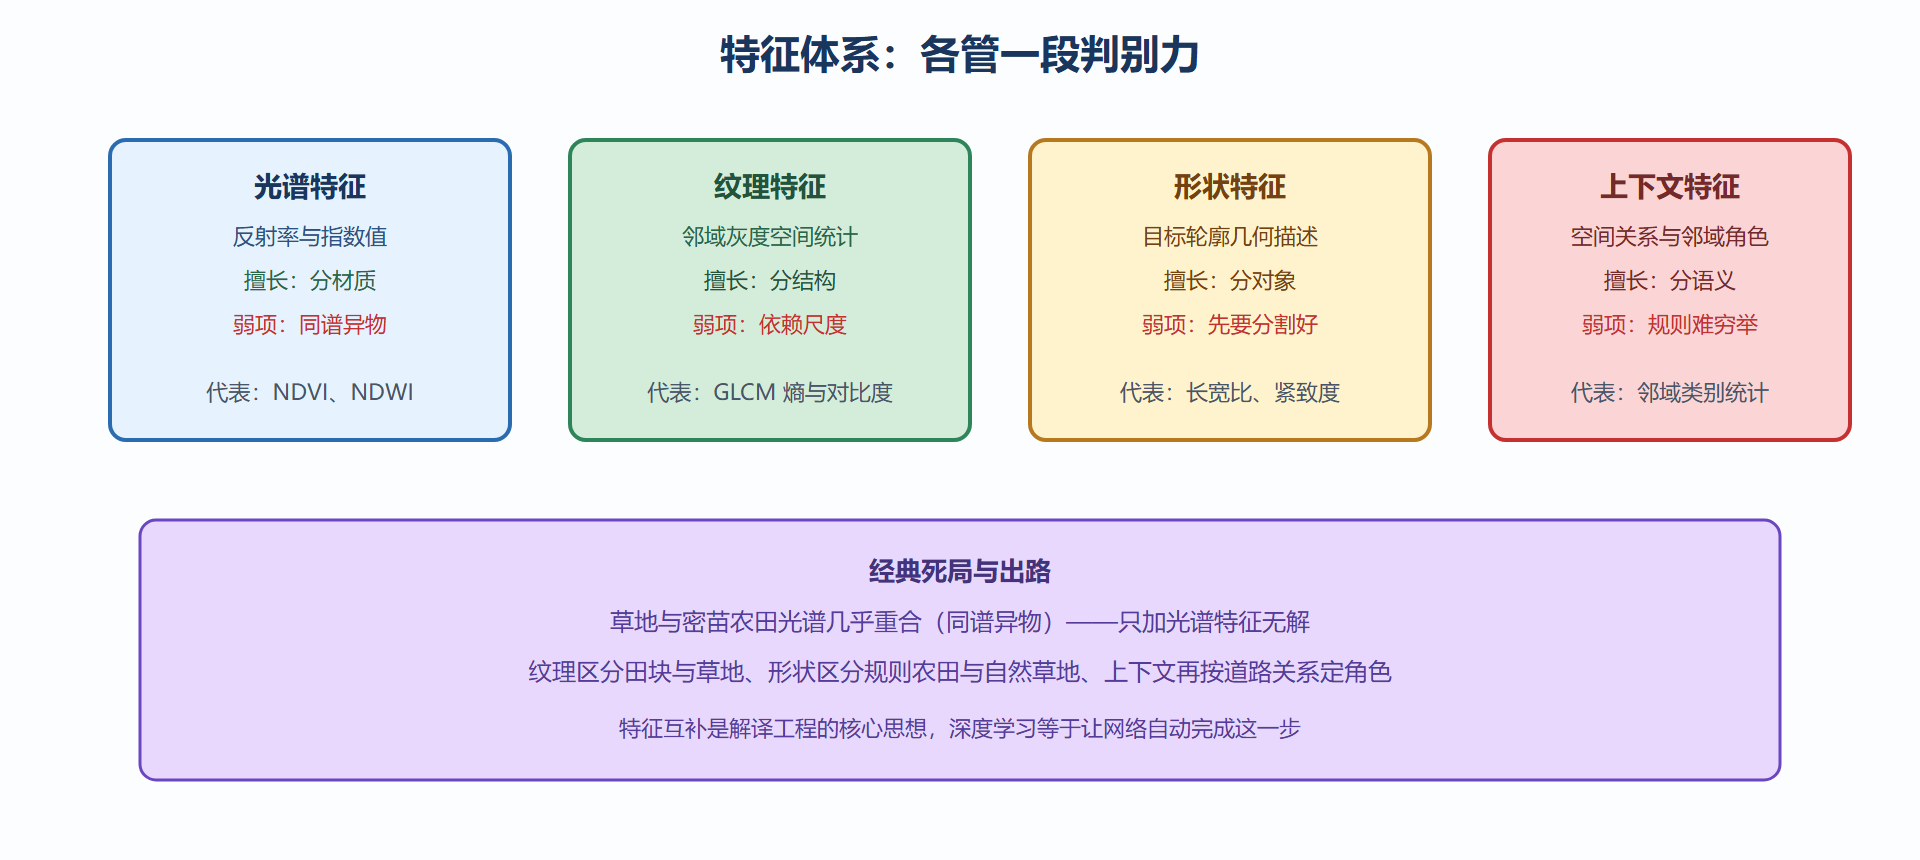
分类算法不直接看影像,它看特征——特征的信息量决定分类上限,算法只是逼近这个上限的手段。这套认知决定了排错顺序:分类结果不好,先查特征是否可分,再查算法与参数,最后才怀疑模型本身。四类特征的分工值得背下。光谱特征来自像元本身的反射值或指数,擅长区分材质(植被、水体、沥青);纹理特征来自邻域灰度的空间统计,擅长区分结构(密林与疏林、城区与农田),因为材质相近而结构不同的地物在光谱上重叠、在纹理上分野;形状特征来自把像元聚成目标后的轮廓描述(面积、周长、长宽比、紧致度),是面向对象分类的立身之本;上下文特征来自空间关系(道路旁的矩形建筑多为房屋、河岸的窄长水体是渠),常以规则或缓冲区统计的形式进入解译。
图 5-2:四类特征与擅长的判别对象
动手演算:纹理与主成分
纹理的教科书方法是灰度共生矩阵:统计影像里相隔指定距离、指定方向的像元灰度对共现频率,再从矩阵算对比度、熵、同质性等指标。演算感受一下"结构差异如何变成数值差异":
# GLCM 纹理演算:均匀草地 vs 城区街区(简化到 3 级灰度) import numpy as np grass = np.array([[1,1,1,2],[1,1,1,1],[1,1,2,1],[2,1,1,1]]) # 均匀少变 urban = np.array([[0,2,0,2],[2,0,2,0],[0,2,0,2],[2,0,2,0]]) # 棋盘剧变 def glcm_contrast(img): g = img - img.min() n = g.max() + 1 P = np.zeros((n, n)) for i in range(g.shape[0]): for j in range(g.shape[1]-1): P[g[i,j], g[i,j+1]] += 1 # 水平方向相邻灰度对 P = P / P.sum() contrast = sum((a-b)**2 * P[a,b] for a in range(n) for b in range(n)) return contrast print(f"草地对比度 {glcm_contrast(grass):.2f} 城区对比度 {glcm_contrast(urban):.2f}") # 同样的灰度均值,结构差异在对比度上拉开数倍——这就是纹理的判别力
多波段数据的另一个常规动作是主成分变换(PCA):把相关波段旋转到不相关的主成分轴上,前两三个分量集中绝大部分方差。它的两个经典用途都源于此——压缩(前几分量代替全部波段参与后续处理)与去相关后的增强显示(第一主成分集中亮度、第二主成分常捕获"绿度"类对比)。PCA 还有一个诊断用途:检查主成分与地物的对应关系,若某分量与水体边界高度相关,说明该分量可当"水体检索通道"用。
# PCA 演算:四波段数据压缩到两个主成分(协方差特征分解) X = np.random.RandomState(3).randn(500, 4) * np.array([0.02, 0.05, 0.04, 0.03]) X[:, 1] += 0.5 * X[:, 0] # 人为制造波段间相关 C = np.cov(X, rowvar=False) w, V = np.linalg.eigh(C) ratio = w[::-1] / w.sum() print("各主成分方差占比:", np.round(ratio, 3)) # 前两个主成分通常吃掉九成以上方差——压缩的合法性一目了然
面向对象:把像元聚成目标再提特征
高分辨率影像上还有一个绕不开的概念——面向对象分析。米级以下分辨率里,一棵树占几十个像元、一栋建筑占上百像元,逐像元分类会产生椒盐斑点,且浪费了目标级的几何信息。面向对象的流程分两步:先用分割算法(分形网络演化类方法最常用)把影像切成同质对象,再对对象提取特征——均值光谱、纹理、加上面积、周长、长宽比、紧致度等形状量。它的红利与陷阱同样明显:红利是分类结果直接是"图斑",与业务地块天然对接,形状特征把光谱分不开的对象分开(细长的道路与块状的裸地光谱相近、形状迥异);陷阱是分割尺度成了第一超参数——尺度选大了不同地物粘连、选碎了对象支离,正规项目都要做尺度敏感性试验,把分割参数连同依据写进技术文档。面向对象与深度学习并非对立:深度分割网络学的也是"对象级"语义,两者在业务里常按数据分辨率与样本量分工。
常见问答
问:纹理窗口取多大? 没有万能值,由地物尺度决定:纹理窗口应约为目标纹理基元的两到三倍——数树冠的纹理窗口取树冠直径的两三倍,看城区肌理则要覆盖一个街区。做法是取几个候选窗口各跑一遍分类,看精度曲线的峰值在哪。
问:PCA 之后该用前几个主成分? 看方差贡献的"拐点":前几个分量吃掉绝大部分方差、后面的突然变平,就在拐点处截断。多数四到八波段的数据,前三分量足够;高光谱则可能需要十几个。别忘了检查后面的分量——噪声或独特地物(如水体)有时藏在低分量里,丢之前扫一眼。
问:特征是不是越多越好? 相反。特征维数上去了,样本需求跟着涨(维数灾难),冗余特征还稀释判别力。规范做法是先按机理选特征、再用重要性排序或逐步筛选修剪,最终特征集要小而准——每个特征都能说出"为什么留它"。
要点回顾:特征决定分类上限,排错先查特征再查算法;光谱分材质、纹理分结构、形状分对象、上下文分语义,"同谱异物"死局靠特征互补破解;GLCM 把结构差异变成数值差异,窗口尺度是纹理的第一超参数;PCA 压缩方差、诊断通道,是解读多波段数据的常备工具;面向对象把像元聚成目标,分割尺度要经敏感性试验并与技术文档一起交付。下一节带着这些特征进分类器——监督与非监督两条路线。
附:特征工程速记卡
速记四条。一、先机理后数据:每个入选特征都要能讲出物理来路,讲不出的特征宁可不要——它大概率在拟合噪声。二、纹理配尺度:窗口与目标基元的比例两到三倍起,尺度试验的结果进文档。三、形状先分割:面向对象的成败在分割尺度,敏感性试验是必做功课。四、特征集要瘦身:重要性排序加相关去冗余,特征数量压到样本量能支撑的范围内。一个实用的组合起点送给新手:光谱(两三个关键指数)加纹理(一两个 GLCM 量)加形状(紧致度与长宽比),七 八个特征的起步集,多数中等任务能站稳;之后按精度曲线决定增删,而不是靠感觉堆料。
延伸:特征重要性的一次实验课
给一个可复现的小实验:用同一套样本跑随机森林,先只用光谱特征训练,记录总体精度;再逐组加入纹理、形状、时序特征,记录每次的增量。多数实验会呈现同一个模式:时序特征往往带来最大的一跳,纹理其次,形状在高分辨率数据上才发力。这个实验的教学生montre力极强——它让你亲手看到"特征的判别力有数量级之分",也让你理解为什么近年方法研究的重心从像素光谱转向了时序与上下文。实验之后再把重要性排序打印出来,你会发现有些"理论上应该有用"的特征排名垫底——在你自己的数据上检验教科书,是遥感工程师与教科书读者的分水岭。把这套实验做进项目启动期,特征体系的每一员都是带着证据上岗的。
附:特征与地物的对照速查
给一份"地物到特征"的对照速查,按需取用:建筑物——形状(高紧致度、直边)加 SAR 亮斑加阴影关联;水体——光谱(近红外暗、指数高)加时序(年内稳定)加地形(低洼);道路——细长形状加光谱均质加拓扑连通;果园与密林——纹理(规则格状 versus 随机冠层)加物候(花期突变 versus 平缓);裸露耕地与自然裸地——形状(田块边界)加时序(耕作节律)。对照表的用法是"缺什么补什么":分类图上哪两类混,回表查它们在本行里的区分特征,补进特征集重训——特征工程从此有了查表式的操作路径。
补一个跨源特征的提醒:把不同传感器的特征混进同一向量时,除了辐射口径统一,还要检查特征的"语义等价性"——同样叫"NDVI",不同传感器的波段设置让数值分布各不相同,混用前要么做交叉标定,要么在模型里声明传感器身份。跨源特征工程的一半工作量在等价性论证,另一半才是计算本身;论证部分偷的懒,最终都会以精度无法解释的形式回来。