5.4 深度学习解译与变化检测
5.4 深度学习解译与变化检测
本节摘要:卷积网络把"特征工程"变成了"特征学习",语义分割与目标检测成为高分辨率影像解译的主力;变化检测则在时间维度上做对比,伪变化的控制是成败关键。本节建立网络解译的工作图像,给出样本与迁移学习的实战策略,并用演算说明阈值化变化检测的误差结构。
卷积核学会了看图
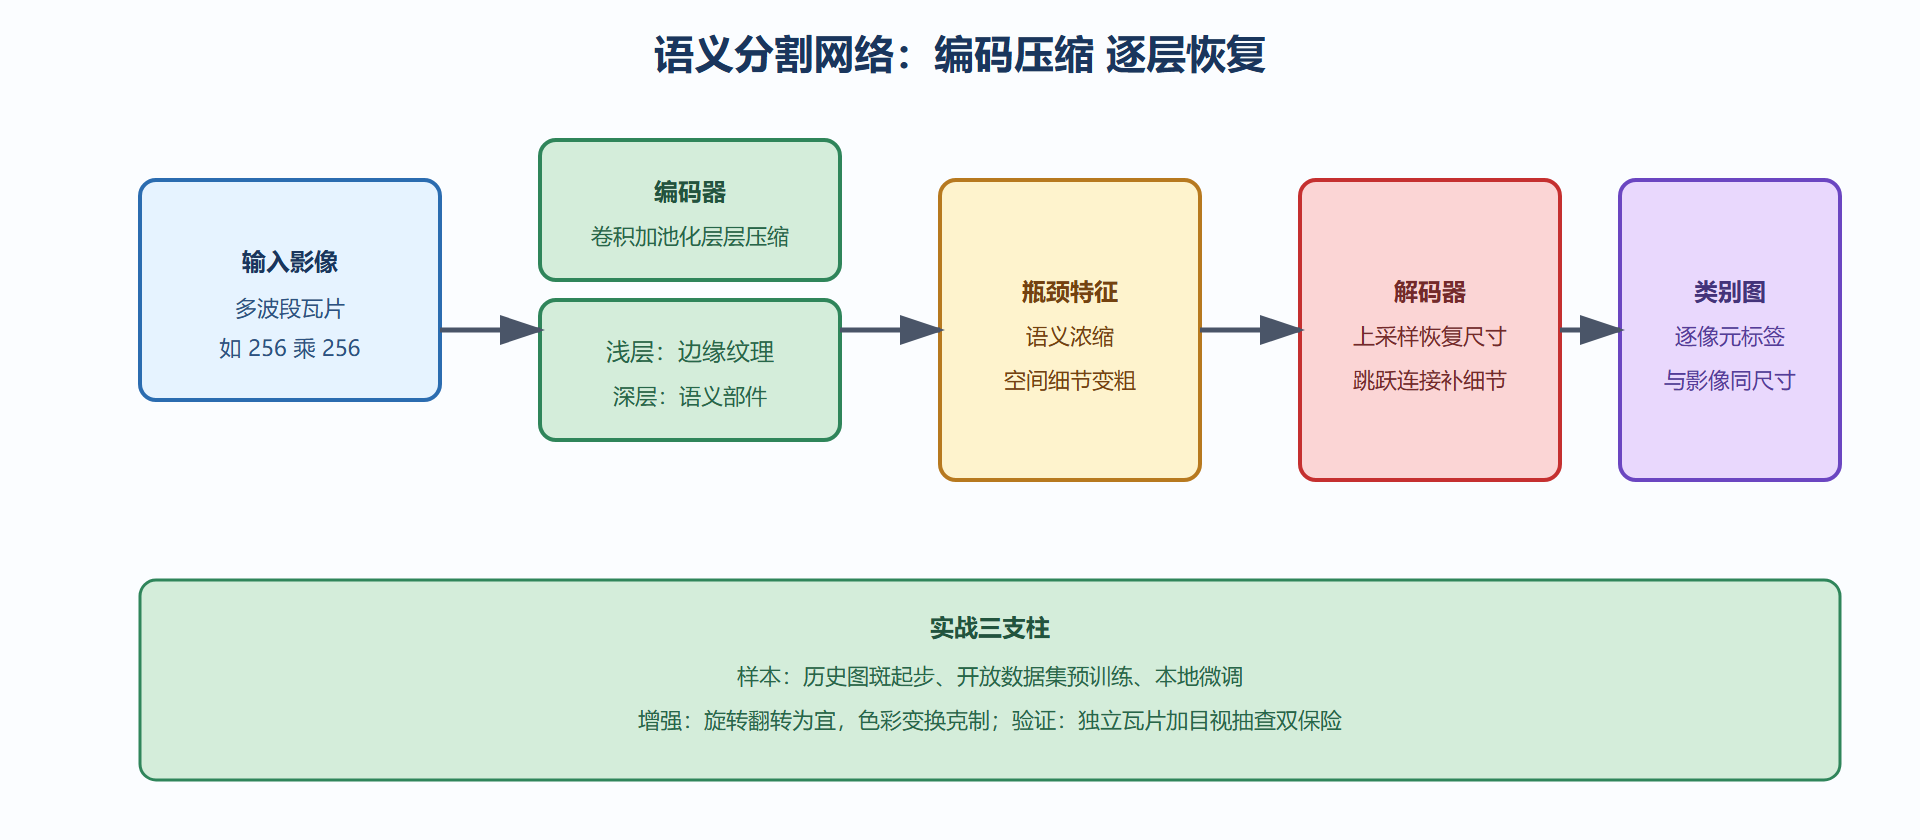
传统分类器把每个像元(或对象)当独立样本,邻域信息要靠人工纹理特征喂进去;卷积网络直接在影像上滑窗学习——浅层卷积核响应边缘与纹理,深层组合出屋角、车身、机翼这类语义部件,感受野层层扩大,空间上下文被自动编码进判别。对应到遥感任务有两种基本形态:语义分割给每个像元一个类别标签,输出与影像同尺寸的类别图,土地利用制图、不透水面提取用这条路;目标检测框出目标实例(飞机、船只、油罐),适合稀疏离散目标的清点与监视。高分辨率影像上,深度学习的增益最明显——建筑阴影、树冠遮挡、复杂纹理这些传统方法的死局,网络靠大数据量样本可以学出来;中分辨率像元粗、样本贵的场景,传统方法的性价比仍然能打。
实战策略比模型选型更决定成败。样本从哪来:历史专题图与目视勾绘是启动样本,开放数据集(建筑、水体、道路等通用类别)可做预训练底料;迁移学习是默认动作:先在通用数据集上预训练,再用本地少量样本微调,几百张标注瓦片常常就能微调出业务可用的模型;数据增强要贴地气:旋转、翻转、亮度抖动通用,但把城市影像做夸张色彩变换再喂给模型,等于教它忽视光谱——遥感的判别根基还在物理量上,增强力度要克制。
图 5-4:从卷积到分割输出的工作图像
变化检测:在时间轴上找答案
变化检测回答"哪里变了、变了多少、何时变的",最基础的形态是两期影像差值加阈值:
# 两期 NDVI 差值变化检测的误差结构演算 import numpy as np rng = np.random.RandomState(5) ndvi_t1 = np.clip(rng.normal(0.55, 0.08, 100000), 0, 1) # 前一期植被区 ndvi_t2 = ndvi_t1.copy() changed = rng.choice(100000, 800, replace=False) ndvi_t2[changed] -= rng.uniform(0.25, 0.45, 800) # 真实变化:植被锐减 ndvi_t2 += rng.normal(0, 0.05, 100000) # 两期残余噪声(未除净的大气等) delta = ndvi_t2 - ndvi_t1 thr = -0.15 # 判变阈值 flag = delta < thr precision = (flag & (np.isin(np.arange(100000), changed)).reshape(-1)).sum() / flag.sum() recall = (delta[changed] < thr).mean() print(f"检出真实变化 {recall*100:.0f}%,误报占告警 { (1-precision)*100:.0f}%") # 噪声标准差 0.05 时阈值取 -0.15(约 3 倍噪声)尚可控; # 若预处理不彻底、噪声升到 0.10,同样阈值误报将翻数倍 # 结论:变化检测的精度上限是第4章配准与大气校正的质量
演算的工程含义有三层。其一,阈值不是拍脑袋:按噪声标准差的三倍起步、再用目视样本校准,是可辩护的取法。其二,伪变化三大来源——配准错位(边界处成排误报)、物候错位(两期日期差两周,作物本身变了)、大气残余(整体偏亮偏暗);对应防线分别是第 4 章的配准预算、同期相位的选取、严格大气校正。其三,面积统计前要做最小图斑过滤:孤立的单像元"变化"多数是噪声,按业务图斑最小面积做连通域过滤,告警量降下来、可信度升上去。深度变化检测(孪生网络、时序模型)在复杂场景下更强,但伪变化控制的功课一模一样——模型换了一代,地基没换。
常见问答
问:标注样本到底要多少才够? 与类别复杂度、目标尺寸、模型规模都相关,没有定数。经验区间:单一地物类别(建筑、水体)微调一个成熟网络,数百张瓦片常可起步;多类别精细地物要上千。判断"够不够"的实操标准是学习曲线——加样本到验证精度趋平,就是当前配置的够了。
问:直接拿开源预训练模型用行不行? 当起点行,当终点不行。通用模型多在自然图像上预训练,遥感的多波段、俯视几何、大尺度场景都不同;务必用本地样本微调,并把微调前后的验证对比记入文档——这是模型验收的必答题。
问:变化检测用深度学习一定能超过阈值法吗? 不一定。两期质量好、变化类型简单时,阈值法快、透明、可审计,往往够用;深度方法的主场是复杂场景(多类变化、季节交叉、影像质量参差)。选型逻辑回到老问题:任务的误差预算与可解释性要求各是多少。
要点回顾:卷积网络把特征工程变成特征学习,语义分割管逐像元制图、目标检测管实例清点,高分辨率场景收益最大;样本与迁移学习决定落地速度,数据增强要贴地气、忌讳破坏光谱语义,学习曲线是"样本够不够"的裁判;变化检测的阈值按噪声倍数起步,伪变化三大来源是配准、物候、大气,防线全在前置章节;最小图斑过滤是把告警变成业务信号的最后一步;阈值法与深度方法按误差预算与可解释性需求取舍,不做无谓的炫技。下一章把"类别"升级为"参数"——进入定量反演。
附:深度解译落地速记卡
落地速记五条。一、瓦片切法有讲究:按地物边界附近切会增加边界像元的标注噪声(切在过渡带的瓦片让模型学混标签),训练瓦片避开主要地物边界、推理时用重叠切片加融合,是工程上的标准细节。二、类别不均衡要处理:小目标类加权重或过采样,别让"少数类"淹没在背景里。三、推理后处理不能省:条件随机场或简单平滑能把锯齿边界收拾干净,最小图斑过滤照旧。四、模型监控要上线:输入分布漂移(新传感器、新季节)会让线上精度悄悄滑坡,定期抽检加阈值告警。五、失败样本建库:模型错判的案例是下一次迭代的黄金样本,归档习惯决定模型迭代速度。五条都不炫技,但每一条都是"演示能跑"与"业务能扛"之间的那道墙。
延伸:小样本场景的务实路线
不是每个项目都有钱标上千张瓦片,小样本场景有一条务实的组合路线:先选类别体系里"边界清晰、形态稳定"的两三个类起步(建筑、水体这类),用开源预训练模型微调,把这几个类的精度做扎实;其余复杂类别沿用传统分类或人工解译,两种结果按图幅拼接;随着业务运行积累的修正样本越来越多,再逐步扩大深度模型覆盖的类别清单。这条"由点到面"的路线好处有三:初期投入小、见效快;每个上线的类都有独立验证报告,可信度透明;样本库随业务自然生长,第二年、第三年的模型迭代有了燃料。技术选型不必一步到位,路线图比单点先进更决定项目成败——这是小团队做深度学习落地最有价值的一句心法。
附:深度项目验收清单
深度学习解译项目的验收清单五条:一、样本报告——训练、验证、测试三集的来源、数量、时空分布是否披露;二、基线对比——与传统方法或上一版模型的对照是否在同一验证集上进行;三、失败案例——模型已知失效场景有没有列出并给出处置建议;四、泛化证据——在非训练区域或新一期数据上的表现是否单独报告;五、复现条件——环境、随机种子、权重与配置是否足以让第三方复现。五条齐全的模型才算"可交付",缺任何一条,都应在验收意见里写为风险项。这清单同样适用于你评估外部的 AI 解译产品——销售话术挡不住这五问。
最后补一条推理服务的工程提醒:模型上线后,输入瓦片的预处理必须与训练时完全一致——波段顺序、缩放方式、拉伸口径任何一处不一致,精度都会无声滑坡。工程做法是把预处理逻辑封装成训练与推理共用的同一份代码,从根上消除两套实现的漂移;上线后再配一个输入分布监控,训练与线上分布的偏移超阈值即告警。深度学习项目的线上事故,多数不在模型,而在这些不起眼的口径缝隙里。