5.3 图像分类:监督与非监督
5.3 图像分类:监督与非监督
本节摘要:非监督分类让算法自己从数据里找簇,适合无样本时的快速摸底;监督分类用标注样本训练判别规则,精度上限由样本决定。本节完整演算 K 均值与高斯最大似然两个经典算法,讲清样本库建设纪律,并用混淆矩阵把"精度"这个词拆成可核查的指标。
让机器学会划界
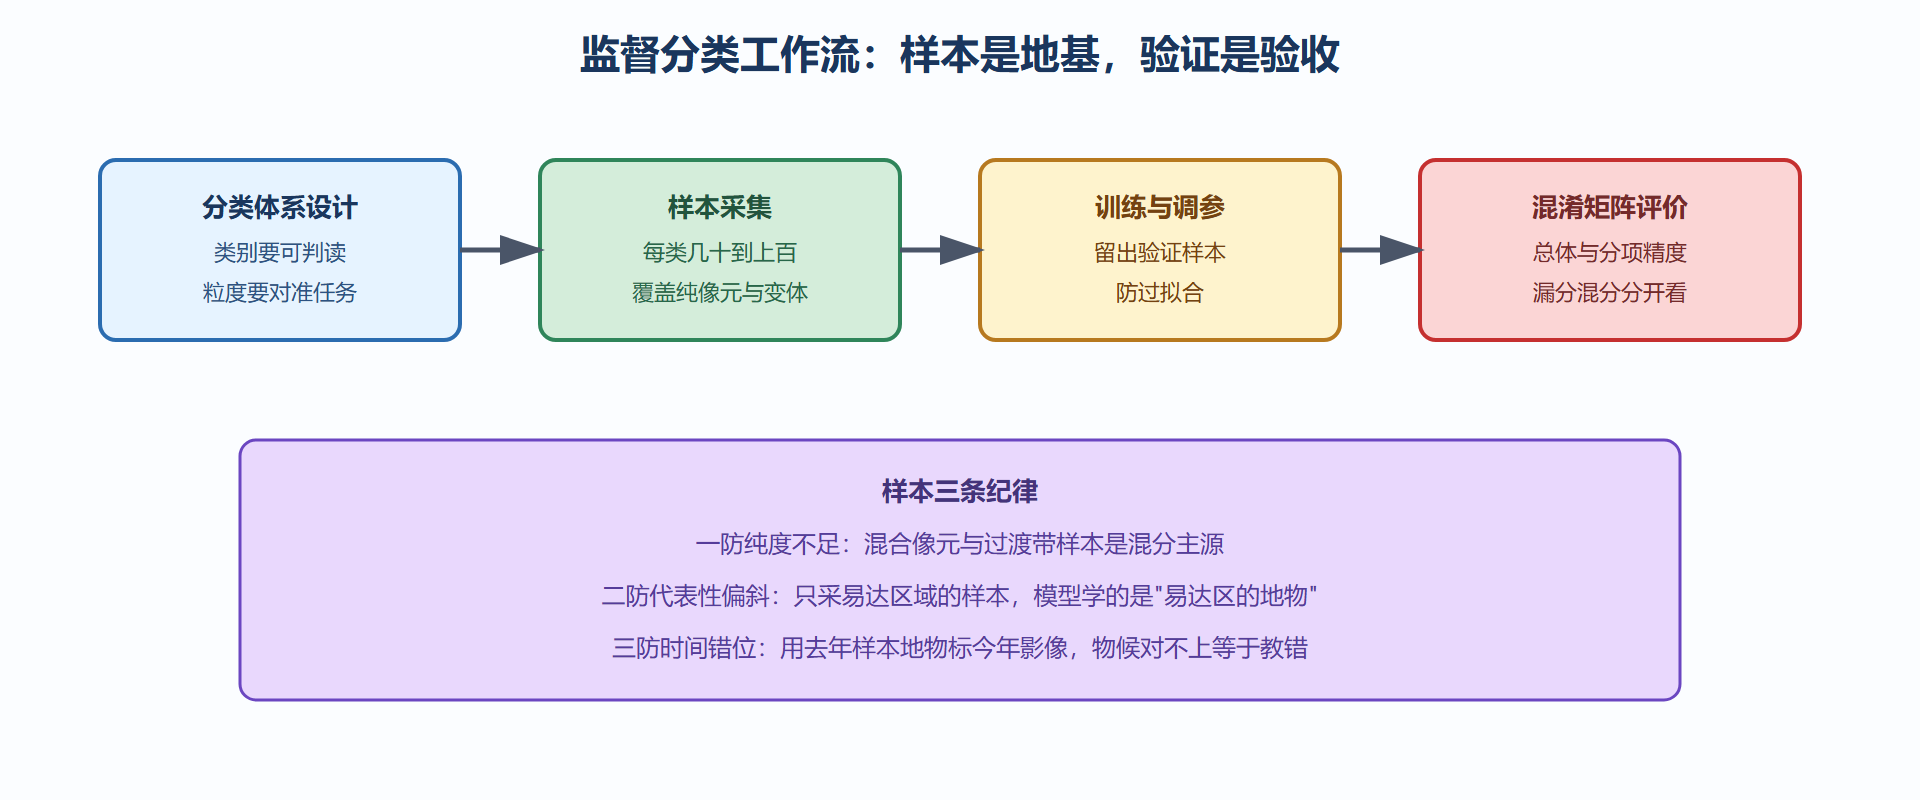
带着特征回到分类问题,路线分两条。非监督分类不使用任何人工标注,算法按特征相似性自动聚簇——K 均值是代表:先随机撒中心,再把像元就近归属、按簇重算中心,迭代到收敛。它的价值在"快":拿到新区域的第一天,跑一版 K 均值就能摸清数据自然分几类、各类大致长什么样,为后续样本设计提供草图;弱点是簇没有语义(分出来是簇一簇二,不是农田林地),且对初值与簇数敏感。监督分类走样本驱动的路线:人工标注每类的训练样本,算法学习"特征到类别"的映射规则,最大似然法是半个多世纪以来的教科书基准——它假设每类特征服从高斯分布,按类别的均值与协方差计算每个像元属于各类的概率,取最大者。监督路线的精度上限由样本决定:样本不纯、不全、过旧,算法再好也白搭。
# K 均值 + 最大似然迷你实现(一维特征演示原理) import numpy as np np.random.seed(11) feat = np.concatenate([np.random.normal(0.05, 0.02, 200), # 水体 NDVI np.random.normal(0.45, 0.10, 300)]) # 植被 NDVI def kmeans1d(x, k=2, iters=20): c = np.percentile(x, [100/(k+1)*(i+1) for i in range(k)]) for _ in range(iters): lab = np.argmin(np.abs(x[:,None] - c[None,:]), axis=1) c = [x[lab==j].mean() for j in range(k)] return np.array(c), lab centers, lab = kmeans1d(feat) print("K均值簇中心:", np.round(centers, 3)) for j, c in enumerate(centers): print(f"簇{j} 均值 {c:.3f} 标准差 {feat[lab==j].std():.3f}") def maxlike1d(x, c, lab): logp = [] for j in range(len(c)): mu, sd = c[j], feat[lab==j].std() + 1e-6 logp.append(-0.5*((x-mu)/sd)**2 - np.log(sd)) return np.argmax(logp, axis=0) test = np.array([0.08, 0.30, 0.55]) print("最大似然判属:", maxlike1d(test, centers, lab)) # 新像元按各类分布的似然取最大——比"就近划线"多用了方差信息
图 5-3:监督分类的完整工作流
混淆矩阵:把"精度"拆开看
分类交付的验收材料是混淆矩阵:行为参考类别、列为分类类别,对角线是分对的。从矩阵能读出两种视角的精度——生产者精度(某类真实像元被正确分出的比例,漏分视角)与用户精度(分到某类的像元里真属于该类的比例,混分视角)。两者分工非常实际:做面积统计的用户在意混分(别人家的地算进我类会虚增面积),做变化核查的用户在意漏分(真实变化点被漏掉代价更高)。报告精度还要报抽样方式——用训练样本自评是自欺,必须用独立随机采样的验证集;分层抽样时样本比例偏离真实面积比例,总体精度要按面积加权修正。这些细节是"精度九成"这类口头承诺与可核查验收之间的全部距离。
# 混淆矩阵指标演算 import numpy as np cm = np.array([[420, 15, 5], # 行=参考 水体/植被/裸土 [ 10, 380, 40], [ 0, 25, 200]]) pa = np.diag(cm) / cm.sum(axis=1) # 生产者精度(漏分视角) ua = np.diag(cm) / cm.sum(axis=0) # 用户精度(混分视角) oa = np.diag(cm).sum() / cm.sum() for i, name in enumerate(["水体", "植被", "裸土"]): print(f"{name} 生产者精度 {pa[i]:.2f} 用户精度 {ua[i]:.2f}") print(f"总体精度 {oa:.3f}") # 裸土用户精度偏低:相当多"被判裸土"的像元其实是稀疏植被 # 下一步排错方向:裸土与疏草的光谱重叠,补纹理或时序特征
方法族谱与选型对照
最大似然之外,监督家族还有几员常将,值得认识并知道何时请谁出场。支持向量机在小样本、高维特征上稳健,适合"样本不多、特征不少"的项目;随机森林对特征噪声与量纲不敏感、能输出特征重要性排序,是特征筛选阶段的常用工作马;神经网络擅长复杂非线性边界,但样本需求量大。选型表如下:
| 方法 | 样本需求 | 特征宽容度 | 可解释性 | 典型场合 |
|---|---|---|---|---|
| 最大似然 | 中等 | 假设高斯、怕相关特征 | 高(概率解释) | 波段少、分布规整 |
| 支持向量机 | 小到中 | 较好 | 中 | 高维小样本 |
| 随机森林 | 中 | 很好(量纲无关) | 高(重要性排序) | 多源特征混合 |
| 神经网络 | 大 | 好 | 低 | 大样本复杂场景 |
排错手记:分类结果的四种病
病一:某类精度奇低、样本看起来没错。 先查可分性:把该类与最混类别画散点看重叠区——重叠严重就是特征问题,换特征比换算法有效。病二:训练精度高、验证精度低。 经典过拟合,收缩模型自由度(树深、核参数)或加样本。病三:结果图有椒盐斑点。 逐像元分类的正常副作用,多数业务需要接一步多数滤波或按最小图斑合并。病四:类别边界与实地经验明显不符。 回查样本的时间与空间代表性——样本老化与"路边采样偏差"是两大惯犯。四条病的排查顺序都是"先数据后算法",这与本章开头的话互为印证:算法只逼近上限,上限由数据决定。
要点回顾:K 均值适合无样本摸底、簇无语义需人工归并,最大似然用类分布做概率判别、比距离判别多用方差信息;样本纪律三条——纯度、代表性、时间一致,分类上限由样本决定;方法选型按样本量、特征形态、可解释性需求对号入座,随机森林是多源特征的稳妥默认;混淆矩阵要把漏分与混分分开报告,独立验证集与按面积加权是精度可信的两个前提。下一节看深度学习如何接手复杂场景,以及变化检测如何给分类加上时间轴。
附:分类实施检查单
实施检查单八条,按顺序过。一、分类体系可判读:类别定义要能落到影像特征上,"退化草地"这类现场都认不出的类别先搁置。二、样本先摸底:K 均值跑一版,看自然簇与体系的对应关系。三、样本量按类分:小类多采、大类少采,按面积加权回总体。四、留足验证集:训练验证严格分离,验证集绝不参与任何调参。五、模型先简后繁:先随机森林立基线,再决定要不要上更重的模型。六、看误差看分布:混淆矩阵按类检查,空间上按区域检查。七、后处理守最小图斑:孤立像元合并,图斑面积卡业务下限。八、版本入库:样本、参数、结果三件套同版本归档。八条全过,这份分类图才配叫产品。
案例复盘:样本库的一次年检
某省级作物分类项目连续运行三年,第三年精度不明原因下滑。年检复盘:作物结构调整(某作物面积缩水三成)导致旧样本的类别分布严重偏离现状,加上品种更替让物候窗口整体挪动,模型在用"前年的经验"回答"今年的问题"。整改方案成了后来的标准动作:样本库每年生长季更新一轮,新增当年样方与人工核查点;每类样本标注采集年份,超龄样本衰减使用;模型精度按年出具对照表,跨年不可比处明确标注。这次复盘的教训可以推广到所有时序类业务:模型的保质期比想象中短,样本库是有"货架期"的商品,年检不是流程负担,而是产品还活着的关键证据。
附:类别体系设计三原则
分类体系是项目的地基文档,三条设计原则要守住。一、可判读原则:每个类别必须能指认"在影像上靠什么认出它",指认不出的类别要么合并要么删去。二、可复现原则:类别定义写边界案例的裁决规则(水田旱季算耕地还是湿地),两个解译员按文档能得出一致判断。三、可演进原则:预留"其他"与"待定"类吸收长尾,避免小类拖垮整体精度。体系一旦定稿进入冻结,变更要走版本管理——分类体系的中途变更会让历史产品失去可比性,这是很多多年期项目回过头来最痛的一课。
再补一个关于"精度目标"的提醒:总体精度目标要一次定对,别在项目中期因为"差两个百分点"反复折腾模型。正确的动作是把目标与用途绑定——业务可用线定在八成五,那达到八成六就应交付并进入运营迭代,追求完美精度的边际成本远超其价值。把省下的算力与工时投到样本更新与验证上,长期精度反而更高;这一取舍是成熟团队与新手团队在项目节奏上最显性的分野。