6.2 植被参数反演:从 NDVI 到 LAI
6.2 植被参数反演:从 NDVI 到 LAI
本节摘要:植被参数是定量遥感的主干线:NDVI 以极低成本给出植被活力代理,LAI 把"绿度"升级为辐射与生态模型的接口参数;土壤水分与地表温度沿热红外与微波支线并行。本节走通从指数计算、饱和诊断到经验模型反演 LAI 的完整链条,并交代每一步的适用边界。
从红边到叶片面积
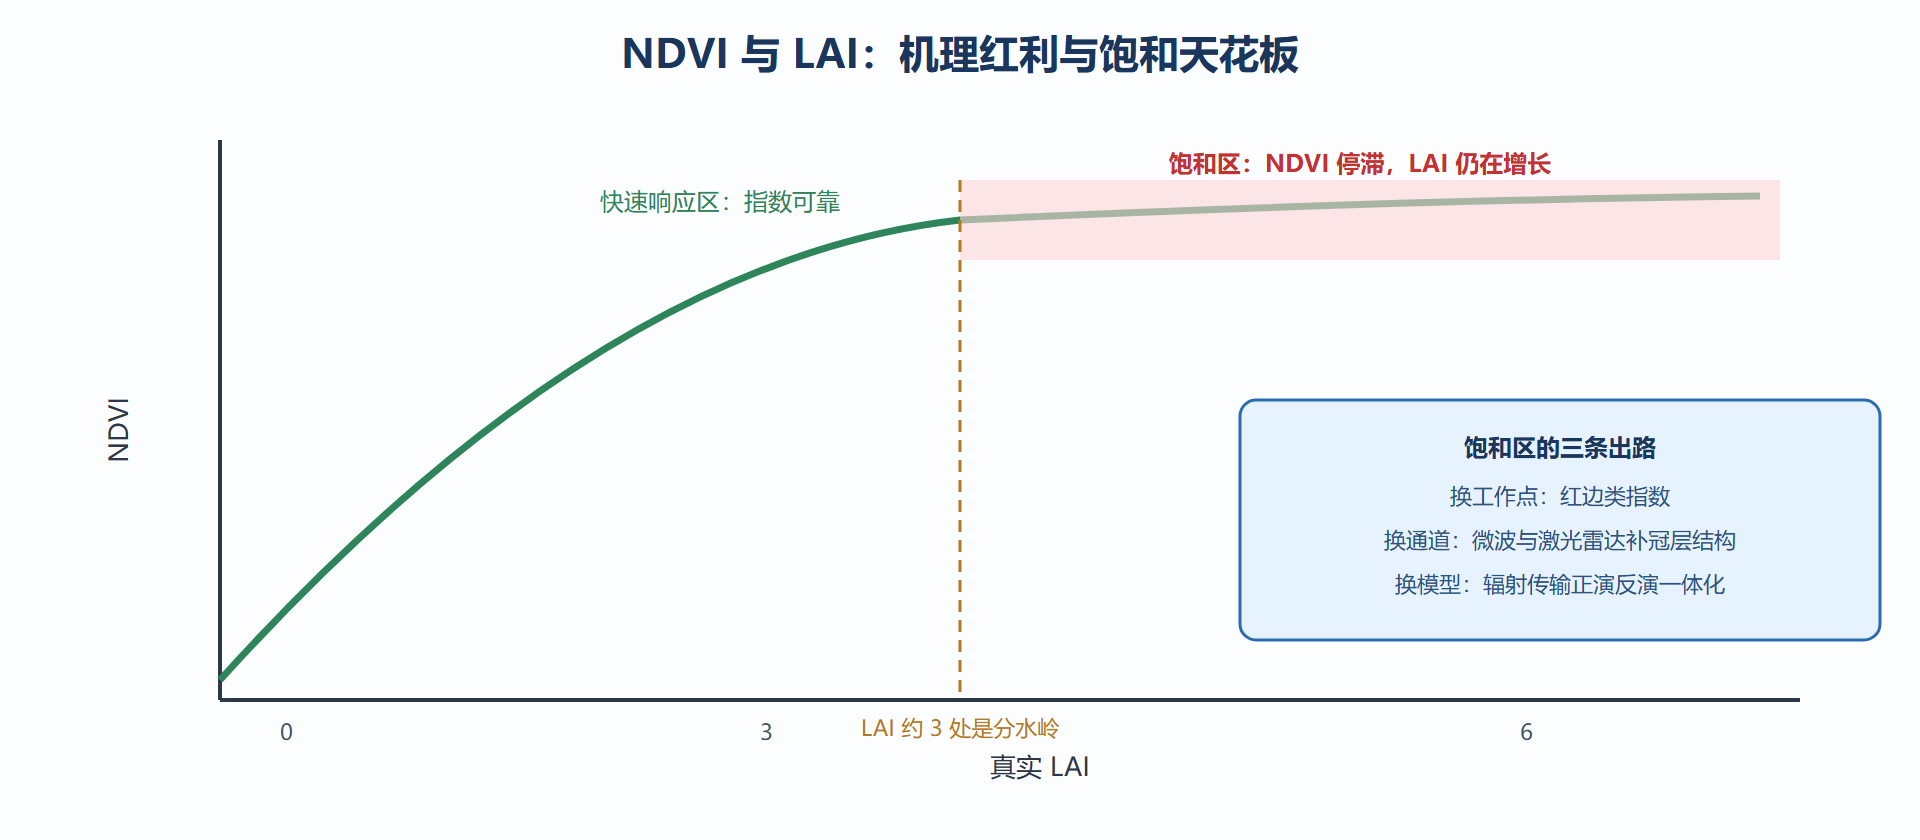
第 2 章埋的红边伏笔在此兑现。NDVI 之所以能当植被活力的代理,机理在叶片光学:健康冠层红光强吸收、近红外强散射,两者对比随冠层加密而拉大。它便宜、稳健、好用,但有两个刻在机理里的天花板。饱和:冠层一旦足够稠密(LAI 约超过三),新增叶片对红光的吸收已近极限、对近红外的散射增量也趋缓,NDVI 停在高位不再响应——茂密森林的四季差异在 NDVI 上几乎抹平,而真实 LAI 仍在变化。土壤背景敏感:稀疏植被区,NDVI 把亮土误读为"部分植被",混合像元里的土壤亮度漂移会伪装成植被变化。改进指数都是对这两个天花板做手术:EVI 引入蓝光修正大气与土壤项、抗饱和更好;红边指数把工作点移到红边斜坡上,饱和起点更高;土壤调节类指数显式扣除土壤背景项。选哪个不是口味问题,是按植被密度与任务精度对号入座。
真正的参数反演从"指数只是代理"这句话开始。LAI(叶面积指数,单位地表对应的单面叶面积总和)是辐射传输与生态过程模型的核心接口:碳水通量、蒸散发、产量估算都要吃这个量。经验统计路线直接架桥——用地面实测的 LAI 与同期影像指数回归出换算式;物理路线则用辐射传输模型(如冠层辐散模型)正向模拟不同 LAI 的光谱,再从光谱反推 LAI。两条路线在 6.3 节正式对账,本节先把经验路线的完整演算走通:
# 植被参数反演演算:从 NDVI 到 LAI(经验模型路线) import numpy as np np.random.seed(21) truth_lai = np.random.uniform(0.3, 5.0, 300) # 假设的地面实测 LAI # 用简化冠层模型生成"影像 NDVI"并加噪声(代替真实数据) ndvi = 0.95 * truth_lai / (truth_lai + 1.2) + 0.05 + np.random.normal(0, 0.03, 300) # 拟合经验关系:LAI = alpha * ln(1/(max(ndvi,sat)-ndvi_sat)) 形式的饱和曲线 # 简化处理:用饱和函数反解 ndvi_sat, k = 0.97, 1.2 est = np.clip(ndvi, None, ndvi_sat - 1e-3) lai_hat = k * (est - 0.05) / (0.95 - (est - 0.05)) rmse = np.sqrt(np.mean((lai_hat - truth_lai)**2)) bias = np.mean(lai_hat - truth_lai) print(f"反演 RMSE = {rmse:.2f} 偏差 = {bias:+.2f}") dense = truth_lai > 3 print(f"稠密冠层(LAI大于3)子集 RMSE = {np.sqrt(np.mean((lai_hat[dense]-truth_lai[dense])**2)):.2f}") # 稠密子集误差明显更大——饱和区反演先天不稳,业务上应叠加红边或雷达数据
图 6-2:NDVI 饱和与反演策略
两条支线:土壤水分与地表温度
植被主线之外,任务日志里最常出现的两条参数支线在此立卡。地表温度反演直接接第 2 章的热红外物理:亮温是黑体假设下的稳定测量,绝对温度要加发射率校正(按地物分类赋发射率是通行做法),城市热岛与旱情指数(如基于温度与植被覆盖的条件指数)都建立在这条支线上。土壤水分反演的主战场在微波:雷达后向散射对介电常数敏感、被动微波亮温与土壤水分直接挂钩,但两者都受植被与地表粗糙度调制——裸土区反演最好,中等植被区需要光学数据提供植被校正,稠密植被区微波也力不从心。两条支线与植被主线合流的地方是旱情监测:土壤水分管"供给侧"、温度与植被指数管"响应侧",多源合流的旱情指数比任何单一参数都可靠,这正是下一章融合的主题。
反演落地前的最后一步是合理性检查,三条便宜而有效的自检:值域检查(LAI 出现负值或超过八、温度出离当地气候包络,先怀疑输入而非算法);空间连续性检查(参数图上出现与地物无关的斑马纹,多半是定标或大气校正的批次差);时序连贯性检查(参数跳变应能对应物候或扰动事件,无法解释的尖刺要回查)。这三检能在模型出问题之前拦下一大半工程事故。
常见问答
问:NDVI 饱和了是不是就完全没用了? 不是,它的适用域依然广阔:中低覆盖植被(多数农田与草地)长势监测、物候期提取、大范围植被变化普查,NDVI 仍是性价比之王。饱和问题只在稠密冠层的精细参数需求上才致命——按覆盖度选指数,别一竿子打死。
问:经验模型每年都要重新率定,太麻烦了,能一劳永逸吗? 不能,也不该。作物品种更替、种植制度调整、传感器的更替都会让历史关系漂移;每年用新的地面样方复核率定,本身就是任务日志的例行条款。谁承诺"一个模型用十年",谁就该被请去重读 6.3 节的外推陷阱。
问:土壤水分反演为什么在植被茂密区不可靠? 微波信号对水分的敏感性被冠层"遮住"了:浓密植被自身的散射与吸收盖过土壤信号,反演的其实更多是植被特性。这就是为什么全球土壤水分产品都标注有效覆盖度限制,业务上常与降水、温度数据组成旱情组合拳,而不是单打独斗。
要点回顾:NDVI 的机理红利与天花板同源——红边对比给了它灵敏度,也给它埋了饱和与土壤背景两个坑,改进指数按植被密度选用;LAI 反演的经验路线一行回归就能起步,稠密冠层区误差放大要有预案,出路是红边、雷达与物理模型;地表温度与土壤水分两条支线的物理入口分别是发射率校正与介电常数,旱情监测靠多源合流;经验模型的年度率定是例行纪律而非额外负担;值域、空间、时序三检是最便宜的质量闸门。下一节把三条技术路线放到一张账本上对账。
附:植被反演速记卡
速记四条。一、指数按覆盖度选:稀疏用抗土壤背景类,稠密用红边类或雷达补充,NDVI 通吃但两头都不精。二、饱和有分水岭:LAI 约三点以上指数钝化,稠密区的估算要标注低可信或换通道。三、时序比单期强:物候轨迹对作物类与长势级的判别力远超任何单期快照。四、三检是底线:值域、空间连续、时序连贯,任何一检出问题先停下排查再谈精度。另附一个行业观察:植被参数反演是任务链里"免费数据吃到大蛋糕"的典型——中分辨率免费时序加少量地面样方,就能支撑县域级别的长势与产量服务,这也是新团队练手的最佳首战。
延伸:从指数到模型的进阶路线
给植被方向的读者一条进阶路线:第一阶段用免费时序数据把指数类产品做熟——物候提取、基线监测、异常检测,建立"数据-物候-业务"的手感;第二阶段引入地面样方,做一个自己区域的 LAI 经验模型,完整经历"采样-率定-验证"的闭环,重点体会样本量与代表性怎么影响精度;第三阶段上手冠层辐射传输模型的查表反演,用模拟数据理解视角、叶倾角分布这些"此前看不见的变量"如何影响信号;第四阶段把三段能力组装成业务链——时序指数做快速筛查、模型反演做重点区域精算、样方网络做年度校准。走完四段,你在这个方向就有了从"会用产品"到"能造产品"的完整履历,这条履历在任何生态、农业、碳汇团队都硬通货。
附:物候窗口速查
植被任务按物候窗口排兵:越冬返青期——越冬作物与杂草的分离窗口,识别冬小麦的关键期;快速生长期——长势监测的黄金窗口,指数对水肥响应最敏感;峰值封垄期——面积与生物量估算的稳定窗口,但也是 NDVI 饱和窗口;成熟收获期——收获窗口的短促变化是产量与收割进度信号;休眠期——土地整理与设施变化的暴露窗口,植被屏障消失后地物最"透明"。把任务目标对到窗口上,是植被数据方案的第一笔:要什么信息,就在哪个窗口花钱买数据,其余窗口用免费数据垫底。