6.3 反演方法对比:物理、统计与机器学习
6.3 反演方法对比:物理、统计与机器学习
本节摘要:同一条反演任务有三条技术路线:经验统计便宜直接、物理模型严谨可外推、机器学习灵活能吃多源数据。本节把三条路线放到同一本账上——成本结构、可解释性、外推能力、样本依赖——并给出按任务条件选线的决策表,最后用一段实验演算演示三者的典型行为差异。
三条路线各有各的账
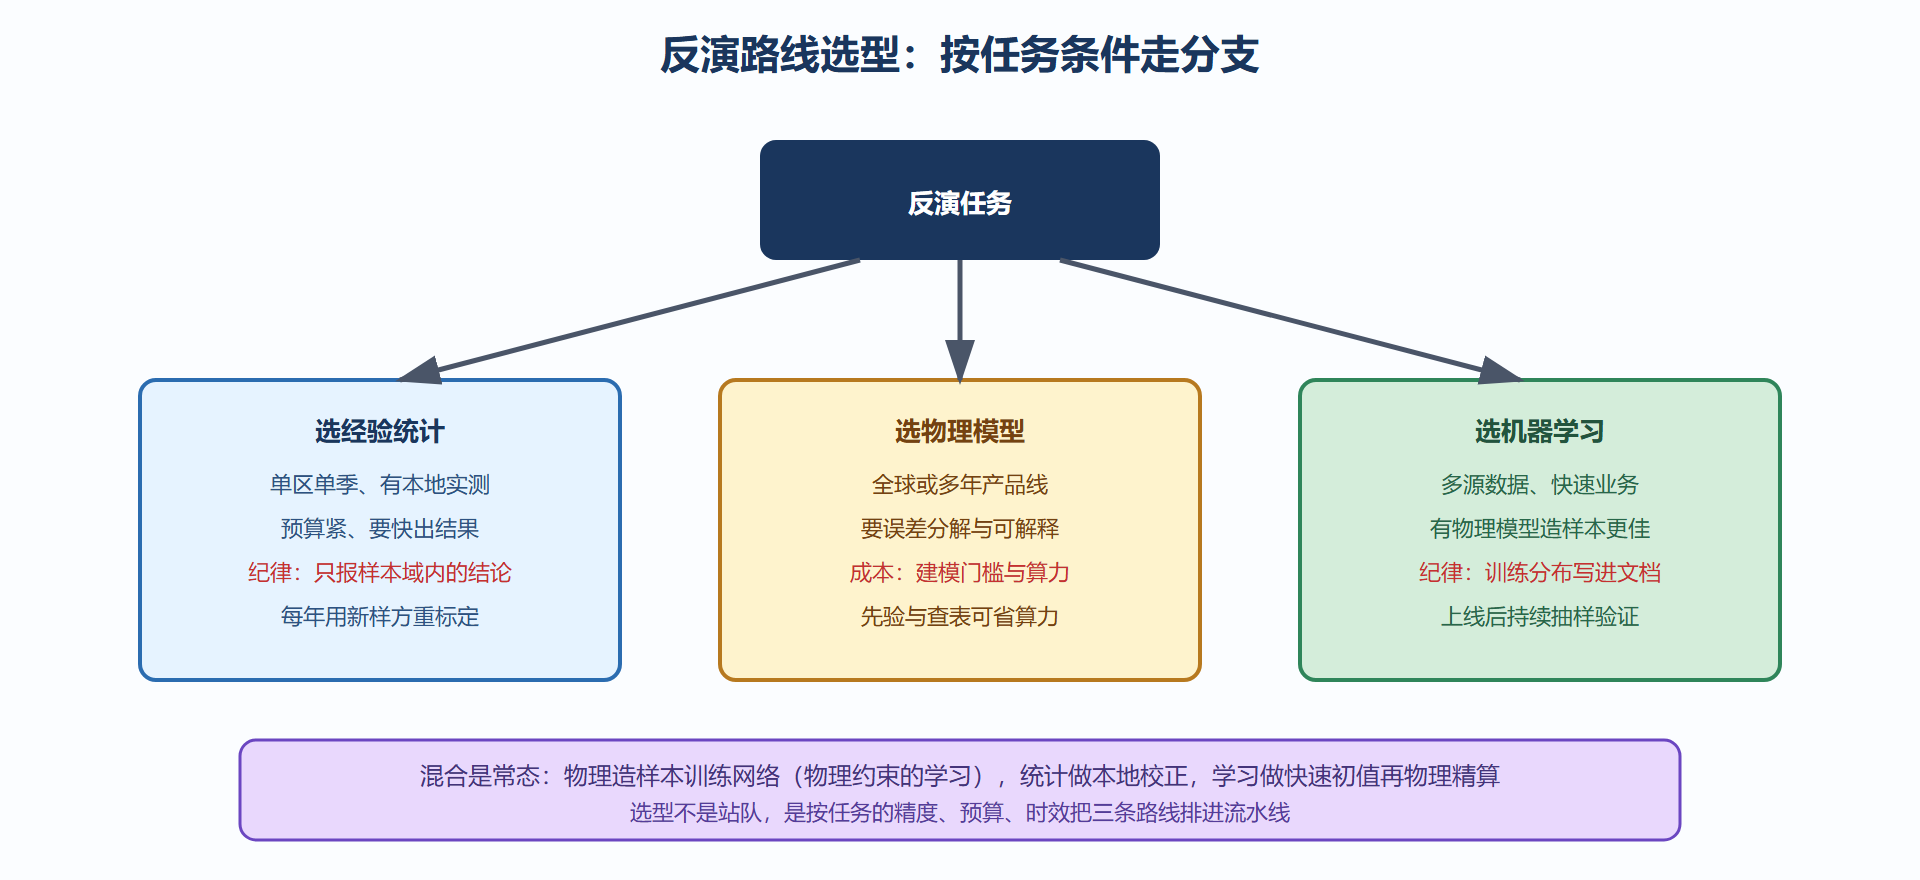
经验统计路线架桥最直接:地面实测参数与同步影像特征(指数、波段、纹理)直接回归,样本就是模型。它的账本很简单——启动成本最低(几十个实测样方加一次回归),没有物理模型误差;同样简单的是它的边界:模型只在样本覆盖的"参数范围、地物类型、光照条件"内可靠,跨区域跨年份外推就是裸奔,且无法告诉你误差从哪来。物理模型路线走正演反演一体化:辐射传输模型正向描述"参数到信号",反演时在参数空间里搜索与观测最匹配的组合。它不吃实测样本(先验与模型自带物理约束)、外推最可靠、误差可分解;代价是模型选择与参数化的门槛高、查表与迭代搜索的算力成本高,且模型本身的不完美转成了系统性误差。机器学习路线居中偏快:以物理模型批量生成的模拟数据(或实测样本)训练非线性映射,反演时一次前向计算出参数。它继承了物理路线的样本广度与统计路线的速度,能吃进多源特征(光学、雷达、地形一起喂),弱点是外推仍受训练分布约束、可解释性弱——错了不容易说清为什么。
三条路线的成本结构差异值得用一张表对齐:
| 维度 | 经验统计 | 物理模型 | 机器学习 |
|---|---|---|---|
| 启动成本 | 低:几十样方即可 | 高:建模与参数化门槛 | 中:需大量训练数据 |
| 外推能力 | 差:样本域内有效 | 强:物理约束跨域 | 中:限训练分布 |
| 可解释性 | 中:系数可读 | 强:误差可分解 | 弱:映射黑箱 |
| 算力成本 | 极低 | 高:迭代搜索 | 低:训练后前向极快 |
| 典型场景 | 单区单季制图 | 全球标准产品线 | 多源融合快速产品 |
一次对照实验:三条路线的行为差异
用同一份模拟数据把三条路线跑一遍,观察它们在"内插"与"外推"两端的表现差异:
# 三路线对照演算:内插可靠,外推见真章 import numpy as np rng = np.random.RandomState(9) # 真实机理(模拟物理模型):ndvi 与 lai 的饱和关系 def forward(lai): return 0.95 * lai / (lai + 1.2) + 0.05 lai_train = np.random.uniform(0.5, 4.0, 200) # 训练域:LAI 0.5 至 4 y = forward(lai_train) + rng.normal(0, 0.02, 200) # 路线一:线性回归(经验统计的极简版) A = np.vstack([y, np.ones_like(y)]).T coef, *_ = np.linalg.lstsq(A, lai_train, rcond=None) # 路线二:物理反演(用真实正演模型逆解,代表"知道机理"的优势) def phys_inv(signal): s = np.clip(signal - 0.05, 1e-3, None) return 1.2 * s / (0.95 - s) # 路线三:非线性机器学习(多项式特征回归,代表灵活拟合) X = np.vstack([y, y**2, y**3, np.ones_like(y)]).T coef3, *_ = np.linalg.lstsq(X, lai_train, rcond=None) lai_test_in = np.array([1.0, 2.0, 3.0]) # 域内 lai_test_out = np.array([4.8, 5.5]) # 域外(饱和区外推) for name, f in [("线性统计", lambda s: coef[0]*s + coef[1]), ("物理反演", phys_inv), ("非线性学习", lambda s: X @ coef3 if False else (lambda v: (np.vstack([v, v**2, v**3, np.ones_like(v)]).T @ coef3))(s))]: pred_in = np.round(f(forward(lai_test_in)), 2) pred_out = np.round(f(forward(lai_test_out)), 2) print(f"{name} 域内预测 {pred_in} 域外预测 {pred_out}") print("域内真值", lai_test_in, " 域外真值", lai_test_out) # 典型结果:域内三家都还行;域外线性统计率先离谱,物理反演依然稳定
实验揭示的规律与文献结论一致:域内三家差别不大,域外见真章——统计路线的失败是静默的(给出一个看似合理的错值),物理路线的优势正是它"知道自己不知道"。这解释了全球标准产品线坚持物理路线、业务快报偏爱机器学习路线的行业分工。
图 6-3:三条路线的选型决策
常见问答
问:机器学习反演需要多少训练样本? 取决于参数维数与地形异质性。物理模型造样本的路线上,几十万条模拟数据不难获得,瓶颈变成模拟数据的真实性;纯实测样本路线,几千条起步是常态。真正要盯的指标不是样本量而是样本域覆盖——参数范围、地物类型、观测几何都要铺到。
问:混合路线具体怎么搭? 一个常见配方:物理模型按全球参数分布批量正演,训练出基础网络;本地实测做微调或残差校正;上线后按季度抽样验证,漂移超阈值就触发再训练。每一环都对应本章一张账——物理给外推、学习给速度、验证给信用。
问:可解释性差只是"不好看"吗? 不,它是风险。黑箱模型在分布外输入上的行为无法预判,业务上表现为"偶发的、无法解释的大错"。对账型任务(碳核算、保险定损),可解释性直接写进合规要求——这也是物理路线在关键产品线不可替代的原因。
要点回顾:经验统计启动最快但只在样本域内可信,物理模型严谨可外推但建模与算力昂贵,机器学习灵活吃多源但受训练分布约束、可解释性弱;对照实验的教训是"域内三家相近、域外见真章",外推需求一旦出现就必须引入物理约束;混合路线是行业常态——物理造样本、学习出产品、统计做本地校正、季度验证防漂移;可解释性在合规场景是硬要求而非加分项;无论选哪条线,训练域与适用域写进产品文档都是不可省略的交付义务。下一节给所有这些努力做最终结算——验证与地面真值。
附:方法选型速记卡
速记四条。一、先问外推再选法:任务会不会碰到样本域之外?会,就必须物理约束打底。二、样本域写文档:无论哪条路线,训练域的参数范围、地物类型、观测几何都要写进产品说明。三、漂移要监控:上线产品的精度会随输入分布漂移,季度抽检加再训练触发线是标配运维。四、混合是常态:物理造样本、学习出产品、统计做本地校正,三条腿各司其职。补一个面试常问的问题练手:"给你一个新区域的土壤水分制图需求,数据有限,怎么设计反演方案?"——好答案的骨架正是本节三路线加四条速记:先物理模型造模拟样本训练初版,少量实测做本地校正,适用域与不确定性随产品交付,上线后按季验证。
延伸:评审反演方案的问题清单
当你坐在评审席上听一个反演方案汇报,按这份清单发问就足够专业:正演或机理依据是什么、模型的适用边界在哪?训练或率定样本的来源、数量、时空分布如何,与目标区域差多远?验证怎么做的、样本是否独立、指标是否成组报告?产品的适用域与已知失效场景写了没有?输入数据的质量要求(定标、云、配准)与处理链是否匹配?不确定性是怎么算的、主要贡献项是什么?六个问题里若有三个答不上来,方案就还停在"演示阶段"。这清单也是自我审查工具——写完方案自己先过一遍,被问倒的问题就是下一个工作项。评审文化的本意不是挑刺,而是让每个数字在出门前都经过同样严格的盘问。
附:模拟样本的真实性检查
物理模型造样本最怕"模型世界与真实世界有系统差",四步检查法保平安:一、端点对表——模拟数据的参数分布两端是否覆盖了真实影像的观测范围;二、残差体检——用少量实测样方对照模拟信号,残差应有零均值且无结构化花纹;三、跨模态互证——模拟数据训练的模型在真实影像上的梯度分布应与实测训练的相近;四、留一手真数据——总保留一批真实样本只用于最终验证,绝不参与训练。四步全过,模拟样本才算拿到了"上岗证";任何一步不过,老老实实回炉调模型参数或缩小适用域声明。
再补一条关于"起点选择"的建议:新团队进某个参数方向,第一版产品建议走"物理查表或成熟开源模型加本地验证"的路线,而不是自研模型。理由有三:成熟模型的物理框架已被多年文献检验,踩坑成本低;团队精力应该先花在数据质量与验证体系上,这两样才是自有的长期能力;有了第一版产品,与用户的对话就有了实体,需求澄清远比闭门造车高效。自研改进放在运营反馈明确指出瓶颈之后——先跑通,再跑好,最后跑巧,次序不能乱。