6.4 精度验证与地面真值
6.4 精度验证与地面真值
本节摘要:没有验证的反演只是漂亮的猜测。本节讲验证体系的三个支柱:地面真值从哪里来(通量塔、样方调查、移动测量)、抽样怎么设计(分层随机、时空配准、尺度桥接)、指标怎么读(决定系数、均方根误差、偏差各自说明什么),并用散点图的三种系统性形态训练"读图诊断"的能力。
精度要用地面说话
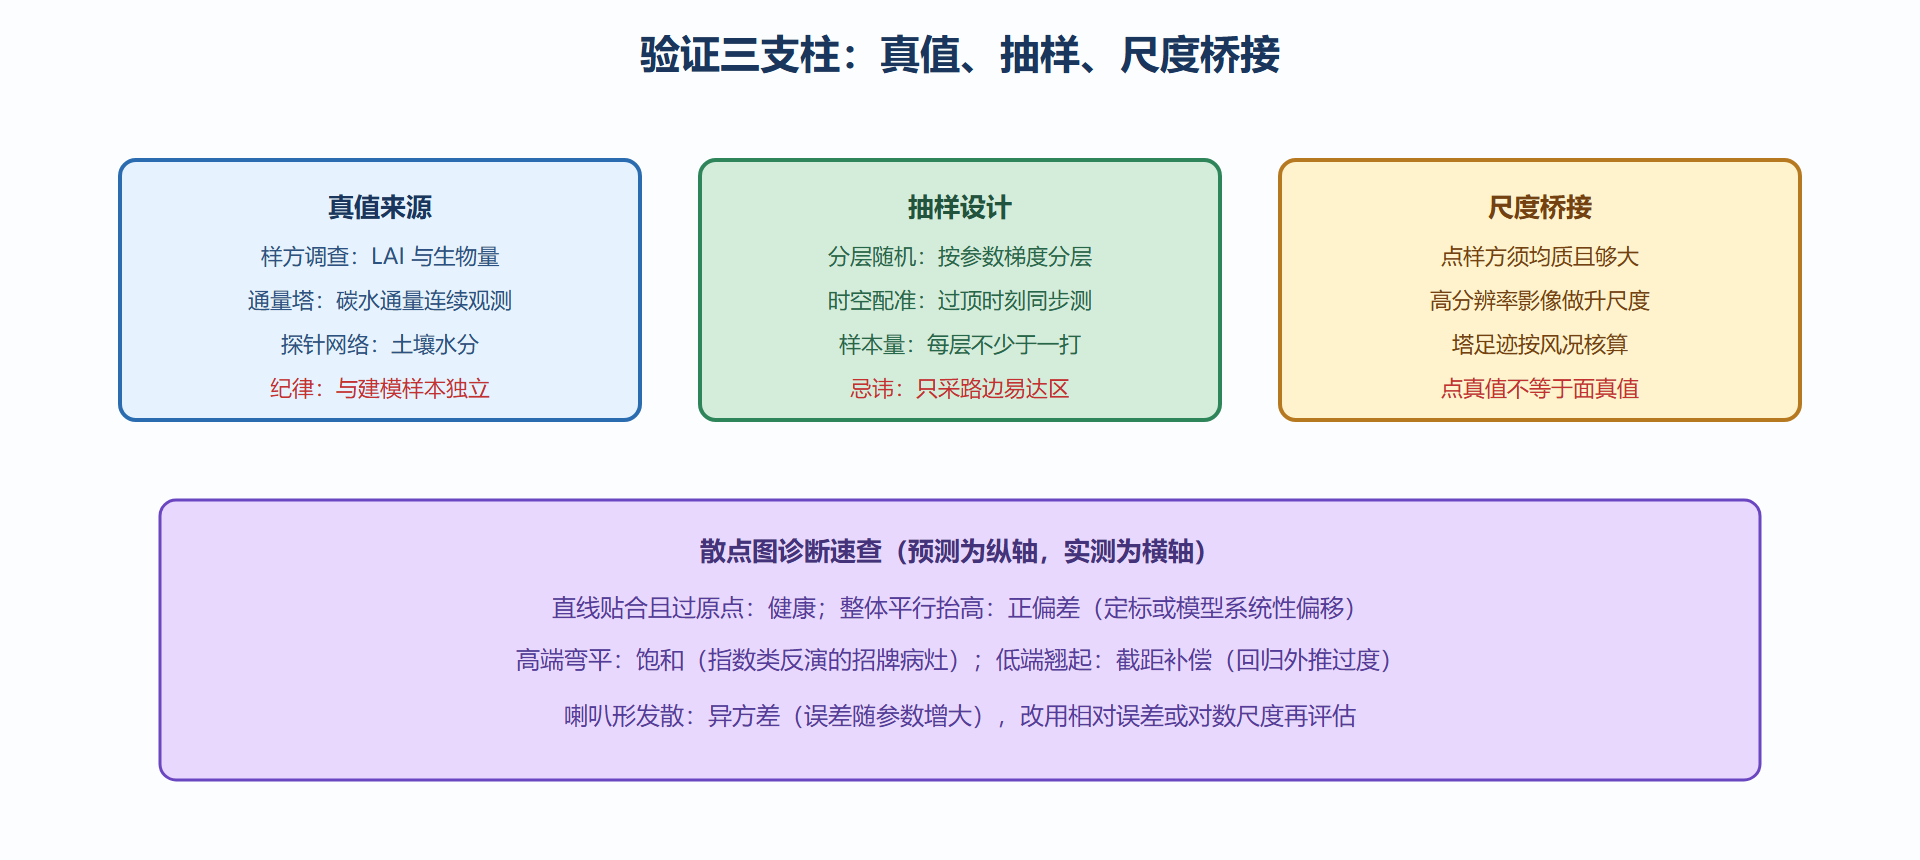
验证的本质是拿一组独立的、可信的地表实测,给参数产品的误差定量。真值来源按参数各有讲究。植被参数靠样方调查:人工数叶面积(或用冠层分析仪、落叶法)测定样方 LAI,配套生物量收割与含水量测定;样方选址要覆盖参数范围的两端与中部——只测中等长势的样方,回归曲线两端就是拍脑袋。通量涡度相关塔提供碳水与能量的连续实测,是 LAI、蒸散发、总初级生产力产品的最高级验证锚点,其"足迹"(塔所代表的下垫面范围)与像元的匹配要按风况分析,不能想当然。土壤水分有宇宙射线中子法与多点探针网络的分钟级实测;地表温度可用红外测温辐射计在同步过顶时刻标定靶区。真值数据的共同稀缺性决定了它的使用纪律:验证样本必须与建模样本严格独立——拿训练样方自评精度,等于让考生自己判卷。
图 6-4:验证抽样与尺度桥接
指标怎么读:一段结算演算
验证的产出是一组指标加一张散点图。指标各管一件事:决定系数(R 平方)管"解释了多少变化",均方根误差(RMSE)管"典型误差多大",偏差(bias)管"整体偏高还是偏低"。只报 R 平方不报 RMSE 是常见的江湖话术——相关性高不代表数值准。用一段演算把指标算出来并做诊断:
# 验证指标演算与散点形态诊断 import numpy as np rng = np.random.RandomState(33) obs = np.sort(np.random.uniform(0.5, 6.0, 150)) # 实测 LAI pred = obs * 1.12 + 0.15 + rng.normal(0, 0.35, 150) # 模拟:偏高加噪声 r2 = np.corrcoef(obs, pred)[0,1]**2 rmse = np.sqrt(np.mean((pred - obs)**2)) bias = np.mean(pred - obs) print(f"R2={r2:.3f} RMSE={rmse:.2f} 偏差={bias:+.2f}") slope = np.polyfit(obs, pred, 1)[0] print(f"回归斜率={slope:.2f}(大于 1 表示高端高估、低端低估的扇形倾向)") hi = obs > 3 print(f"高端(LAI大于3)偏差 {np.mean(pred[hi]-obs[hi]):+.2f},低端 {np.mean(pred[~hi]-obs[~hi]):+.2f}") # 诊断:整体正偏差加高端放大——回到 6.2 的饱和问题与土壤背景校正找原因
验证报告的最后一栏是验收意见:这个产品的误差水平,配不配你的任务。旱情监测容忍均方根误差零点零几立方厘米每立方厘米的土壤水分误差,产量预估对 LAI 的容忍度则换算成产量百分比来算账;同一份产品在两个任务里可能一个合格、一个不合格。任务日志的验收习惯因此是"带着用途读精度"——脱离用途谈精度,等于脱离菜谱谈盐量。
常见问答
问:验证样地要多少个才够? 按参数梯度分层、每层不少于一打是下限;参数范围宽、地表异质强的区域成倍增加。比数量更要紧的是分布——把样地铺在参数范围的两端与中部,梯度上不留空洞,回归与误差评估才有意义。
问:实在没有地面实测,能验证吗? 有三条降级路线:用更高分辨率产品当"过渡真值"(升尺度桥接);用多源交叉验证(雷达与光学产品互相印证);用物理一致性检查(能量平衡、水量平衡闭合)。三条都做不了,产品只能标注"未经验证",且必须在文档里明示——沉默才是最大的失信。
问:精度指标报多少位小数合适? 与误差同量级即可:RMSE 零点四七的产品,报两位小数;报到四位小数是伪精度。另一个细节是样本量置信区间——样地只有十几个时,精度指标本身带着不小的抽样误差,报告里应写明,这比指标本身更显专业。
要点回顾:真值来源按参数各有所属,样方、通量塔、探针网络、同步测温各管一段,与建模样本独立是验证的合法性底线;抽样按参数梯度分层、过顶时刻同步、忌讳只采易达区,点真值与面真值之间要做尺度桥接;指标要组合着读——R 平方管解释力、RMSE 管典型误差、偏差管方向,斜率与高端低端分组偏差是定位病灶的线索;没有实测时走过渡真值、交叉验证、一致性检查三条降级路线,做不了就诚实标注;验收意见永远带着任务用途写,脱离用途的精度承诺没有意义。下一章把单参数、单星的视角升级为多源协同。
附:验证设计速记卡
速记五条。一、独立是底线:验证样本与建模样本的分离要物理隔离,不只是随机划分。二、梯度要铺满:样地覆盖参数范围两端与中部,分层抽样按梯度分层。三、同步是铁律:过顶时刻的同步实测,差几小时物候与水分都会变。四、指标要成组:相关性、误差量级、偏差方向三件套一起报,斜率与分组偏差做诊断。五、结论带用途:验收意见按任务误差预算写,写清"够谁用、不够谁用"。一个组织建议:把验证样地的选址、测量规程、历史数据做成团队的长期资产——样地网络是最难速成的基础设施,一旦建成,就是所有反演项目的共同地基,也是团队最深的护城河。
延伸:给验证报告挑刺的五个角度
反过来学:当你收到一份验证报告,按五个角度挑刺。一看抽样框:验证样本是随机抽的,还是"顺手挑的好看区域"?二看独立性:验证样地与建模数据有没有时空上的藕断丝连?三看尺度:点测量升到像元尺度的桥接方式写了没有?四看指标完整性:只有总体精度没有分类项精度、只有相关系数没有误差量级的,都算报告不全。五看结论边界:验收意见里有没有写"不适用于什么"?五角度全过的报告才值得进入决策链。这层能力在职业上的意义不小:随着参数产品越来越多地进入考核与结算,能读懂验证报告、敢于质疑验证质量的人,就是组织里防止"数字游戏"的那道闸。
附:样方测量速记
地面样方测量的五条速记:一、样方尺寸匹配像元——中分辨率数据的样方边长最好超过三个像元且内部均质;二、时间卡同步——过顶前后数小时内完成测量,光谱与水分这类快变量尤其如此;三、记录留照片——每个样方的全景与近景照片是日后一切争议的最终证据;四、测什么练什么——测量规程按反演模型需要的变量写,多余的测量宁精勿滥;五、批次交叉标定——多人多设备时先做交叉标定,人差与仪器差要在进入数据集前扣除。样方数据是反演的"硬通货",这五条是硬通货的铸造标准。
补一条关于验证频率的建议:验证不是交付前的一次性动作,而是产品生涯里的例行体检。推荐三档节奏——每次生产的自动质量检查(值域、覆盖率、空间一致性)逐期做;季度性的抽样精度评估(独立样地或高分对比)按季做;年度性的全面验证(含外业与规程评审)按年做。三档体检的结果都进产品档案,形成连续的精度履历——产品可信度的本质,是这份履历的连续与诚实。
最后一问:验证体系需要多少投入?经验比例是项目预算的一到两成——样地建设、外业组织、独立复核加起来不便宜,但它买到的是整个产品体系的地基。把验证预算写进立项书的第一页而不是尾注,是定量项目成熟度的试金石;砍验证省下的钱,通常会在下一次"数字不可信"的危机里连本带息地还出去。