7.1 多源融合:光学与雷达互补
7.1 多源融合:光学与雷达互补
本节摘要:光学数据给颜色与光谱细节,雷达给结构、湿度与全天时——两者短板恰好互锁。本节建立"先问互补性、再选融合档位"的方法次序:像素级、特征级、决策级三档融合各有代价,时空融合则专门解决"细节与频率不可兼得"的矛盾,并以洪涝制图为例走通一条完整的融合流水线。
单星视角不够用了
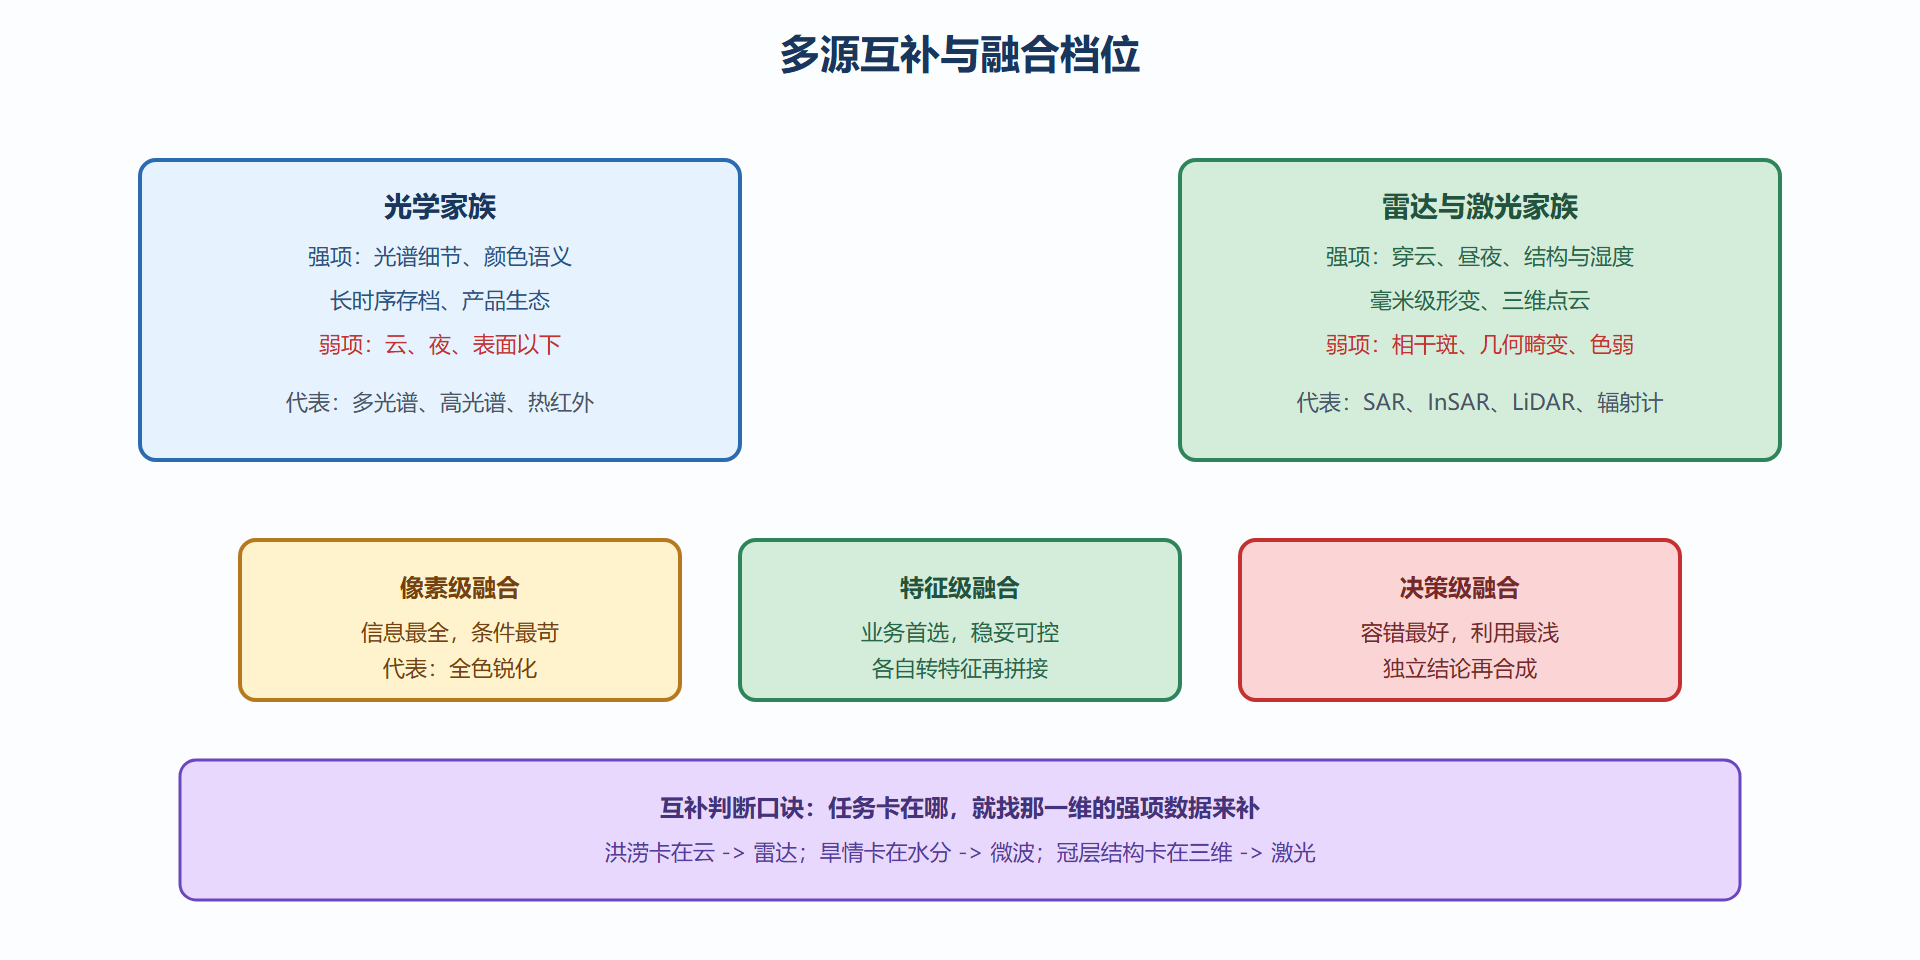
前六章的默认视角是一颗卫星的一次过顶,本章把镜头拉远看体系。互补性的判断先于一切融合技术:把候选数据源的强弱项列成清单,找"你的任务短板恰好是别人长项"的组合。光学与雷达的互补近乎教科书级:光学怕云、雷达无视云;光学夜里失明、雷达昼夜工作;光学读表面光谱、雷达读几何结构与介电特性;作物在光学影像上是"颜色与长势"、在雷达影像上是"冠层结构与含水量"。激光雷达补第三维、热红外补温度维、被动微波补大尺度水分维——每补一维,任务的盲区就少一块。
融合的档位按信息抽象层级分三档,选择依据是"两类数据的信息在哪个层面等价"。像素级融合在原始数值层面操作,典型是全色锐化与主成分替换——信息最完整,但对配准与辐射一致性要求苛刻,且两类数据的物理量纲不同时容易"融出物理上不存在的东西"。特征级融合先把各自数据转成特征(光学的 NDVI、雷达的后向散射及其时序统计)再拼特征向量,是业务中最稳妥的档位——物理各自解释、融合发生在判别层。决策级融合让每个数据源独立出结论再投票或加权(光学分类图与雷达分类图按可信度合成),容错性最好、信息利用最浅,适合数据质量参差的场合。
图 7-1:光学与雷达的互补与三档融合
时空融合:细节与频率都要
分辨率四维权里最难的服务矛盾是"又要空间细节、又要时间频率":高分辨率卫星几天才来一次,高频卫星只有粗分辨率。时空融合方法(如星形映射类算法家族)的思路是利用两者的相关结构,用"高频粗分辨率影像记录变化、低频高分辨率影像提供细节基准"的加权合成,造出高频率加高细节的估算影像。它的边界同样要立住:合成影像是估算而非真实观测,突变地物(新建建筑、水体扩张)在粗分辨率数据里本就模糊,合成结果会迟滞;云期的长缺席会让权重失真。业务纪律:合成产品用于趋势与长势监测,灾害定损与面积量算仍以真实观测为准。
一次完整的融合流水线演算,以洪涝制图为例——它是特征级融合与"互补口诀"的示范案例:
# 洪涝淹没制图:光学与雷达特征级融合(演算) import numpy as np rng = np.random.RandomState(17) n = 5000 ndwi = np.concatenate([rng.normal( 0.45, 0.10, 1200), # 水体:NDWI 高 rng.normal(-0.25, 0.12, 3800)]) # 陆地 vv = np.concatenate([rng.normal(-20.0, 2.5, 1200), # 水面后向散射低 rng.normal( -8.0, 3.0, 3800)]) # 陆地散射强 # 光学单独判:NDWI 阈值 0.1 opt_water = ndwi > 0.1 # 雷达单独判:VV 低于 -14 dB 且平滑 sar_water = vv < -14 # 特征级融合:两者一致判水;冲突时以雷达优先(多云天气任务的真实场景) fuse = np.where(opt_water & sar_water, True, np.where(sar_water & (ndwi > -0.05), True, False)) truth = np.concatenate([np.ones(1200, bool), np.zeros(3800, bool)]) print(f"光学单独:用户精度 {np.mean(opt_water[opt_water==truth]==truth)*100:.0f}% 级(简化)") print(f"融合判水像元 {fuse.sum()},真值水体 1200,漏检 {(truth & ~fuse).sum()},误报 {(~truth & fuse).sum()}") # 云雨天的光学不可用时,雷达独立制图保底;光学可用时融合降误报
演算浓缩了洪涝任务的真实分工:应急期靠雷达保底出图,天窗期用光学精化边界,融合规则按"雷达优先、光学校核"写成一句可审计的决策逻辑。## 常见问答
问:融合前各源数据要做什么准备? 三件套:几何对齐(到任务允许的配准预算内,通常是彼此分辨率的一半)、辐射口径统一(各自做到物理量——反射率、后向散射系数,别拿 DN 值相融)、时间匹配(差几天可接受由变化速度决定)。三件套不全就硬融,融合只会放大误差而不是互补优势。
问:多源数据分辨率不同,融合到哪个尺度? 通常就低不就高:把细分辨率重采样到粗分辨率的网格上做特征融合,保物理稳妥;确需向细尺度出产品(如把公里级温度降尺度到百米级),属于降尺度反演问题,要带辅助数据(分类、地形)并单独验证,不能简单重采样了事。
问:深度学习的多模态融合和传统特征级融合是一回事吗? 思路同源——都在回答"两路信息在哪一层汇合";差异在学习方式,多模态网络让权重自动学出来,传统方法人工定权或按规则。业务选择看样本与可解释性预算:样本足、要自动化,上多模态网络;要可审计,特征级加显式规则更稳。
要点回顾:互补性判断先于融合技术,任务短板决定补谁;三档融合按信息层级递进,特征级是业务稳妥档;融合前的三件套——几何对齐、辐射口径统一、时间匹配,缺一项就先补一项;时空融合能造"高频高细"但产物是估算,量算仍以真实观测为准;融合规则要写成可审计的逻辑而不是隐在代码深处。下一节给数据加上时间轴——时序分析。
附:融合实施速记卡
速记四条。一、互补表先行:把候选数据源的强弱项列成表,任务的短板对着表找补。二、三件套不齐不动手:几何对齐、辐射口径统一、时间匹配,缺一先补一。三、档位按可解释性选:要审计走特征级加显式规则,样本足要自动化再上多模态网络。四、估算产品要标注:时空融合的产物是估算值,产品名与文档里都要写清,量算场景回到真实观测。一个训练方法送给读者:拿一个公开的灾害案例,手工把"光学、雷达、地形"三源数据按本节流程做一次小范围融合,从互补表写到融合规则——做完这一遍,多源思维就从"知道"变成"会做"了。
延伸:融合项目的失败清单
融合项目常败在三件小事上。其一,辐射口径偷懒:光学用反射率、雷达用分贝值,直接拼进同一个特征向量,模型学到的全是量纲噪音——先统一物理口径再谈融合。其二,配准预算挪用:把亚像元配准的功夫省了,融合产品的边缘到处是重影,用户第一次叠加就露馅。其三,融合规则不可审计:权重写在模型黑箱里,客户问"为什么这天判定为淹没"答不出过程——把规则显式化,哪怕牺牲一点精度,也是面向业务的最优解。清单的反面就是成功要素:口径统一、几何对齐、规则显式,三件事都是笨功夫,但融合产品的口碑恰恰是笨功夫堆出来的。做融合方案时把这份清单贴在手边,评审会上你会感谢它。
附:融合质量抽检四问
融合产品的质量抽检问四个问题:边界干净吗——水体与地块边界处有无重影或错位(配准问题第一现场);量纲一致吗——同一地物在融合前后物理量级是否守恒(口径问题的照妖镜);规则可溯吗——随机抽若干像元能否按显式规则复演出融合结果;时序可比吗——多期融合产品之间是否可比,还是每期各自为政。四问构成一张抽检卡,随批抽取、随批记录;融合产品的用户信任,就是被这一张小卡片一次次攒出来的。
补一个关于"互补性验证"的小实验:在急着写融合代码之前,先做一次散点检查——把两源特征在样本点上做二维散点,看目标类别在两源特征平面上的分布。若类别在联合空间里已经分得开,你的融合方案有了数据背书;若仍然重叠,先回头补特征或换源,而不是指望融合算法奇迹。这个十分钟的小实验,是融合方案评审会上最有说服力的一页——它把"为什么这么融"从理念变成了图形证据。