7.2 时序分析与变化检测
7.2 时序分析与变化检测
本节摘要:把同一像元的历次观测按时间排开,影像就从"照片"变成"心电图":谐波拟合抓物候周期,滤波去云雾噪声,轨迹突变检测把两期对比的变化检测升级为"何时变、变多深、恢复没有"的过程监测。本节给出时序构建、去噪、突变检测的完整演算与工程要点。
时间维度里的地物
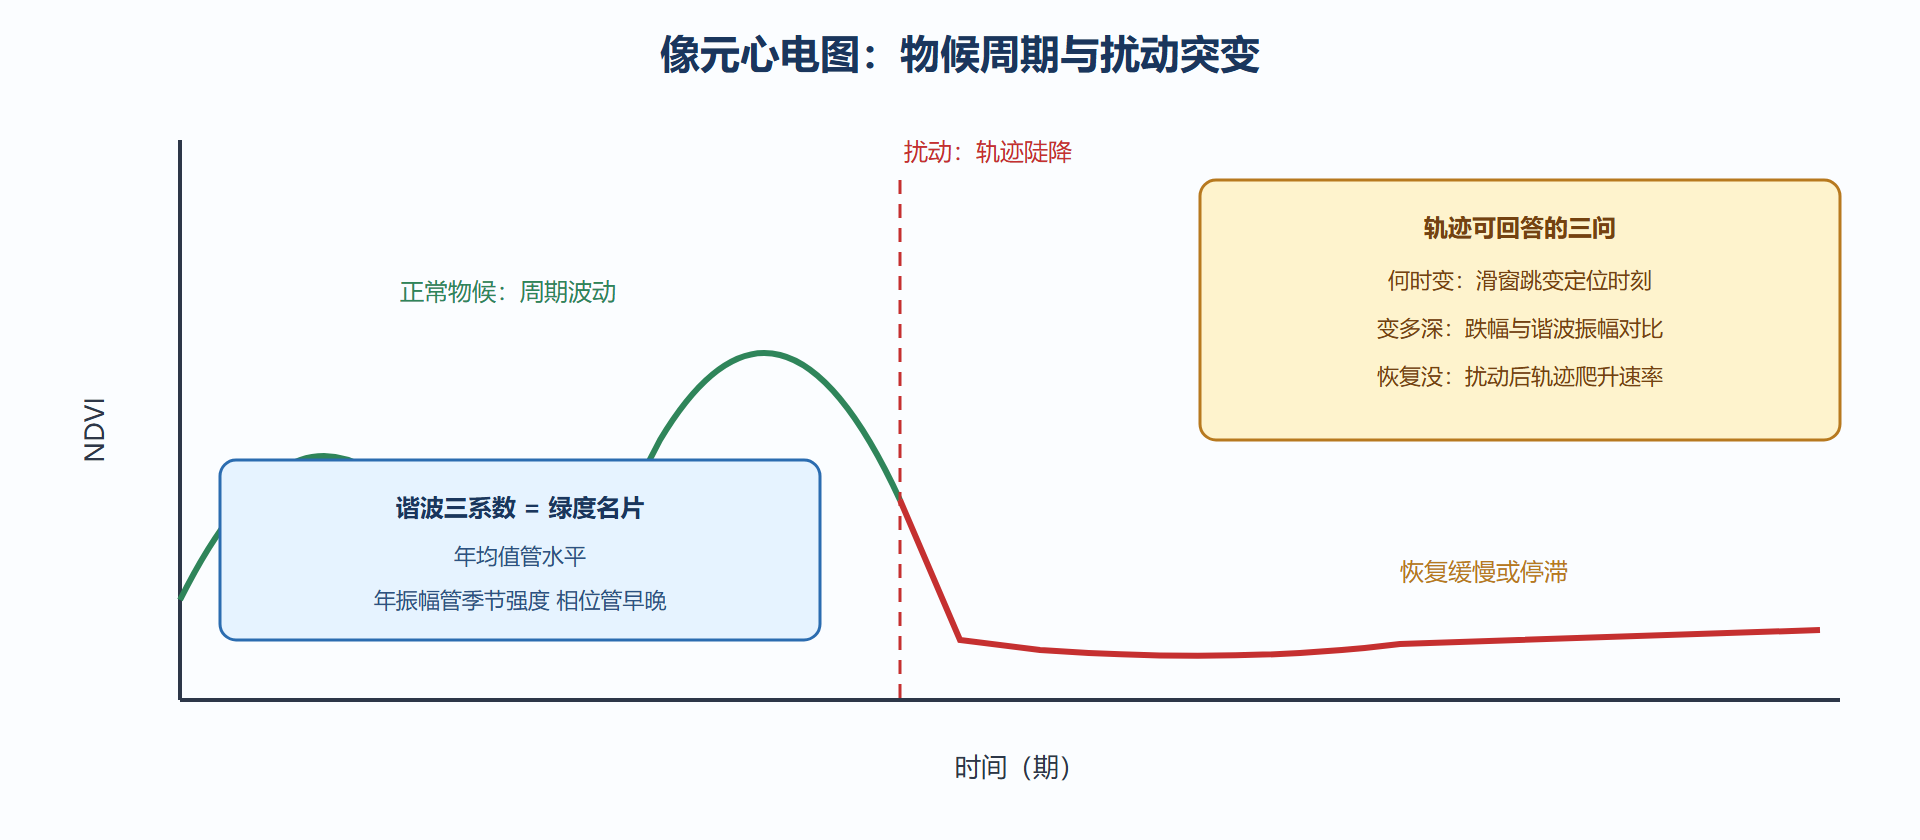
第 5 章的两期对比只回答"变没变",时序分析回答"怎么变的"。多数地物的时间轨迹有明确语法:植被有年内物候周期(绿起、峰值、衰落),农田有耕作轮作节律(播种、生长、收割、休耕),水体与城市相对平稳;扰动事件(火烧、砍伐、涝灾、建设)则在轨迹上留下陡降、清零或跳台阶。时序分析的全部技巧,就是从含噪观测里把这些语法读出来。它相对两期对比的优势有三个:突变的时刻可定位(第几期发生的);类型可区分(渐变与突变、可逆与不可逆);恢复可量化(扰动后轨迹爬回历史水平的速度,是生态评估的核心量)。
时序构建的第一道坎是观测不等间隔且带缺口:云让光学时序千疮百孔,重访让间隔忽长忽短。工程处理是"重采样到规则格网加插值补洞"——按八天或十六天合成出规则时序,缺口用相邻观测插值;第二道坎是噪声,双滤波(时域滑动中值加 Savitzky-Golay 类平滑)或谐波拟合都能压噪,谐波法的额外红利是把物候周期参数化:年均值管水平、年振幅管季节强度、相位管物候早晚——三个系数就是一座像元的"绿度名片"。
# 时序构建与谐波拟合演算:物候参数化 + 突变检测 import numpy as np rng = np.random.RandomState(41) t = np.arange(0, 3*23) # 三年,23 期每年(16 天合成) ndvi = 0.45 + 0.20*np.cos(2*np.pi*t/23 + 0.8) + rng.normal(0, 0.03, len(t)) ndvi[t >= 40] -= 0.30 # 第 40 期发生砍伐扰动,此后低水平 ndvi[t >= 40] += 0.18*np.cos(2*np.pi*(t[t>=40]-40)/23 + 0.8) # 谐波拟合:常数 + 年周期正余弦 X = np.vstack([np.ones_like(t), np.cos(2*np.pi*t/23), np.sin(2*np.pi*t/23)]).T coef, *_ = np.linalg.lstsq(X, ndvi, rcond=None) fitted = X @ coef print(f"年均值 {coef[0]:.2f} 年振幅 {np.hypot(coef[1], coef[2]):.2f}") # 突变检测:滑动窗口前后均值差的最大跳变点 w = 8 diff = [abs(ndvi[i+w:].mean() - ndvi[max(0,i-w):i].mean()) for i in range(w, len(t)-w)] break_i = int(np.argmax(diff)) + w print(f"检测到突变点在第 {break_i} 期(真实为 40),跳变幅度 {max(diff):.2f}") # 三个谐波系数刻画"绿度名片",滑窗跳变给出扰动时刻——轨迹语法的最小实现
图 7-2:时序轨迹的语法与扰动识别
从轨迹到业务:监测系统的三个设计点
把时序分析装进业务系统时,三个设计决定成败。基线的选择:突变检测的"参照系"是历史基线,用近三年还是近十年、要不要剔除干旱年,直接决定告警灵敏度——基线太短会把气候波动当扰动,太长会把渐进退化漏当正常。告警的代价结构:滑动窗口短则响应快但误报多、长则稳但滞后;业务上常用两级配置——短窗敏感版做初筛告警、人工确认后再进长窗严判版复核。轮作与物候的区别对待:农田轨迹每年"清零"是正常耕作,固定阈值会把收割当砍伐;成熟做法是按地块先分类再套各自的变化规则,或干脆用谐波残差(偏离正常物候的程度)代替原始值做检测。这三点没有任何模型炫技,却决定了同一个算法在不同项目里"灵不灵"的口碑差距。
再补一个常被忽略的工程细节:时序产品必须带着观测质量层一起交付。每个时相的云掩膜、观测角度、合成影像数都应随轨迹存档——轨迹上的可疑跳变,第一排查动作就是回到质量层看那期是不是坏观测。没有质量层的时序产品,等于心电图没贴电极片编号。
常见问答
问:时序用原始 NDVI 还是谐波残差做检测? 常规做法分场景:自然植被的扰动检测(砍伐、火烧)在原始轨迹上做滑窗跳变即可;农田区轮作频繁,谐波残差(偏离正常物候的幅度)更稳,免得把正常收割记成砍伐。两者都建时序、按地块类型选用,是监测系统的成熟配置。
问:云洞太多插不动怎么办? 三招按序使用:时间插值用相邻期补(短线洞);合成加宽——从十六天合成放宽到月合成换连续性(牺牲时效);换观测源——云洞区引入雷达或合成孔径时序补线。云洞的分布要统计进产品说明,洞连成季的区域宁可标注缺测,别硬插出假的连续性。
问:时序产品的"精度"怎么表述? 与两期检测不同,时序产品报三类能力:突变时刻的定位误差(几期内)、幅度估计的偏差、恢复趋势的判定一致率。表述时要带上观测密度前提——同一算法在十六天合成与月合成上的表现不同,前提不同结论不可比。
要点回顾:时序分析把变化检测升级为过程监测,能回答何时变、变多深、恢复没有;构建时序先解决不等间隔与缺口,谐波拟合把物候参数化成年均值、振幅、相位三系数;滑动窗口跳变是最小可用的突变检测器,基线选择与窗口长度直接决定误报与滞后的平衡;农田区用谐波残差、自然植被用原始轨迹,按地块类型选检测量;时序产品必须携带观测质量层,查轨迹异常先查那期观测坏没坏。下一节解决时序背后的规模问题——数据多到本地放不下怎么办。
附:时序工程速记卡
速记四条。一、先建质量层:时序分析之前先把每期的云量、观测数、掩膜状态建成质量序列,分析结论全部带着质量背景解读。二、基线写进配置:近多年、剔不剔异常年、用哪个季节窗口——基线是配置不是默认值。三、检测量按地块选:农田用谐波残差,自然植被用原始轨迹加滑窗,规则跟随地块类型库。四、告警分级出:敏感版初筛加严判版复核,两级配置平衡误报与滞后。补一个复盘习惯:每季度把告警的实发率、误报案例、漏报案例复盘一次,反哺基线与阈值——时序系统的价值不在算法多新,而在"告警有人信",而信任是靠复盘复盘出来的。
延伸:从告警到台账的业务闭环
时序监测系统的终点不是告警,而是台账。一条完整的业务闭环长这样:算法产出变化告警(机器);外业或人工复核确认(人与机器对账);确认的变化进入业务台账(地块、面积、类型、时间、证据链);台账按周期汇总成报表与考核数据;台账里的确认样本回流,成为算法迭代的训练与验证素材。把闭环跑起来后你会发现,算法精度不再是唯一的命门——复核流程的成本、台账字段的规范、证据链的可追溯,同样决定系统成败。给项目负责人一句忠告:设计时序监测系统时,先画这张闭环图、把每个环节的责任人定出来,再回头选算法;顺序反了的项目,算法再漂亮也会死在"告警没人管"上。
附:基线配置速查
时序基线的配置速查表:自然生态系统——近五年历史、剔除极端气候年、全年窗口;农业区——近三年、同作物轮作序列对齐、按物候季分窗;城市与设施——近十年、不剔除、全年窗口(城市变化稳定,长基线更稳);新开发区——短基线加高频告警(历史不代表性、变化是常态)。基线配置表要作为产品配置随版本管理,基线一变,历史结论的口径就变——这条纪律与定标版本管理同等重要。
补一个关于节假日与农事日历的细节:时序上的周期不一定只是自然物候,还叠着人类节律——春节前后的用工波动、收获季的集中机械作业、雨季的道路中断,都会在地物轨迹与业务数据上留下痕迹。把目标区域的"人文日历"纳入时序解读,能避免把节律性波动当异常告警;做法简单:在质量层之外再配一层"日历注释层",标注已知的人类活动窗口,分析时对号入座。