7.3 云平台与遥感大数据生产
7.3 云平台与遥感大数据生产
本节摘要:当任务尺度从一景影像膨胀到全国十年时序,"下载到本地处理"的范式失效了。云平台把范式倒转为"数据不动、算法动":数据组织成数据立方体,处理任务以并行作业的方式派到数据旁边执行。本节讲清数据立方体的组织逻辑、云上分析的编程模型、本地与云端任务的分界,并给出一套任务搬迁的决策清单。
数据多到本地放不下
规模一变,工程范式就得换。免费存档的中分辨率全球数据以百 TB 计,全国范围十年的八天合成时序,本地下载与管理的存储、带宽、时间成本足以吃掉整个项目预算。云平台的解法在架构上只有一句话:把计算搬到数据旁边。数据在云端以分块(瓦片加分块存储)方式组织,分析代码被调度到数据所在的集群上并行执行,只有结果(通常小得多)传回给你。国内外主流平台的名字你可能已经听过——谷歌地球引擎、微软行星计算机、开放数据立方体家族,以及国产的云平台与数据中心体系——它们共享同一套架构思想,差别在数据目录、算力配额与生态工具。
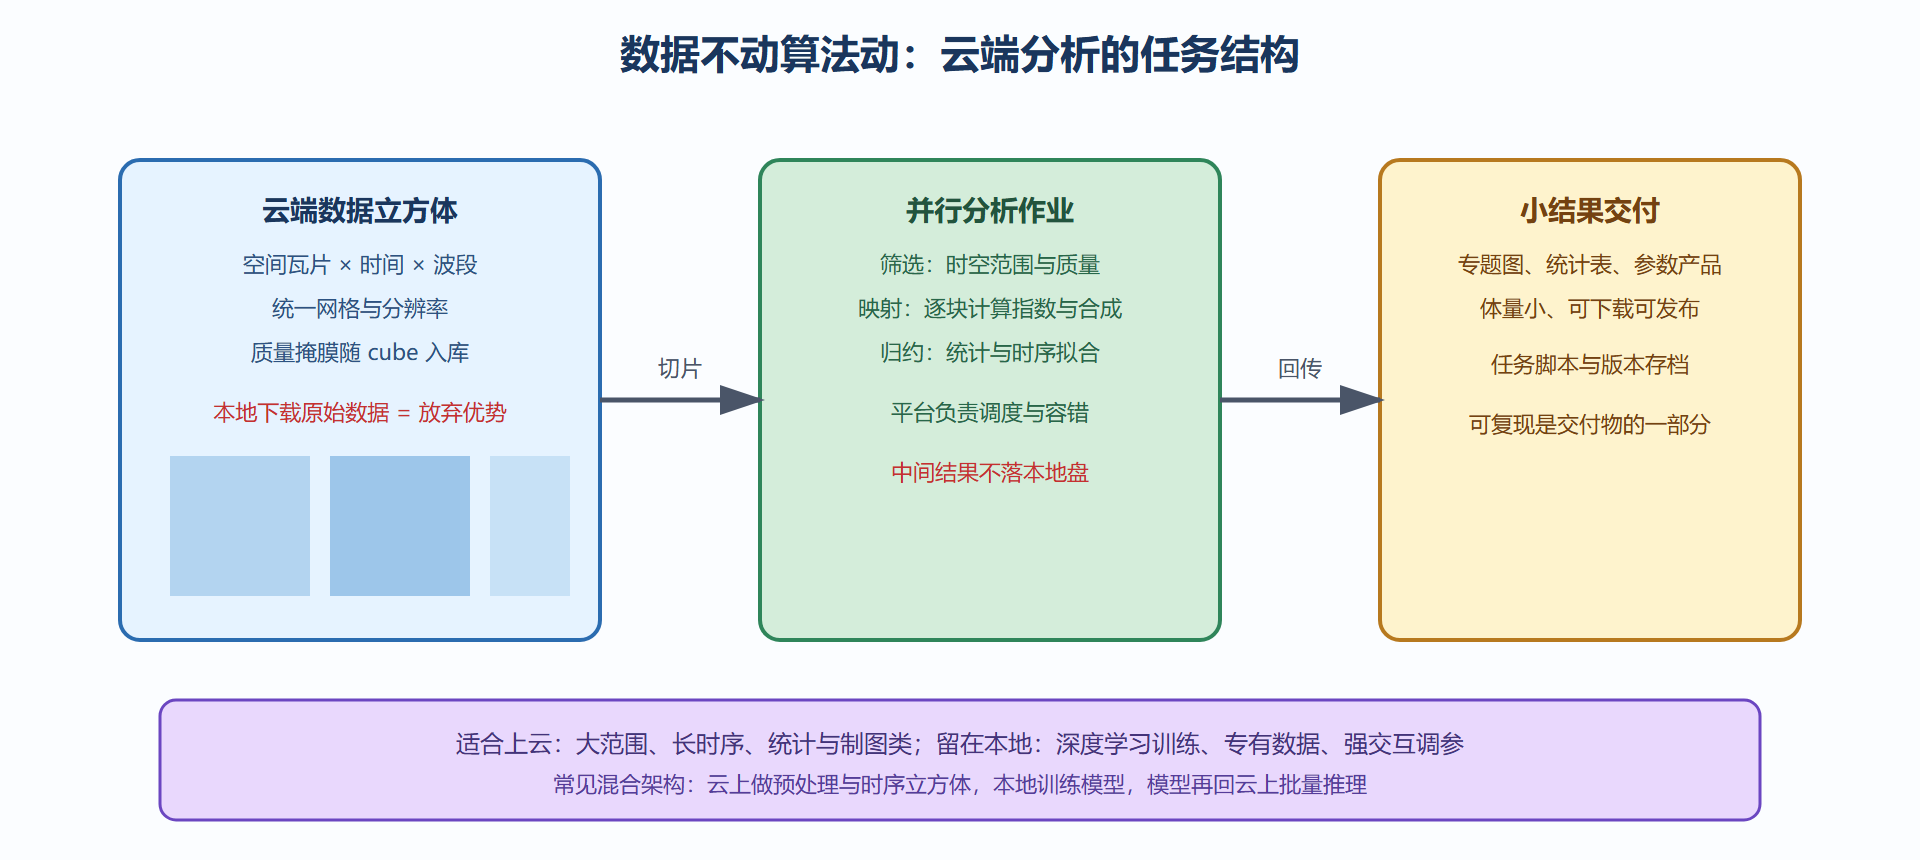
数据立方体是这个架构的核心抽象:把海量影像按"空间瓦片 × 时间 × 波段"三维规整组织,像数据库的表一样支持按需切片——取某省范围、某十年时段、某三个波段,就是立方体上的一次裁剪。它的工程前提是入库时的规整化:统一坐标网格、统一分辨率、统一瓦片边界、挂好质量掩膜。这也是为什么平台上的"无缝全球镶嵌"看起来毫不费力——不是算得快,是数据早就按同一网格码好了。分析编程模型随之改变:你写的不再是"处理一幅影像"的循环,而是"对整个集合做映射与归约"的表达式,平台负责并行与容错。写惯了本地脚本的工程师初上云最常见的失灵,是把云当"更快的下载器"用——把原始数据导出来再本地算,恰好把云计算的便宜全数放弃。
图 7-3:云上遥感分析的任务结构
上云还是留本地:一张决策清单
把任务往哪个平台放,按四问走。一问数据体量:输入输出比悬殊(吃大数据、吐小结果)的任务收益最大,典型是长时序统计与大范围制图。二问数据主权:涉密影像、商业专有数据若不允许出本地环境,云端只能处理公开数据部分。三问算力形态:深度学习训练要 GPU 集群,多数分析平台不提供训练环境,惯常做法是云端做数据准备、本地或训练平台做模型、再把模型推理任务带回云端批量执行。四问可复现要求:云端脚本的天然优势是环境与数据版本被平台固定,可复现性反而高于"各人电脑各一套环境"的本地流程——这一条常被低估,却是科研与业务审计的硬需求。
一段伪代码勾勒云上分析的编程姿态,体会"集合式表达"与本地循环的差异:
# 云上分析伪代码:全国某年最大 NDVI 合成(集合式表达) # col = 平台.影像集合("某中分辨率产品", 起止日期) # col = col.按质量过滤(云掩膜) # 平台端完成筛选 # summer = col.按季节筛选("夏半年") # max_ndvi = summer.逐像元归约("最大值") # 并行发生在平台内部 # 结果 = max_ndvi.裁剪(行政区边界).导出("区域产品") # 只回传小结果 # 本地脚本的 for 循环在这里不存在:并行、分块、容错由平台调度
常见问答
问:云平台的算力要花钱吗? 主流平台的公开数据与基础算力都有免费额度,科研与教学通常够用;大规模批量生产、专用算力或商业数据则按量计费。立项时把"云端处理成本"写进预算——它是新出现的成本科目,却是下载整库数据的带宽与存储成本的零头。
问:平台上的数据更新滞后怎么办? 看产品:主流中分辨率产品在主流平台上的入库延迟以天计,多数业务可接受;时效敏感的任务要么申请快数据通道,要么自建接收链路。立项清单里"数据入库延迟"与"业务时效要求"要对表——对不上就该换方案,而不是硬等。
问:云上的处理脚本算资产吗? 算,而且是最容易被低估的资产。数据在平台上人人可取,真正沉淀下来的是"经过验证的处理链":参数、掩膜规则、质量检查、版本记录。把它纳入版本管理与文档体系,团队的积累才不会随人员流动而流失。
要点回顾:规模变了范式就要变,云平台的本质是"数据不动算法动",价值在大输入小输出的任务上兑现;数据立方体是统一网格上的时空规整组织,入库质量决定分析上限;编程姿态从"处理一幅"变为"表达一个集合",把云当快速下载器用是最常见的自我放弃;上云与否按数据体量、数据主权、算力形态、可复现要求四问决策;处理链脚本是团队核心资产,入版本管理;云端准备加本地训练加云端推理是常见混合架构。下一节解决最后一公里——产品如何进入业务系统。
附:上云实践速记卡
速记四条。一、先算输入输出比:大输入小输出才上云,反着来的任务留在本地。二、立方体质量即上限:入库网格、掩膜、时间戳的规整度决定分析上限,用别人的立方体先查它的入库说明。三、脚本即资产:处理链入版本管理,环境与参数随脚本存档,可复现是交付物。四、混合架构画清楚:云端准备、本地训练、云端推理的边界画在架构图上,数据落地节点要明确合规。给预算管理者的提示:云平台的成本模型与买服务器不同——它把成本从"一次性采购"变成"随用量计费",试点期便宜、规模化后要重新算账;按年做成本曲线预测,是项目负责人新的必修课。
延伸:第一次上云的三十天
给准备把项目搬上云的团队一份三十天路线图。第一周做数据侦察:目标数据在平台的入库情况、时间覆盖、掩膜质量、更新延迟,写一页侦察报告。第二周做最小闭环:选一个最小区域把"筛选-计算-导出"跑通,重点验证结果与本地已知结果的一致性。第三周做规模化改造:区域扩到全任务区,处理逻辑改成集合式表达,加上失败重试与断点续跑。第四周做交付与文档:结果抽样人审,脚本入版本管理,处理链文档与成本记录归档。三十天走完,团队对"哪些活适合住在云上"就有了第一手判断——比任何架构评审会更有效,因为每一个判断都有你们自己的数据背书。
附:云端任务成本速算
云端任务的成本速算思路:算力成本约等于"数据规模乘单块处理开销再乘冗余系数";存储成本看中间结果落不落盘——落盘的习惯会让存储费悄悄超过计算费;传输成本只在结果导出与跨区复制时产生,大输入小输出的任务此项可忽略。控制成本的三板斧:空间上先小样本试算再放大、时间上按时段分片断点续跑、数据上裁掉无关波段与区域。把"成本估算"写进方案评审页,是云时代项目负责人的新礼仪——技术可行的方案在预算上翻车,是云端项目最常见的死法。
补一条关于团队协作的云端约定:平台的账户与权限要在项目启动时就规划好——谁可读、谁可写、谁可发布,生产脚本跑在服务账户而不是个人账户下。个人账户离职或转岗带来的资产失联,是云端项目最高频的组织事故;服务账户加代码仓库加交接文档的三件套,能把这类事故的发生率压到接近零。云上的资产形态变了,资产管理的纪律也要跟着换轨道。