3.2 操控与读出:在噪声中打准每一发
3.2 操控与读出:在噪声中打准每一发
本节摘要:门操作是把微波或激光脉冲的能量按面积精确"打"进量子比特,读出是让比特状态以可测的物理量泄露出来。两个方向上误差都在所难免:脉冲过冲导致旋转过头,读出误判让好结果变成坏账本。本节拆解完整链路,并用代码演示脉冲校准与读出混淆矩阵。
一次例行校准的班次记录
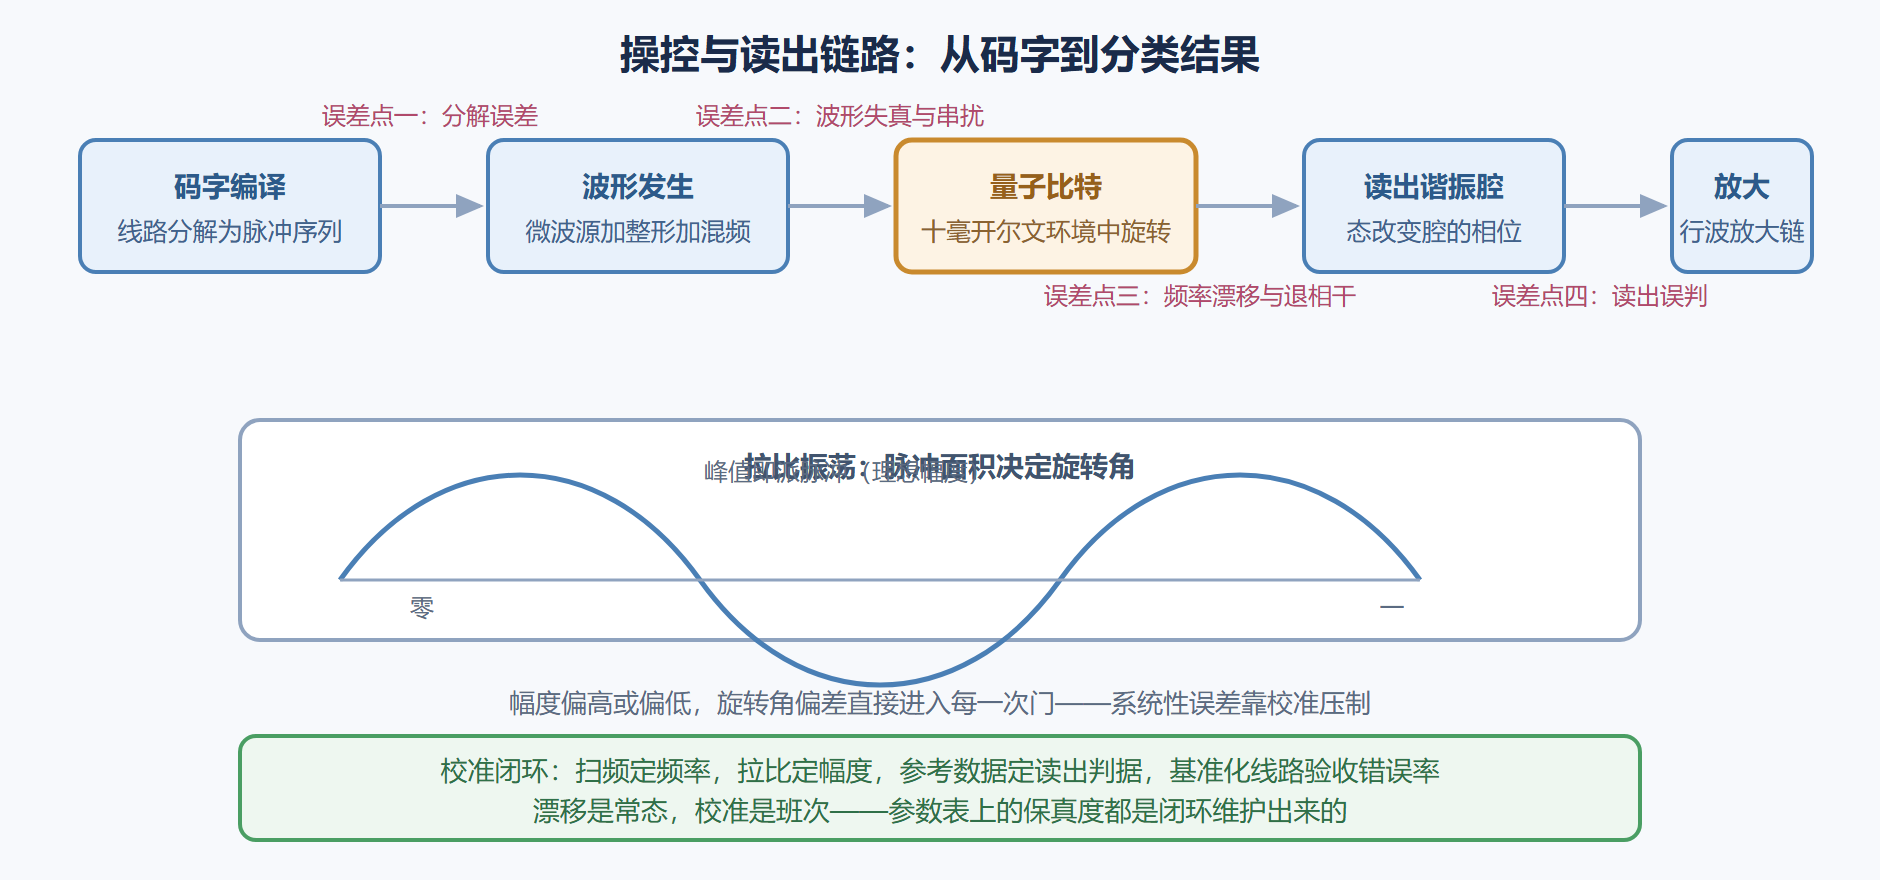
周一早上,某超导实验室的校准班次从这样一份清单开始:先扫频,找到每个比特此刻的共振频率(昨夜温度漂了几毫开尔文,频率跟着挪了);再扫幅度,拉比振荡定出派脉冲的电压;然后测读出判据,用基态与激发态的参考数据重新划分类别边界;最后跑基准化线路,确认门错误率没有超标。四个环节,任何一环漂移超限,今天上机的所有实验数据都会带着系统性偏差。这份清单泄露了一个行业真相:量子比特的操控不是"设好参数就跑"的自动化流程,而是持续与漂移打交道的射击校正——本节讲的正是枪怎么打、靶怎么看、误差怎么记。
一、门操作:把旋转角打到派
以超导平台为例。量子比特被做成一个非线性谐振子,零态与激发态的能级差对应一个特定频率。把一束该频率的微波脉冲照上去,态就会在零与一的布洛赫球经线上来回摆动,摆动频率与脉冲幅度成正比——这就是拉比振荡。脉冲时间乘幅度决定"旋转角":打满一百八十度,态从零转到一(派脉冲,逻辑非门);打九十度,态转到赤道(派除二脉冲,造叠加)。
门操作的全部误差来源可以归拢为三类。频率不准:载波偏离共振,旋转轴倾斜,等效于每次门都掺一点别的门——校准班次第一个扫频动作防的就是它。面积不准:幅度或时长偏差让旋转角过头或不足,派脉冲变一百七十五度,输出态就带着五度的系统性倾斜——高保真器件要求角度误差压到千分之一弧度以下。串扰:瞄准甲比特的脉冲漏到隔壁乙比特,特别是频率相近的比特之间——这推动了可调耦合器、频率排布与脉冲整形(如高斯导数补偿)等一整套消串扰技术。三类的共同点是:误差不是随机的,是系统性的,校准能治;而校准治不了的那部分残余,才是第 2 章账本里的随机错误率。
图 3-2:一次门操作的完整链路与误差注入点
二、读出:让答案在不破坏它的前提下泄露
测量坍缩不可回避(2.2 节的纪律),但好的读出设计能做到"一次提问、高效作答"。超导平台用色散读出:比特与一个微波谐振腔耦合,比特状态不同,腔的共振频率随之偏移;向腔内打入一束探测微波,反射信号的相位随比特状态偏移——测相位,就能反推态,而不必在比特本体上直接耦合能量。读出的误差账本用混淆矩阵记录:真实是零被判成零与一的概率、真实是一被判成零与一的概率。厂商宣传的"读出保真度百分之九十九",说的就是主对角线之和的平均。
读出误差有个容易被低估的战术后果:它不参与纠错码的"门错误率"口径,却在每一轮纠错循环里都要发生一次——表面码每轮都要读出伴随式比特,读出错误率哪怕百分之一,也会被纠错解码器当作"症状噪声"处理,吃掉阈值余量。第 4 章讲表面码时会看到,高性能表面码实验的第一指标常常就是"读出保真度加解码延迟",原因就在这里。
三、演练:拉比校准与读出混淆矩阵
两段代码对应链路的两个环节。第一段模拟拉比振荡并自动寻找派脉冲幅度,这正是校准班次扫幅度环节的原理版;第二段构造读出混淆矩阵,演示"用逆矩阵给坏账本修正"的经典技巧。
# calibrate.py:拉比振荡定派脉冲 + 读出混淆矩阵修正(仅标准库) import math, random # ---- 演练一:扫幅度找派脉冲 ---- def excited_pop(amplitude, t_fixed, rabi_omega_per_amp): """固定脉冲时长,激发态布居随幅度按正弦平方摆动。""" theta = amplitude * rabi_omega_per_amp * t_fixed return math.sin(theta / 2) ** 2 # 模拟一次幅度扫描(理想无噪情形) amps = [0.0, 0.25, 0.5, 0.75, 1.0] pops = [excited_pop(a, 100.0, math.pi / 100.0) for a in amps] for a, p in zip(amps, pops): print(f"幅度 {a:.2f} -> 激发布居 {p:.3f}") # 幅度 1.0 处布居回到 0:再往上找到第一个峰即可定位派脉冲 # ---- 演练二:读出混淆矩阵与逆矩阵修正 ---- # 真实分布 p = (p0, p1),观测分布 q = A p,A 为混淆矩阵 A = [[0.98, 0.03], # 真实 0 被判 0 / 被判 1 [0.02, 0.97]] # 真实 1 被判 0 / 被判 1 det = A[0][0] * A[1][1] - A[0][1] * A[1][0] Ainv = [[A[1][1] / det, -A[0][1] / det], [-A[1][0] / det, A[0][0] / det]] def mat_vec(M, v): return [M[0][0]*v[0] + M[0][1]*v[1], M[1][0]*v[0] + M[1][1]*v[1]] true_p = [0.85, 0.15] # 某线路的真实输出分布 observed = mat_vec(A, true_p) # 读出后的"坏账本" corrected = mat_vec(Ainv, observed) # 逆矩阵修正 print("真实分布: ", [round(x, 4) for x in true_p]) print("观测分布: ", [round(x, 4) for x in observed]) print("修正后分布:", [round(x, 4) for x in corrected])
逆矩阵修正值得多说一句它的适用边界。修正是线性的、确定性的,能把系统性读出偏差从统计结果里"解"出来,变分算法的代价函数几乎都默认做了这一步。但它有两个前提:混淆矩阵要现测现用(它随校准状态漂移),且修正只作用于统计估计、不作用于单次样本——你不能用它"拯救"某一次读出,只能让一万次读出的平均更诚实。把统计修正误当作单样本修复,是初学者最常见的概念滑坡。
四、易错点与工程取舍
链路上还有几个值得记录的坑。第一,脉冲保真度对波形细节极其敏感:方形脉冲的陡峭边沿会激发邻近能级(泄漏到非计算能级),高斯或导数高斯整形能明显压低泄漏,代价是脉冲变长、门变慢——精度与速度的取舍贯穿操控层始终。第二,读出探测功率是双刃剑:功率高信噪比好,但可能把邻近比特的态"照"乱(测量串扰),功率低则误判率上升,最优功率点要按芯片逐点标定。第三,读出与复位的墙钟成本经常超过门:变分算法每轮参数要采集成千上万个样本,每个样本都要走一遍读出加复位,采样成本而非门成本才是这类算法的真实瓶颈——这是第 5 章变分循环设计的先导结论。
本节要点回顾
- 门误差三分法:频率不准、面积不准、串扰,三者都是系统性误差,校准可治,残余才计入随机错误率。
- 拉比振荡是校准之母:扫幅度定派脉冲,扫时长同理,原理一行正弦平方。
- 色散读出是间接测量:态改变腔相位,测相位推态,保真度用混淆矩阵主对角线定义。
- 读出误差单独记账:它不进门错误率口径,却在每轮纠错中重复发生,吃掉阈值余量。
- 逆矩阵修正只救统计不救单样:混淆矩阵现测现用,修正是让平均诚实,不是单点复活。
下一节把链路里的漂移与耗散折算成两条时间常数——T1 与 T2,并给出算法的门预算算法。