6.2 量子化学模拟:防御战的头号战果区
6.2 量子化学模拟:防御战的头号战果区
本节摘要:化学模拟是唯一"防区与地形重合"的优势战线:量子态空间天然就是电子波函数的居所,无需任何编码转换。本节讲清分子怎么被装进量子比特、两条技术路线怎么分工、资源账离实用还有多远,并用可运行代码在沙盘里算出氢分子模型的基态能量。
别以为化学模拟的瓶颈是"算得不够快"
传统量子化学计算的瓶颈常被理解成速度问题,仿佛等机器再快百倍就能解决。真正的困境是结构性的:电子波函数的复杂度随轨道数指数增长,而量子化学恰恰需要精确刻画电子关联——经典方法只能靠截断近似(如限定组态空间、绑定泛函形式)换算力,遇到强关联体系(催化剂活性中心、高能中间体)近似会系统性失真。费曼当年的原始设想正是为此:别用经典机器硬扛指数墙,让量子系统直接演化成你要研究的那个量子系统。这就是"防区与地形重合"的含义——其他战线要把经典问题翻译成量子语言再赚加速,化学战线的问题是原生的:分子本来就是量子对象,量子比特的态空间就是它的居所。防御战的最高目标"让脆弱的量子信息发挥不可替代的作用",在这条战线上最为纯粹。
一、把分子装进量子比特
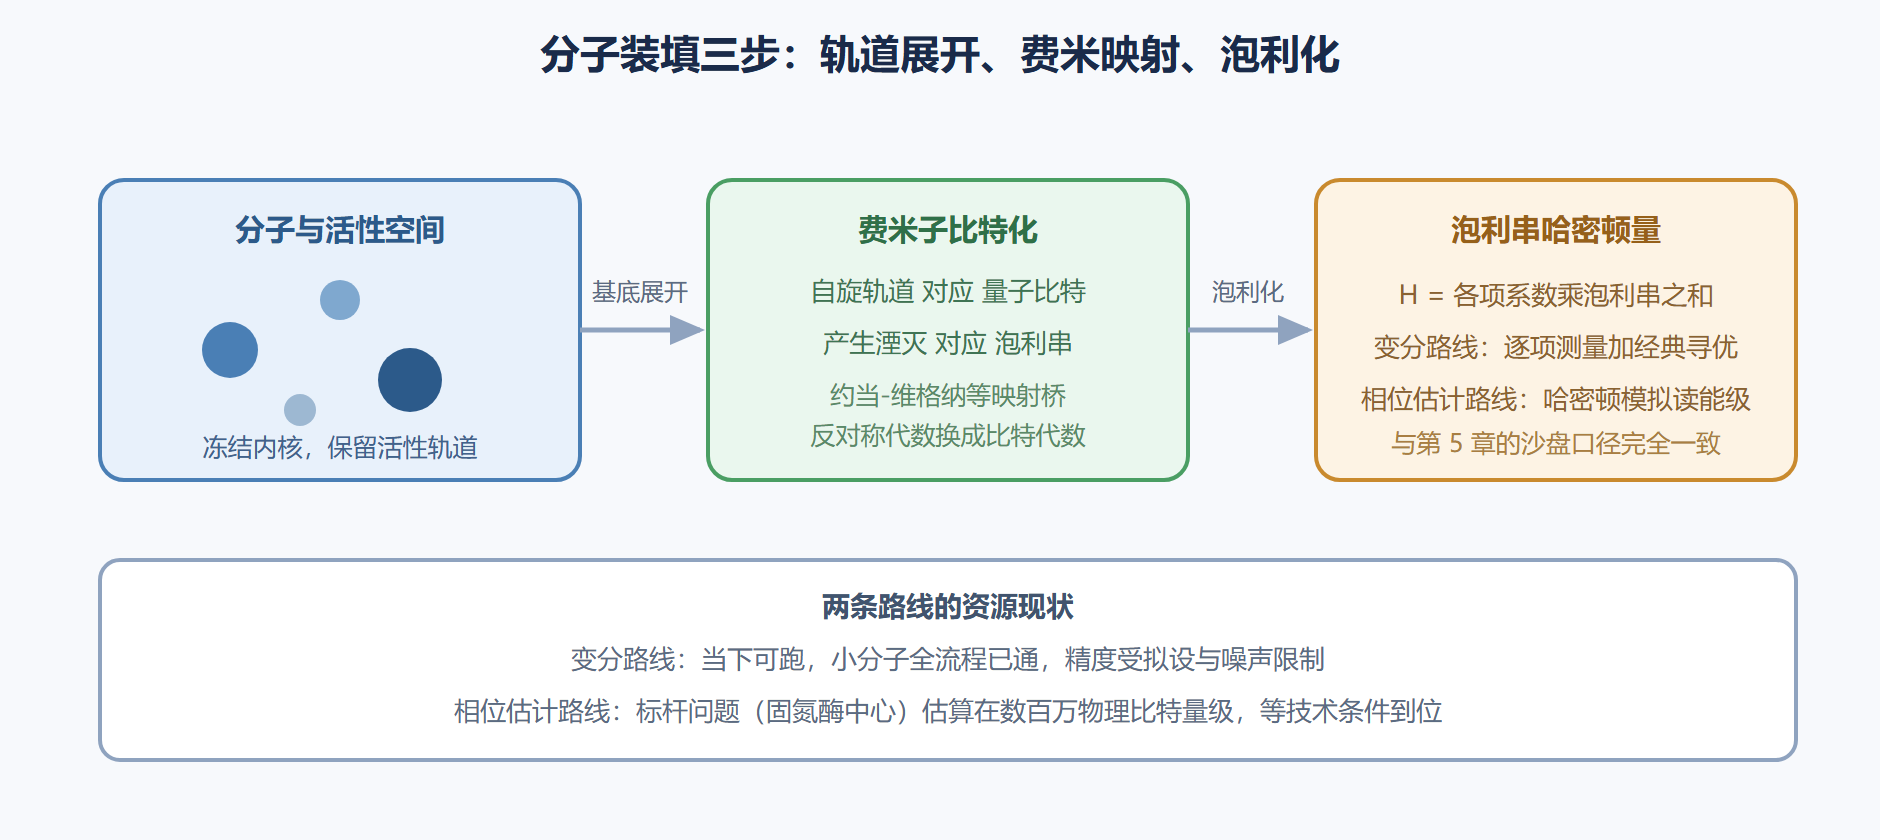
装填流程分三步。第一步,基底展开:把分子轨道表示为一组基函数的组合,冻结内核电子、只保留活性轨道,问题规模从"所有电子"压缩到"活性空间"。第二步,费米子到比特的映射:电子波函数是反对称的费米子波函数,与量子比特在代数上不同构,需要一座翻译桥——约当-维格纳变换是最常用的一座,把每个自旋轨道映射到一个量子比特,费米产生湮灭算符翻译成泡利串。第三步,哈密顿量泡利化:分子的能量算符最终写成泡利串加权和——形如 H = \sum_k c_k P_k,每一项都是第 5 章模拟器能直接处理的算符,也恰好是变分算法逐项测量的口径。三步之后,化学问题变成了标准的量子线路问题。
路线随之分岔成两条。变分路线(5.2 节的 VQE)适合当下:浅线路加经典闭环,已在小分子上跑通全流程,但精度受拟设表达力与采样噪声所限。相位估计路线(5.4 节的发动机)适合容错时代:深度大但精度系统可控,配合哈密顿模拟技术能把大分子的基态能量算到化学精度(约每摩尔千卡量级)——学界反复论证的标杆案例是固氮酶活性中心的费莫可(FeMoco)络合物,经典方法算不准它的反应路径,量子路线的资源估算在数百万物理比特量级:技术上可行、工程上尚远,是整条战线的"北极星"。
图 6-2:从分子到量子线路的装填链路
二、演练:沙盘里算出氢分子的基态
氢分子是化学模拟的果蝇:两个比特就能装下它的最小模型。下面按泡利串口径搭出哈密顿量,用幂迭代法求基态能量——这套系数取自文献中常用的标准参数组,算出的数值可以与量子化学软件的结果直接对账。
# h2toy.py:氢分子最小模型的基态能量(仅标准库) import math, random I2 = [[1, 0], [0, 1]] Z = [[1, 0], [0, -1]] X = [[0, 1], [1, 0]] Y = [[0, -1j], [1j, 0]] def kron(a, b): """2x2 的张量积,返回 4x4。""" return [[a[i//2][j//2] * b[i%2][j%2] for j in range(4)] for i in range(4)] def add(A, B, c=1.0): """累加 c 倍的 B 到 A 上;A 为 None 时表示首次赋值。""" if A is None: return [[c * B[i][j] for j in range(4)] for i in range(4)] return [[A[i][j] + c * B[i][j] for j in range(4)] for i in range(4)] # 文献常用的氢分子标准系数组(哈特里单位) terms = [ (kron(I2, I2), -1.0523), (kron(Z, I2), 0.3979), (kron(I2, Z), -0.3979), (kron(Z, Z), -0.0113), (kron(X, X), 0.1809), ] H = None for M, c in terms: H = add(H, M, c) def apply(H, v): return [sum(H[i][j] * v[j] for j in range(4)) for i in range(4)] def lowest_eigen(H, iters=400, seed=5): """幂迭代求最低本征值:直接迭代只会收敛到模最大的本征对, 故对移位矩阵 B = shift*I - H 迭代,取回 shift - 最大本征值。 shift 取系数绝对值之和(三角不等式保证覆盖整个谱)。""" shift = sum(abs(c) for _, c in terms) B = None for M, c in terms: B = add(B, M, -c) # B = -H for i in range(4): B[i][i] += shift # B = shift*I - H rng = random.Random(seed) v = [rng.uniform(-1, 1) for _ in range(4)] n = math.sqrt(sum(x*x for x in v)) v = [x / n for x in v] lam = 0.0 for _ in range(iters): w = apply(B, v) lam = sum(v[i] * w[i] for i in range(4)) n = math.sqrt(sum(x*x for x in w)) v = [x / n for x in w] return shift - lam e_ground = lowest_eigen(H) print(f"基态能量约 {e_ground:.4f} 哈特里(文献值约 -1.857)")
跑出的数值约在负一点八五哈特里,与文献标准值对上了账。这个几十行的模型浓缩了整条战线的工作流:真实软件做的事完全同构,只是轨道更多、系数由量子化学程序按基底积分算出、泡利串成百上千项。把本节代码与 5.2 节的变分循环拼起来,你就拥有了一套完整的"玩具版 VQE 化学模拟器"——工业框架里的化学模块,抽象层次也就是这样。
三、易错点与战线现状
三个高频误区值得排雷。误区一:把"模拟量子系统"理解成"把分子画出来"。量子模拟产出的是能量、谱与关联函数等可观测量,可视化只是下游包装。误区二:低估映射的代价——约当-维格纳变换的泡利串长度随轨道数增长很快,更紧凑的映射(如分段映射)是当前活跃的优化方向,串数直接决定变分路线的测量成本。误区三:把演示当交付——"已经在量子计算机上算了某某分子"的新闻,分子规模通常在十几个比特量级,精度也未必胜过笔记本上的经典软件;战线的真实位置是"方法链路已通、规模与精度待防线交付",真正的商业兑现挂在第 4 章路线图上。诚实定位这条战线,才能在它兑现前把方法论与人才储备做扎实——这是多数务实团队当前的姿势。
本节要点回顾
- 防区与地形重合:分子是原生量子对象,化学模拟不需要"把经典问题翻译过去"。
- 装填三步走:轨道展开、费米子映射、泡利化,产出与 5 章沙盘同口径的泡利串哈密顿量。
- 两条路线分工:变分路线打当下,相位估计路线打容错时代,FeMoco 是共同的北极星。
- 果蝇模型能对账:两比特氢模型二十行代码算到负一点八五哈特里,与文献值吻合。
- 演示不等于交付:战线现状是链路已通、规模待防线,商业兑现按容错时间表预期。
头号战区之外还有几条外围战线——传感、优化、机器学习,下一节逐一分级盘点它们的真实成色。