3.1 GWAS:刻在基因组里的遗传指纹
3.1 GWAS:刻在基因组里的遗传指纹
本节摘要:全基因组关联研究(GWAS)在人群尺度扫描"哪些变异位点与疾病反复共现"。本节讲曼哈顿图的读法、显著性阈值的由来、连锁不平衡带来的"嫌疑区域效应",以及功能缺失突变这个证据等级最高的指纹。它承接第 2 章勘查主线——勘查锁定嫌疑范围,指纹负责证明嫌疑人"一直在场"。
取证从证据等级最高的痕迹开始。本节在证据链上的位置:它提供的是先于疾病发生的证据——基因组的变异与生俱来,不因患病而改变,天然免疫于"疾病结果冒充疾病原因"的倒因为果问题。这是其他任何组学痕迹都没有的特权。
遗传指纹怎么读
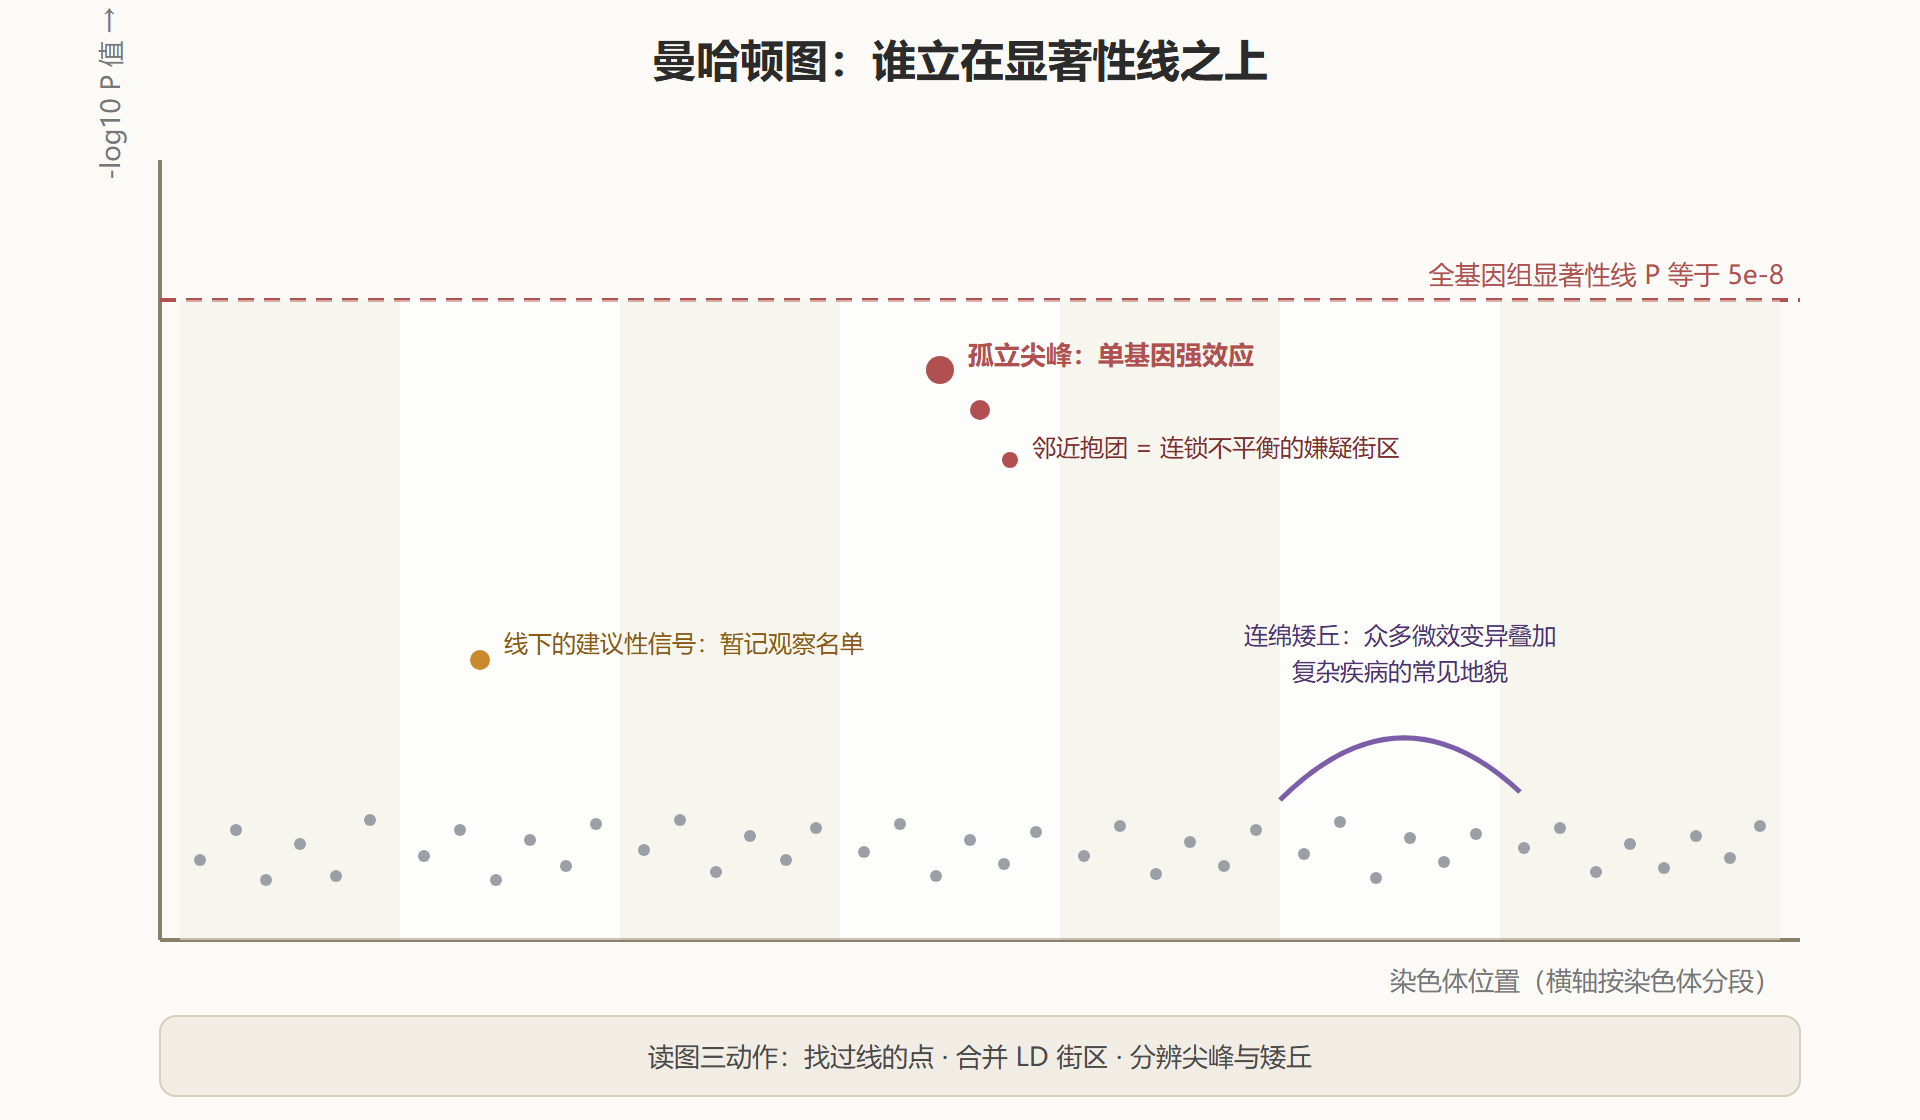
GWAS 的原理平实得像排查:找几千到几十万名患者与健康人,扫全基因组上数以百万计的常见变异位点(以单核苷酸多态为主),逐个检验"携带这个变异的人患病概率是否更高"。检验结果画成曼哈顿图:横轴是染色体坐标,纵轴是负对数 P 值,一个个点立在地平线上,立得越高的位点与疾病关联越强。
图上那条高悬的水平线是全基因组显著性线(常规取 P 小于 5e-8)。这条线的来历值得讲清:每做一个位点就掷一次骰子,全基因组做了几百万次,按纯随机算也会有几十个位点"碰巧"显著——多重检验校正把阈值压到 5e-8,就是为了把这些幸运儿排除掉。读懂这张图还要会三个动作:
- 越过线的点才算嫌疑区域:线下的点大多数是噪声,个别值得结合其他证据关注;
- 嫌疑区域不等于真凶:关联位点是连锁不平衡的产物——致病变异与其邻居在染色体上抱团遗传,统计上"火"的是整片街区。真凶是街区里谁,要靠精细定位与功能证据裁决;
- 看峰形与密度:孤立的尖峰常见于单基因强效应;连绵的矮丘是众多微效变异的总和,复杂疾病大多长这样,这直接决定了"单靶点治愈"期望在复杂疾病上的限度。
# 曼哈顿图数据预处理:从原始检验结果到排序嫌疑清单 import math # 模拟一次 GWAS 的检验输出:位点、染色体位置、P 增值 raw = [ ("rs7626795", 1, 55000000, 3.1e-9), # 某降脂通路位点(示意) ("rs10489402", 1, 120000000, 4.0e-4), ("rs73055948", 4, 75000000, 8.9e-12), ("rs35705950", 11, 110000000, 6.7e-45), # MUC5B 启动子 IPF 经典位点 ("rs2072186", 11, 110001000, 1.2e-40), # 与上面连锁(LD 抱团) ("rs0000001", 19, 49000000, 2.0e-3), ] GW_SIG = 5e-8 # 全基因组显著性阈值 rows = [] for rs, chrom, pos, p in raw: rows.append((rs, chrom, pos, p, -math.log10(p), p < GW_SIG)) rows.sort(key=lambda r: -r[4]) print(f"{'位点':<12}{'染色体':<6}{'位置':<12}{'P值':<12}{'-log10P':<8}{'过线'}") for rs, c, pos, p, nlp, sig in rows: print(f"{rs:<12}{c:<8}{pos:<12}{p:<12.1e}{nlp:<8.1f}{'是' if sig else '否'}") # LD 抱团检验:基因组位置相近且都过线的位点,视为同一嫌疑区域 sig_rows = [r for r in rows if r[5]] regions, last = [], None for r in sorted(sig_rows, key=lambda r: (r[1], r[2])): if last and r[1] == last[1] and r[2] - last[2] < 500000: regions[-1].append(r[0]) else: regions.append([r[0]]) last = r print("\n嫌疑区域合并结果:", regions) # 输出体现:rs35705950 与 rs2072186 合并为同一区域——真凶是街区里的一位
图 3-1:曼哈顿图的读法
指纹的等级:功能缺失突变是证据之王
同样过了显著性线,证据分量可以差出数量级。分水岭在于变异是否改变蛋白功能,以及改变的方向是否与疾病方向自洽。功能获得型突变携带者病更重、功能缺失型突变携带者病更轻且健康无恙——两个方向同时成立时,这个基因在人体里被天然做了"升档"与"降档"两次实验,因果性、方向性、安全性三类信息一次到齐。1.2 节的 PCSK9 就是这类指纹的标准样本:功能获得突变家族病重(2003 年发现),功能缺失携带者 LDL 低、冠心病风险降四成上下且其他指标无恙(2005 年前后报道)。立项文书里写"抑制 PCSK9 的安全边际已在人体预演过十年",指的就是这段历史。
反方向的教训同样有名:载脂蛋白 A1(APOA1)的功能缺失突变让携带者 HDL 极低,却未见心血管风险升高——这条指纹早在托彻普立项前就已发表,遗憾的是没有参与决策。指纹是公开的,读不读、信不信,是取证纪律问题。
从指纹到机制:三条补强路线
关联位点落在基因组的荒漠地带(绝大多数显著位点不在蛋白编码区)时,需要三条补强路线把"街区"收敛到"门牌":
- eQTL 与共定位:检验同一区域的变异是否也影响某个基因的表达量,并检验"疾病关联"与"表达关联"是否由同一个变异驱动——共定位成立,嫌疑收敛到那个表达被调控的基因;
- 精细定位:用更高密度的基因分型与统计置信集把区域内的候选变异按后概率排序;
- 队列表型深挖:生物样本库里变异携带者的中间表型(血脂、蛋白组读数)能直接指认通路——蛋白数量性状位点(pQTL)由此成为药物基因组学最热的取证方向。
⚠️ 常见坑:把 GWAS 位点最近的一个基因直接当靶标。关联信号与最近基因常常不是一回事,机制上真正被调控的基因可能在一百万碱基之外。凡此种种,要靠 eQTL、染色质图谱与实验裁决。
取证的常见疑问
队列规模上不去,指纹还信得过吗?
看效应量与场景。常见变异的小效应需要超大样本才过得了显著性线,样本不足时指纹确实读不出来;但家族性、高外显率的罕见变异(功能缺失突变多属此类)在小队列里也能检出。所以小队列项目有专属的取证策略:放弃全景扫描,聚焦候选通路基因的罕见变异富集检验——扫不动全基因组,还查得起嫌疑人家族。
人群分层是怎么污染指纹的?
经典案例:某变异在人群甲里频率高,而人群甲恰好因饮食结构心血管风险低,统计上就成了"保护变异"。这不是生物学,是人群结构与环境的巧合。治理手段是祖先背景校正、混合人群分层分析,以及最硬的一条:在另一批独立人群里复测。指纹取证里"跨人群复现"的权重,怎么强调都不过分。
遗传指纹会不会冤枉"搭车的基因"?
会的,而且这是全链条最常见的冤案形态。关联区域里的基因远不止一个,"最近的基因"未必是被调控的基因——历史上不乏真凶藏在关联峰几百kb之外、靠染色质成环远程调控的案例。所以 3.1 的证据链必须在 eQTL、染色质图谱与功能实验的交叉验证下闭合,任何一步偷懒都可能把无辜者写进立项文书。
指纹档案的用法提示
给立项文书引用指纹证据时,有几条行规让报告更耐质询。引用关联位点时附上效应量与方向(只报 P 值不报效应,读者无法判断生物学意义);引用功能缺失突变时附上携带频率与表型来源(大人群生物库与临床家系的证据权重不同);引用共定位时附上所用参考数据的组织来源(eQTL 的组织选错,共定位结论可以直接反转)。指纹是全链条里最贵重的证据,也最经不起二手转述——引用时多带一行出处,评审时少答十分钟质询。
最后提醒一个检索习惯:指纹证据的检索范围要刻意覆盖"阴性结果"。一个基因的功能缺失突变在多个队列里查无此人对疾病无影响,这同样是证据——阴性证据能阻止项目在错误方向上空转,而发表偏倚让它天然难找,不主动检索就会漏。
办案手记(要点回顾)
- GWAS 提供先于疾病的证据,天然免疫于倒因为果,是取证序列的第一站;
- 5e-8 阈值来自全基因组多重检验校正;线下信号进观察名单,线上信号才立案;
- 关联位点是连锁不平衡圈出的嫌疑街区,真凶要靠精细定位与功能证据裁决;
- 功能缺失突变的"低患病率且健康"是人类预演过的安全性证据,等级高于一切组学关联;
- eQTL 共定位、精细定位、pQTL 表型三条路线把街区收敛成门牌;
- 下一站 3.2:从遗传的"出厂配置"转向疾病当下的"活动记录"。