3.2 转录组差异表达:谁在现场异常活跃
3.2 转录组差异表达:谁在现场异常活跃
本节摘要:GWAS 看出厂配置,转录组看犯罪现场的活动记录。本节讲差异表达的统计逻辑与一段可运行的演算、bulk 与单细胞两种分辨率的分工、批次效应这个最常见的取证污染源,并把组织特异性分析(安全窗口的地基)并入本节。它承接 3.1 的指纹取证,为 3.3 的蛋白网络取证提供重点名单。
遗传指纹证明嫌疑人"生来与这案子有关",转录痕迹证明他"案发时确实在活动"。本节是证据链上承前启后的一环:向上用人群数据检验勘查报告,向下给蛋白网络取证圈定重点名单。
谁在现场异常活跃
RNA 测序把组织里的转录产物定量成计数矩阵:行是基因,列是样本。差异表达分析在两组样本(患者对对照)之间逐基因检验表达差异,产出三列核心读数——对数倍数变化(log2FC,变化的方向与幅度)、P 值(差异是否超出随机)、校正后显著性。听起来直白,做对不易,逐列说:
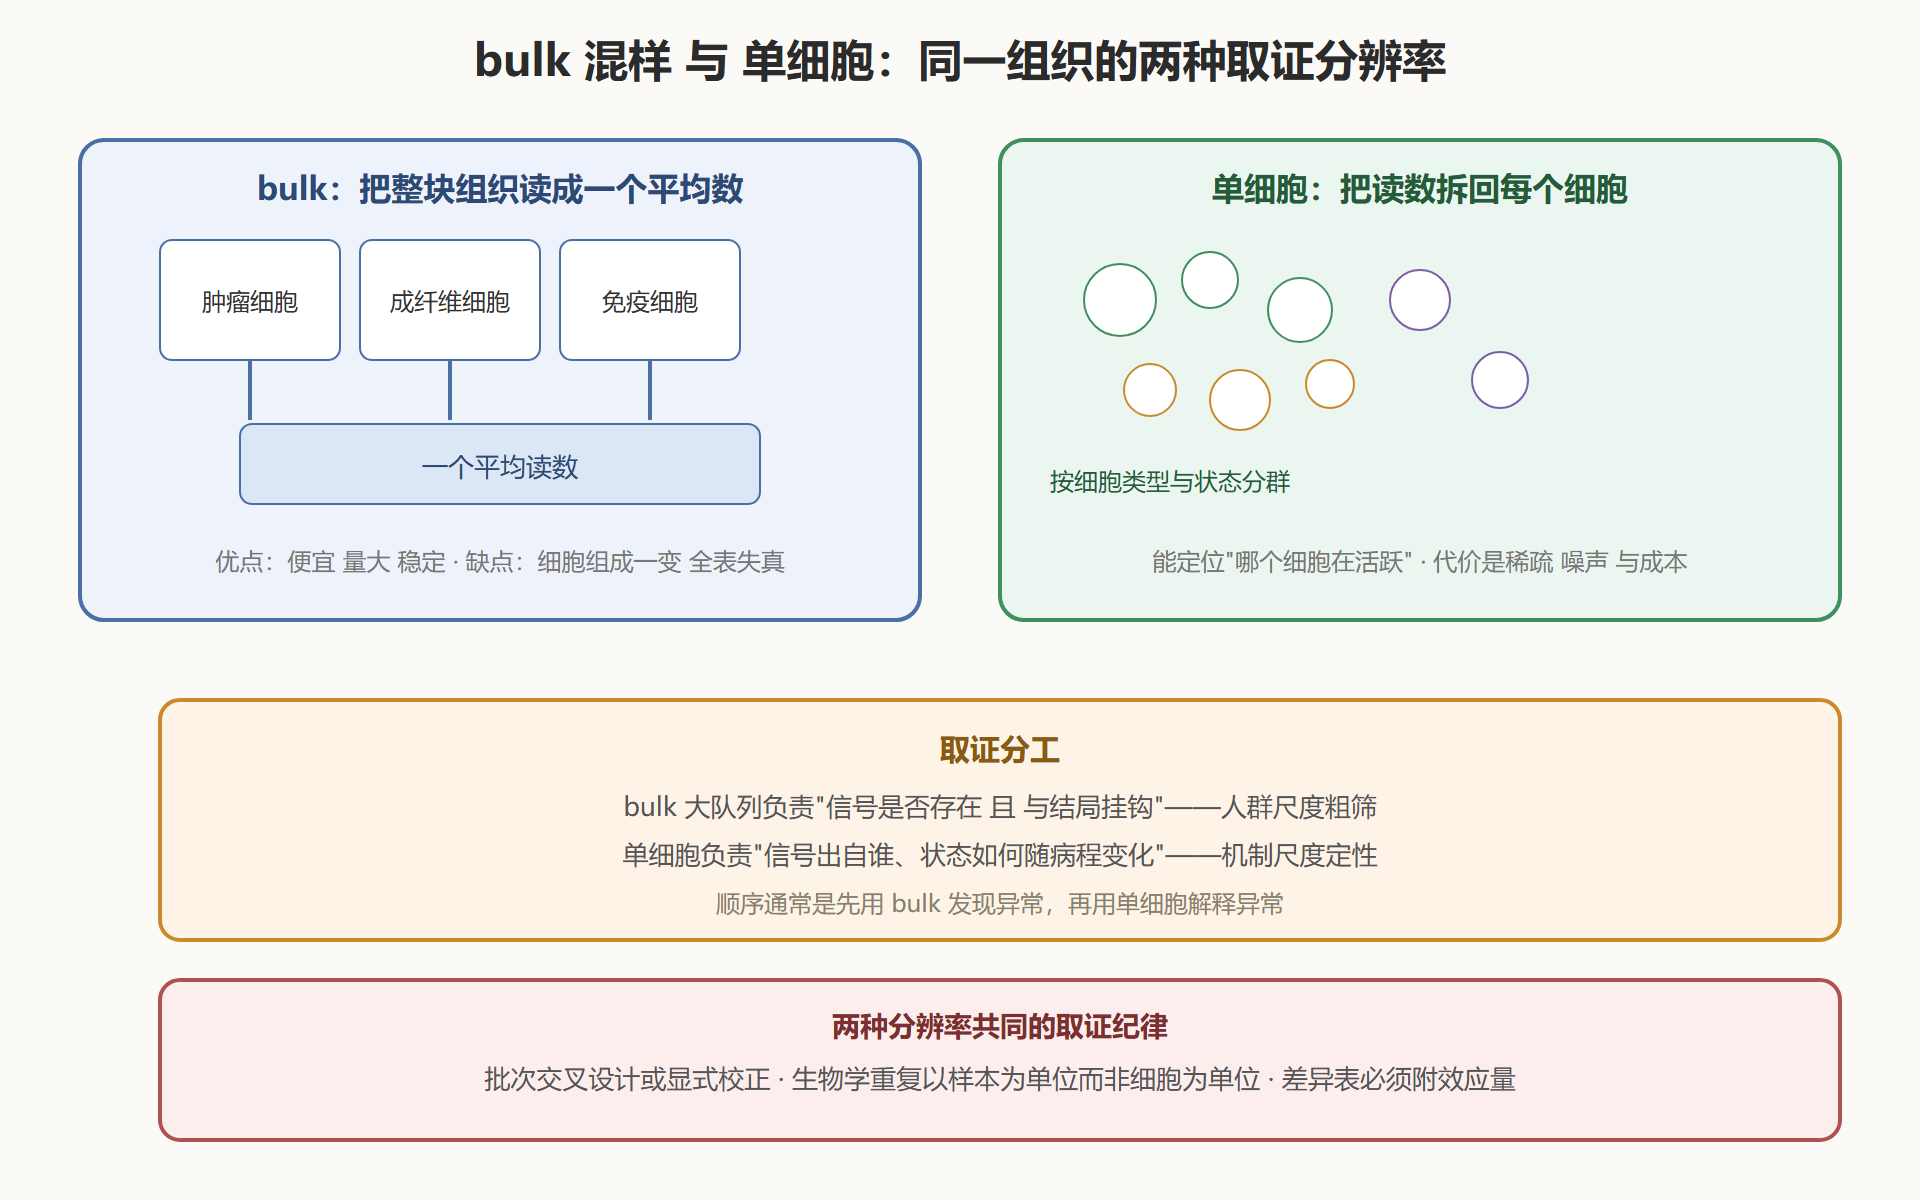
log2FC 的可解读性是最容易被高估的。它是"平均而言高了多少",不含"哪些细胞高"。肿瘤组织里免疫细胞浸润多的样本,免疫基因整体上调——读数巨大,但那是细胞组成变了,不是任何细胞真的调高了哪个基因。这个现象叫细胞组成混淆,是 bulk 转录组取证的头号陷阱。
统计模型要跟计数分布走。测序计数是稀疏的、过离散的,用普通检验会大量假阳性,主流工具(DESeq2、edgeR 一族)用负二项分布建模。理解到"选模型是为了让方差估计诚实"这个层面就够用,不必陷入分布推导。
批次效应必须显式处理。患者样本常与对照样本在不同日期、不同建库批次处理,批次的系统性偏移可以比真实生物学信号还大。取证纪律:对照与患者交叉分布在不同批次里(设计阶段),或事后用统计方法校正(分析阶段)——两道工序至少做一道,且要在报告里写明。没写批次处理的差异表达表,审阅时可以直接扔回去。
下面的演算把这套逻辑压缩到可以直接跑:两组建库批次、六对样本、几个基因的计数,完整走一遍归一化、检验、多重校正与嫌疑排序。
# 差异表达玩具演算:归一化 -> 检验 -> 多重校正 -> 嫌疑排序 import math, random random.seed(7) genes = ["MUC5B", "COL1A1", "ACTB", "GAPDH", "CXCL8", "WNT2"] # 计数矩阵:患者 6 例 与 对照 6 例(刻意让批次 1/2 交叉覆盖两组) counts = { # 基因: [病1,病2,病3,病4,病5,病6, 对1,对2,对3,对4,对5,对6] "MUC5B": [5200,6100,4900,5800,6400,5100, 300,260,340,280,320,300], "COL1A1":[18000,21000,17500,20000,22000,19000, 9500,8800,9900,9100,9600,9300], "ACTB": [50000,52000,48000,51000,53000,49500, 51000,49000,50000,52000,48000,50500], "GAPDH": [61000,59000,63000,60000,58000,62000, 59000,61000,60000,62000,61500,60500], "CXCL8": [2100,900,2600,1200,2400,1500, 800,2200,700,1900,1000,2100], # 阵发信号 "WNT2": [900,1100,950,1050,1150,900, 850,950,900,1000,880,960], } # 库内归一化:按每样本总计数缩放到中位深度(简化版 CPM) totals = [sum(counts[g][i] for g in genes) for i in range(12)] target = sorted(totals)[6] # 中位深度 norm = {g: [counts[g][i]/totals[i]*target for i in range(12)] for g in genes} def log2fc_and_t(vals): # 极简检验:两组均值差 + 合并方差 t 统计量 a, b = vals[:6], vals[6:] ma, mb = sum(a)/6, sum(b)/6 var = (sum((x-ma)**2 for x in a) + sum((x-mb)**2 for x in b)) / 10 se = math.sqrt(var/6 + var/6) t = (ma - mb) / se if se else float("inf") return math.log2((ma+1)/(mb+1)), t print(f"{'基因':<8}{'log2FC':>8}{'t值':>9} 嫌疑注记") notes = {"ACTB": "管家基因 阴性对照", "GAPDH": "管家基因 阴性对照", "CXCL8": "方差方向矛盾 警惕细胞组成混淆"} suspects = [] for g in genes: fc, t = log2fc_and_t(norm[g]) tag = notes.get(g, "") print(f"{g:<8}{fc:>8.2f}{t:>9.1f} {tag}") if abs(fc) > 1 and t > 4: suspects.append((g, fc)) print("\n过线嫌疑:", [g for g, _ in suspects]) # 输出:MUC5B 与 COL1A1 强烈上调过线;CXCL8 因方向矛盾被卡掉; # 管家基因纹丝不动,说明归一化没有引入系统性偏移。
图 3-2:bulk 与单细胞两种取证分辨率
组织特异性:同一张表,另一种读法
同一份表达数据,换个方向读就是安全评估。把候选靶标的表达谱放到正常组织的全景里(GTEx 一类正常组织图谱干的就是这件事):一个只在病变组织高表达、正常组织几乎沉默的基因,干预的安全窗口天然宽;一个心肌与骨骼肌普遍高表达的激酶,即使与疾病因果相关,抑制它也要提防心脏与肌肉毒性。1.4 预审里"组织分布"那一栏,证据就来自这里——取证阶段顺手把它补齐,后面验证阶段能省一次返工。
单细胞分辨率把这个分析又推进一层:同一个基因在正常组织与病变组织的表达可以集中在完全不同的细胞亚群上(比如某检查点分子只在活化 T 细胞、而不在静息 T 细胞上高表达),干预策略与安全监测标志物都随之确定。
易错点:把阵发当常态
转录痕迹是瞬时读数:细胞因子类的基因表达阵发剧烈,取样时刻决定读数。一个样本里 CXCL8 忽高忽低,可能反映病程波动,也可能只是取材时间差。对付阵发信号的办法是把取证从"单时点快照"升级为"多时点、多区域采样",并用方差结构检验(而不是只看均值差)判断信号稳定性——上面演算里 CXCL8 被卡掉,演示的就是这个动作。
💡 关键直觉:bulk 告诉你"平均在场",单细胞告诉你"谁在场、穿什么衣服"。取证报告里两者顺序通常是先粗后细,不要跳步。
组织剖面:安全窗口的另一半证据
差异表达沿疾病对照方向读是找嫌疑,沿正常组织方向读就是安全评估。把候选基因放进正常组织的表达全景,两种剖面立刻分出高下:只在病变组织活跃、正常组织沉默的候选,干预窗口天然宽;在心肌、肝脏、中枢普遍活跃的候选,即便因果证据过硬,安全设计也要提前进场。这两种读法用的是同一份数据,成本差几乎为零——取证阶段顺手完成,是全流程里性价比最高的一笔。
单细胞分辨率进一步把安全剖面做到亚群级:同一个基因在正常组织与病变组织由完全不同的细胞亚群表达时(例如某受体只在病变部位的成纤维细胞亚群高表达,而正常组织里对应的静息亚群不表达),不仅安全窗口变宽,连"怎么监测脱靶毒性"的读数都一并给出了。立项文书里的组织风险栏,证据应当具体到这个颗粒度。
取证的常见疑问
样本量多少才够差异表达取证?
没有魔法数字,但有结构性要求:每组至少若干例生物学重复(以样本为单位,不是以细胞或技术重复为单位),且组内变异越大的疾病越要多收。判断标准可以直接看统计功效——主信号的标准误随样本量收敛的速度,比任何经验法则都可靠。预算有限时,与其减样本量,不如收窄问题(分型后取单一亚型做对照),分层本身就是降噪。
单细胞数据能直接进加权证据表吗?
能,但要把读数形态写对。单细胞的优势读数是"哪些细胞类型承载了信号"与"状态转移的方向",而不是简单的组间均值差;把单细胞硬算成伪 bulk 再去比倍数,等于花钱买了显微镜只用来看总数。规范用法:bulk 队列给倍数与显著性,单细胞给定位与机制解释,两行分开记。
差异表达的重现性差怎么办?
先查技术层(批次、建库方式、测序深度是否一致),再查设计层(对照是否匹配、取样时点是否统一),最后才怀疑生物学。多数"重现性差"的案子,元凶是样本分层不一致——患者群里的亚型混在一起,均值被稀释。解决手段是先分型再比较,让每一层内部的对比都有意义。
证据入表的方式
转录证据进加权证据表时,建议拆成三行分开记:疾病对照的差异(log2FC、显著性、队列规模)、细胞来源定位(单细胞确认的承载亚群)、组织剖面(正常组织分布与安全含义)。三行对应三种不同的下游用途——排序算法吃第一行,机制解读吃第二行,安全评估吃第三行。混成一行"转录证据强/弱",等于把三种口径的信息压扁,排序时会系统性高估或低估。
办案手记(要点回顾)
- 转录组是活动记录,证据等级低于遗传指纹,但胜在样本量大、可与结局挂钩;
- log2FC 不含细胞组成信息,bulk 取证的头号陷阱是细胞组成混淆;
- 负二项模型让方差估计诚实;批次必须设计阶段交叉或分析阶段校正,且写进报告;
- 管家基因的稳定性是归一化质量的免费质控;
- 组织特异性读法给安全窗口供料,单细胞把安全分析推进到亚群分辨率;
- 阵发信号要靠多时点与方差检验定性,下一站 3.3 把痕迹换算到蛋白与网络。