7.2 人工智能与大数据应用
7.2 人工智能与大数据应用
本节摘要:人工智能与大数据正重新定义"精准麻醉"的内涵——从依赖经验的艺术走向基于海量证据、动态优化、个性化定制的科学工程。本节从麻醉数据的高维度、异构性与时序性讲起,拆解规则引擎、机器学习、深度学习三种技术路径,覆盖围术期风险预测、实时生理调控、智能麻醉记录、手术进程预测、教育训练五大应用场景,最后直面数据隐私、责任归属与人机协同哲学。
本节导读
阅读完本节,你应当能够:
- 理解麻醉大数据的"高维度、异构性、时序连续性"特征
- 对比规则引擎、机器学习、深度学习的适用边界
- 说出 AI 在麻醉五大应用场景的现状与证据
- 理解校准性与 SHAP 可解释性对临床信任的重要性
- 认识数据隐私与责任归属的现实挑战
一、问题与直觉
一次常规手术可能产生超过百万条数据点:心电图波形采样每秒 500 次以上、血压连续监测值、EtCO₂ 曲线、BIS 动态轨迹、药物输注速率、体位调整时间戳……这些数据构成一个复杂的多模态时空序列。
人类麻醉医师的信息处理能力存在瓶颈——几十项实时参数、上百页病历、影像、检验结果。而 AI 的优势恰恰在模式识别与跨维度关联分析。Google Health 团队开发的风险评估模型,通过对数百万例手术记录的学习,能在术前预测急性肾损伤风险,AUC 达 0.89,显著优于传统评分系统。
但 AI 不是来"取代医生"的。正如一位同行说的:"我们不需要会插管的机器人,我们需要的是能让我们少犯错的'超级助手'。" 这一定位,决定了 AI 在麻醉学的发展方向是增强智能(Intelligence Augmentation)而非替代智能。
二、核心原理
二、核心原理
AI 驱动的麻醉决策链
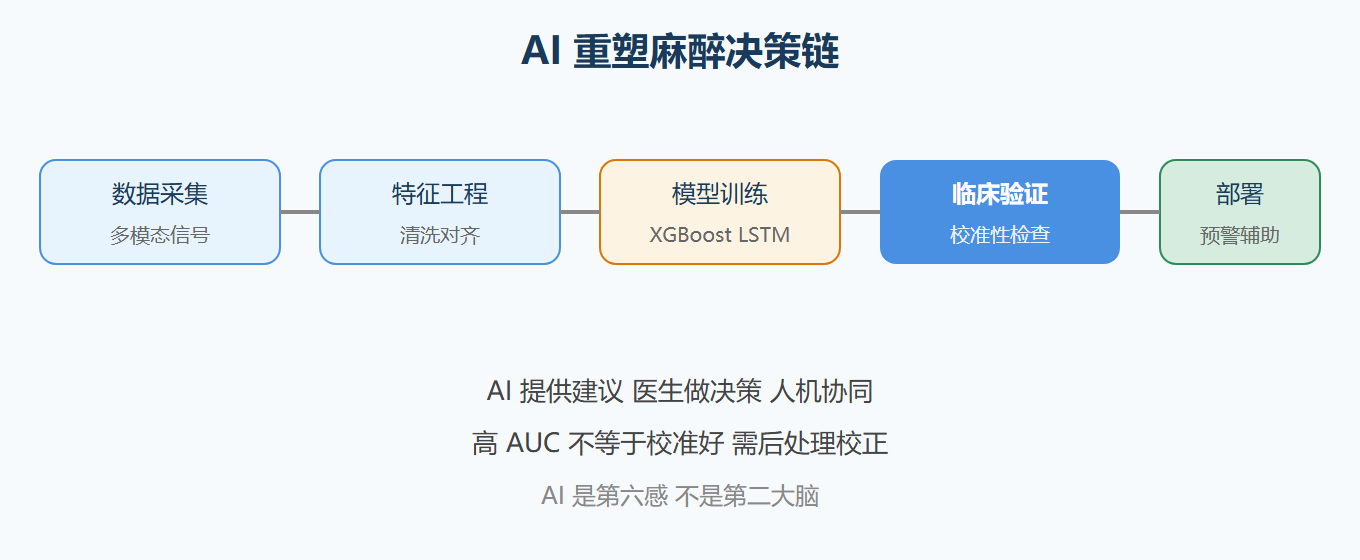
数据驱动的麻醉新范式
所谓"大数据"在麻醉语境下,不仅指数据量大,更重要的是高维度性(多信号源)、异构性(结构化+非结构化)与时序连续性。以术后谵妄(POD)预测为例:过去研究多局限于单一变量,而基于电子病历的回顾性队列通过 NLP 提取非结构化文本、结合结构化生命体征,构建包含 127 个潜在预测因子的数据集。用 XGBoost 特征选择后发现,"夜间手术开始时间""术中低血压累积时长""麻醉深度波动频率"三者组合具有极强独立预测能力(AUC=0.86)——看似无关的操作细节,隐含着深层病理生理关联。
三大技术路径
规则引擎与知识图谱:最早用 IF-THEN 逻辑将指南转成可执行代码("若 MAP<60 且 SVV>12%,建议扩容"),透明性强、易解释。但真实世界矛盾信号(MAP 正常但乳酸升高)会让规则系统陷入僵局。新一代引入医学知识图谱(GNN),输入"患者服用利福平"可自动推导其诱导 CYP3A4 增强、加速芬太尼代谢、提示上调阿片剂量——端到端知识推理。
机器学习:随机森林、SVM 在处理噪声数据与非线性关系方面更强。以困难气道预测为例,一项纳入 12,843 例患者的研究比较七种模型,梯度提升树综合性能最优(AUC 0.91 vs 传统 LEMON 法则 0.68),关键改进在于捕捉高阶交互效应——"肥胖+颈围粗+打鼾史"共现时风险指数级增长而非简单相加。但所有模型都面临校准性挑战:即使区分能力强(高 AUC),输出概率也可能偏离真实发生率,需 Platt Scaling 或 Isotonic Regression 后处理校正;SHAP 值分析让"为什么判为高危"可视化可理解。
深度学习:LSTM 与 Transformer 在处理时间序列方面有革命性潜力。端到端 EEG 分析框架(小波变换分解频段→双向 LSTM)在公开数据集上预测意识消失/恢复时刻与行为学金标准相关系数 r=0.89,优于商用设备(r=0.76)。Google Health 的"Anesthesia Transformer"把生命体征流视为"生理句子",预训练后能提前 3.2 分钟预警严重低血压(灵敏度 88%、特异度 91%)。
三、工程实践要点
五大应用场景
围术期风险预测:动态风险计算器整合基因组、微生物组与社会决定因素,生成个性化风险剖面。某三级医院实施后高危患者术前优化干预率提升 47%、术后并发症下降 29%。
实时生理调控:闭环控制系统是 AI 介入最深的领域。Propofol-Hypnosis Control Loop 三模块(感知、控制、执行),PID 调控下 AI 组 BIS 稳定性达标时间占比 89%(人工 67%),药物总用量减少约 18%。
智能麻醉记录:语音识别+NLP 让医生口述"诱导用药:咪达唑仑 2mg、舒芬太尼 20μg、丙泊酚 150mg"自动解析填入结构化字段;语义理解识别"准备插管"即触发气道管理 check-list 弹窗。
手术进程预测:LSTM 分析历史手术时长、团队习惯、器械节奏,预测剩余手术时间误差中位数由人工 ±38 分钟降至 ±14 分钟。
教育与模拟训练:VR 平台嵌入 AI 导师,通过力反馈捕捉针尖轨迹、计算穿刺角度偏差、AR 标出最佳进针路径。接受 AI 指导的住院医师首次成功率提高 35%。
| 场景 | 代表技术 | 核心证据 |
|---|---|---|
| 风险预测 | XGBoost/NLP | POD 预测 AUC 0.86 |
| 生理调控 | PID 闭环 | 药物总用量减 18% |
| 智能记录 | 语音+NLP | 自动结构化+触发提醒 |
| 进程预测 | LSTM | 误差从 ±38 到 ±14 分钟 |
| 教育训练 | VR+力反馈 | 首次成功率提 35% |
⚠️ 常见坑:把模型"区分能力"当成"预测准确性"直接用于临床。高 AUC 不等于校准好——模型判断"这人 30% 概率出问题",实际可能是 15% 或 60%。未经校准性校正的模型,会在高风险阈值附近做出一堆错误决策。
💡 关键直觉:AI 的定位是"第六感"不是"第二大脑"。就像导航系统不会让司机失业,反而让他更专注路况——AI 帮麻醉医师在信息洪流中保持清醒决策,但方向盘永远在医生手里。
伦理困境与人机协同
责任归属:当 AI 建议用药导致过敏反应,责任在开发者、医院还是采纳建议的医生?现行法律框架尚未明确界定。数据隐私:麻醉涉及大量敏感信息,跨机构数据共享受 GDPR、HIPAA 限制。联邦学习(Federated Learning)提供解决思路——各医院本地训练、仅上传参数更新而非原始数据,在保护隐私前提下实现知识聚合。人机协同哲学:理想状态是形成"增强智能"——AI 成为麻醉医师的延伸感官与冷静顾问,医生专注于价值判断、情感沟通与最终决策。
未来五年展望:基于数字孪生的个体化生理仿真、集成代谢组学与药代模型的精准给药平台、具备自主学习能力的通用麻醉代理。那时的手术室或许如科幻电影——灯光柔和、机器轻语、人类医者静坐一旁,手握最终决定权。
AI 预测"低血压要来了",你敢照单全收吗?
AI 提前 15 分钟预测低血压听起来很美好,但临床落地时有个现实的信任问题:假阳性率。如果系统 10 次预警里有 6 次是假的,医师要么过度干预(白白给药、增加负担),要么产生"警报疲劳"选择性忽略——真警报来了反而错过。所以引入 AI 预警不是"装上就完事",而是要与临床流程磨合:调整阈值到可接受的假阳性水平、与现有监护系统集成、更重要的是把预警当成"提醒你去复查患者"的线索而非"自动执行方案"的命令。AI 的输出是概率,临床的判断是决策——这个边界不划清,再准的模型也落不了地。
麻醉记录"自动生成"后,医生还要记什么?
语音识别加 NLP 让麻醉记录越来越自动化,这是解放双手的好事,但有个被忽视的问题:机器记录的是"发生了什么",人记录的是"为什么这样做"。比如"诱导后血压下降,予去甲肾上腺素",机器能自动填入药物和剂量,但"为什么判断是容量不足而非心衰""为什么选去甲肾上腺素而不是麻黄碱"这类临床推理,机器不会替你写。而恰恰是这些推理,构成了医疗文书的灵魂,也是日后复盘、质控、法律辩护的核心依据。自动记录负责"事实",医师负责"逻辑"——把决策思路写进记录,才是对患者和对自己真正的负责。
麻醉 AI 的"数据"从哪里来?可靠性如何保证?
AI 模型的质量由数据决定。麻醉数据的来源很杂:监护仪波形、麻醉记录单、电子病历、影像报告,每个来源的完整性和准确性都不同。常见问题包括:手写记录数字化后的缺漏、不同品牌监护仪参数口径不一、关键事件(如给药时间)记录偏差。如果 AI 是在有偏差的数据上训练的,它的输出也会带偏——这就是"垃圾进,垃圾出"。所以评估一个麻醉 AI 产品时,要问的不是"准确率多高",而是"训练数据从哪来、覆盖了哪些人群、有没有在你的科室环境里验证过"。数据质量是 AI 的命门,比算法本身更值得关注。
用了 AI 之后,"医生的经验"还有价值吗?
这是很多麻醉医师心里的疑问。一个有意思的答案是:AI 越普及,医生的临床经验反而越值钱——因为 AI 处理的是"标准场景",而医学永远有"非标准场景":罕见并发症、多病共存、设备故障、伦理冲突。这些时刻没有任何算法能替代临床判断。另外,AI 的模型训练需要大量标注数据,而"标注"本身就需要资深麻醉医师的经验来定义"什么是正确"。医生不是在和 AI 竞争,而是在给它"喂经验"、也为它"兜底"——人机协同的未来,恰恰让"有经验的人"更稀缺。
"AI 推荐了方案,我照做就行"对吗?
AI 的推荐(用药建议、风险评分、通气参数)应该被当作"知情同意的第二意见",而不是"无需思考的执行指令"。理由有三:一是模型的训练数据可能不覆盖眼前这位患者的特殊情况;二是推荐的临床逻辑不一定符合当前的诊疗环境与资源条件;三是过度依赖会侵蚀医生自己的判断力——长期"照做",遇到 AI 失灵或数据异常时会不知所措。成熟的用法是"AI 给选项,医生做选择":理解推荐背后的逻辑,评估它在本病例的适用性,必要时调整或否决。把 AI 当"会说话的参考书"而不是"会做事的上级",是对患者负责,也是对自己负责。
温故知新
- 麻醉数据是时空序列:百万级数据点,高维异构时序
- 规则引擎透明但僵化:知识图谱实现端到端推理
- 梯度提升树预测困难气道 AUC 0.91:捕捉高阶交互效应
- 校准性比区分能力更要命:高 AUC 不等于准概率,需后处理校正
- SHAP 让黑箱可解释:"为什么判高危"可视化
- 智能记录解放双手:口述即结构化+语义触发 check-list
- 联邦学习保隐私:只上传参数不传数据
- AI 是第六感不是第二大脑:人机协同,方向盘在医生手里
下一节从"决策智能化"走向"工具创新化":转化医学与新型药物研发——从实验室到手术台,新一代麻醉药如何改变治疗格局。
速查与实例核算
模型评估三件套的核算与数据泄露自查。
# 二分类预警模型评估(低血压预测示例) TP, FP, FN, TN = 81, 19, 9, 891 sens = TP / (TP + FN); ppv = TP / (TP + FP) print(f"灵敏度 {sens:.0%}、阳性预测值 {ppv:.0%}") print("低血压低发病率场景:宁可牺牲 PPV 保灵敏度(漏报代价高)")
AI 模型上线路径与数据泄露自查 -------------------------------- 数据:时间切分(禁随机切分!)、跨中心外部验证 指标:区分度 AUC + 校准曲线 + 决策曲线(DCA)三件套 公平性:子组(年龄/性别/术种)AUC 差<0.05 落地:影子模式跑 3 个月 → 医生可覆盖 → 不做全自动决策