4.1 参数化与数据驱动
4.1 参数化与数据驱动
本节摘要:真实用户不会都用同样的数据登录。本节讲用 CSV 数据文件做参数化,让每个虚拟用户用不同数据——贴近真实场景。
学习目标
阅读完本节,你应当能够:
- 配置 CSV 数据文件
- 用变量引用参数化请求
- 处理数据共享和循环
概念脉络
一、为什么需要参数化
不参数化:100 个虚拟用户都用 user1/123456 登录——服务器可能缓存命中、可能因重复登录被拒,测不出真实性能。参数化让每个用户用不同账号,贴近真实。
二、CSV 数据文件设置
图 4-1 参数化数据驱动
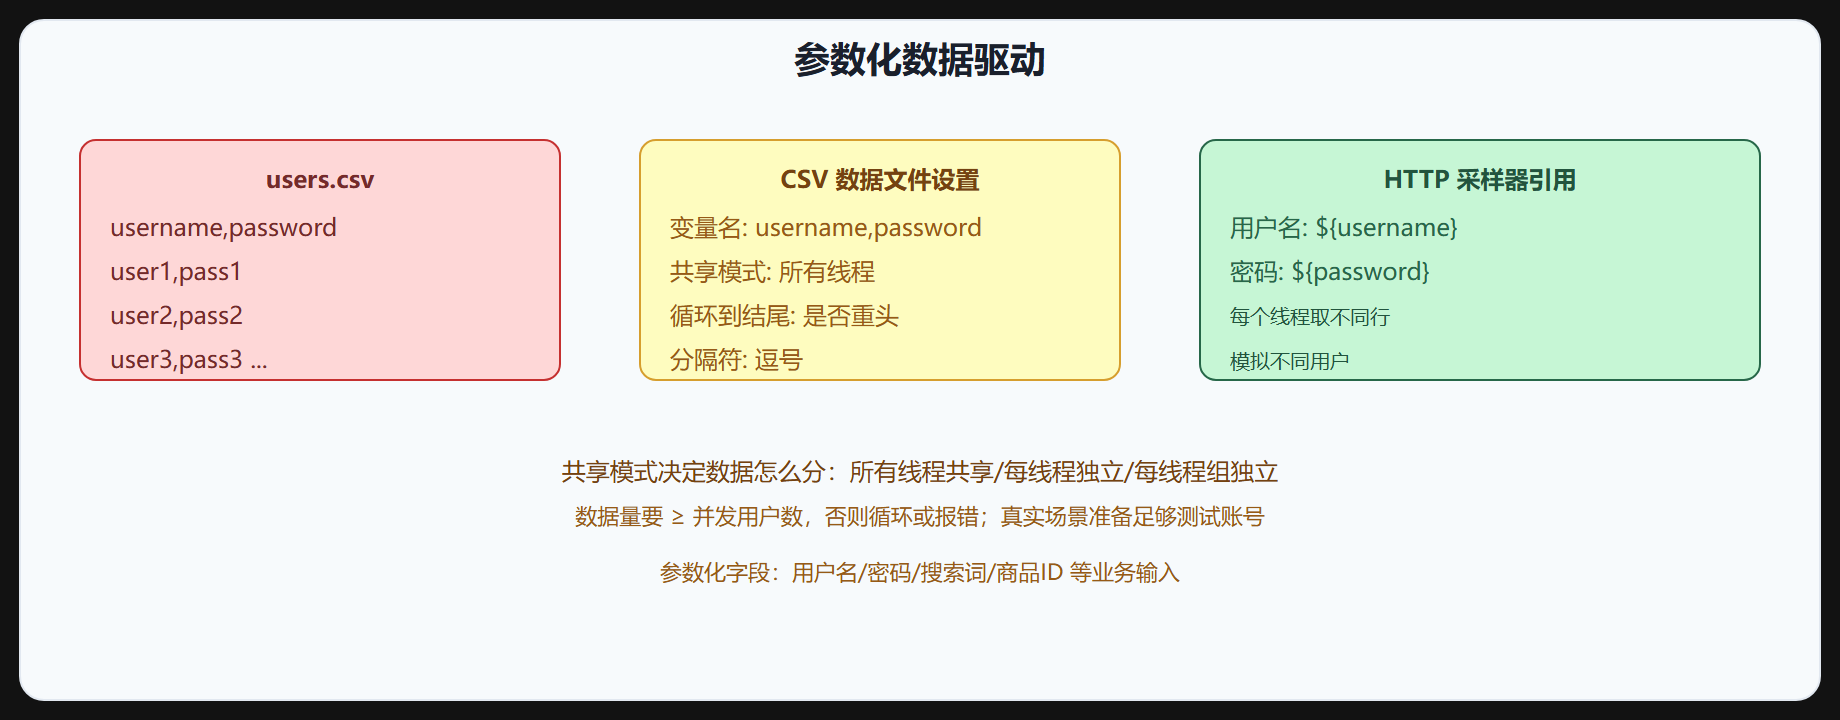
<CSVDataSet> <stringProp name="filename">users.csv</stringProp> <stringProp name="delimiter">,</stringProp> <stringProp name="variableNames">username,password</stringProp> <stringProp name="shareMode">all</stringProp> <!-- 所有线程共享 --> </CSVDataSet>
三、共享模式
| 模式 | 行为 |
|---|---|
| 所有线程共享 | 所有线程按顺序取同一份数据,不重复 |
| 每个线程独立 | 每线程从第一行开始各自取 |
| 每个线程组独立 | 每线程组独立取 |
测"不同用户登录"用"所有线程共享",每用户取不同行。
四、数据量准备
- 数据量 ≥ 并发用户数,否则不够分
- 数据要真实多样(不同账号、不同商品 ID)
- 敏感数据脱敏(别用真实用户密码压测)
五、循环到结尾
数据用完怎么办:
- 停止线程:数据用完线程结束
- 循环重头:数据用完从头再来
- 继续用最后一行:都用最后一行
按场景选,一般循环重头或停止线程。
⚠️ 常见坑:数据量不够并发数——部分用户用同一份数据,测不出真实场景。准备足够测试数据,或用循环重头。
💡 关键直觉:CSV 数据文件做参数化,每线程取不同行模拟不同用户。共享模式决定数据分配,数据量要 ≥ 并发数,敏感数据脱敏。
本节速览
- 参数化目的:不同用户不同数据,贴近真实场景。
- CSV 数据文件:配置文件、变量名、分隔符、共享模式。
- 共享模式:所有线程共享(每用户不同行)/每线程独立/每线程组独立。
- 数据量:≥ 并发用户数,真实多样,敏感数据脱敏。
- 循环到结尾:停止线程/循环重头/用最后一行,按场景选。
下一节讲关联——请求间有依赖怎么处理。
参数化方式
JMeter 参数化主要有三种:用户定义变量(固定值,适合环境配置);CSV 数据集(从文件读行,支持循环与随机取数,适合大规模数据驱动);函数助手(如随机函数 __Random、计数器 __counter,适合动态数据)。参数化让同一脚本以不同数据反复执行,模拟真实用户差异。
CSV 数据集配置要点
| 配置项 | 说明 | 建议 |
|---|---|---|
| Filename | CSV 路径 | 用相对路径或变量 |
| Variable Names | 列名 | 逗号分隔 |
| Sharing Mode | 共享方式 | All threads 或按组 |
| Recycle | 是否循环 | 数据不足时选 True |
| Stop Thread | 数据耗尽是否停止 | 按需设置 |
数据驱动实践
数据驱动脚本的典型流程:准备数据文件(用户、商品、关键词等)→ CSV 数据集读取 → 采样器引用变量 → 断言校验对应结果。注意数据量与并发的关系:并发线程数不应超过数据行数(除非允许循环),否则部分线程读不到唯一数据。
函数参数化示例
除 CSV 外,函数助手提供灵活的动态数据:{__time()} 生成时间戳、{__Random(1,1000)} 生成随机数、{__UUID()} 生成唯一标识、{_counter()} 递增计数。例如构造唯一订单号:order{__time()}_{__counter()}。函数与 CSV 可组合使用,满足复杂业务的数据生成需求。
数据驱动最佳实践
数据驱动脚本的最佳实践:CSV 数据按业务维度组织(一列一个维度);大数据量文件优先用相对路径并配合流水线分发;共享模式下各线程按需取数,避免重复;数据耗尽策略明确(循环或停止)避免测试中途异常;参数化字段在采样器中用 ${变量名} 引用,命名清晰便于维护。
参数化与真实性的关系:真实用户数据分布(用户名、商品、地址)通常不均衡,简单随机或顺序取数无法完全模拟。进阶做法:按业务规则加权取数(高频商品多命中);结合真实流量采样(从生产日志提取参数分布);用 CSV 文件承载贴近真实的参数组合。数据越真实,压测结论越可信。
参数化调试
调试参数化问题:用调试采样器输出 ${变量} 实际值;确认 CSV 编码(UTF-8 带 BOM 会污染首行);检查换行符(Windows/Linux 差异);路径用相对路径或变量(换环境可移植)。参数化是脚本稳定性的常见隐患,调试技巧能快速定位。