1.4 应用场景:记忆进化能落地的地方
1.4 应用场景:记忆进化能落地的地方
本节摘要:记忆进化不是所有场景的刚需,判断标准只有一条:交互是否产生"值得跨会话保留的积累"。本节先给出场景矩阵,帮你快速定位自己的需求属于哪一类;再以企业合同审查助手为例,完整走一遍从需求分析、智能体设计到效果验证的落地过程。读完本节,你能独立判断一个业务问题值不值得动用持久化记忆,并说出对应的架构要点。
场景图谱:谁最需要会进化的记忆
把常见的大模型应用按"记忆积累价值"与"交互周期长短"两个维度铺开,需求分布立刻清晰起来。短期一次性任务(翻译、摘要、改写)落在左下角,记忆纯属累赘;而长期陪伴型与长程协作型应用落在右上角——交互周期以周、月计,且每次交互都在为后续决策积累素材,这正是持久化记忆的主场。
图 1-3 应用场景的记忆需求矩阵
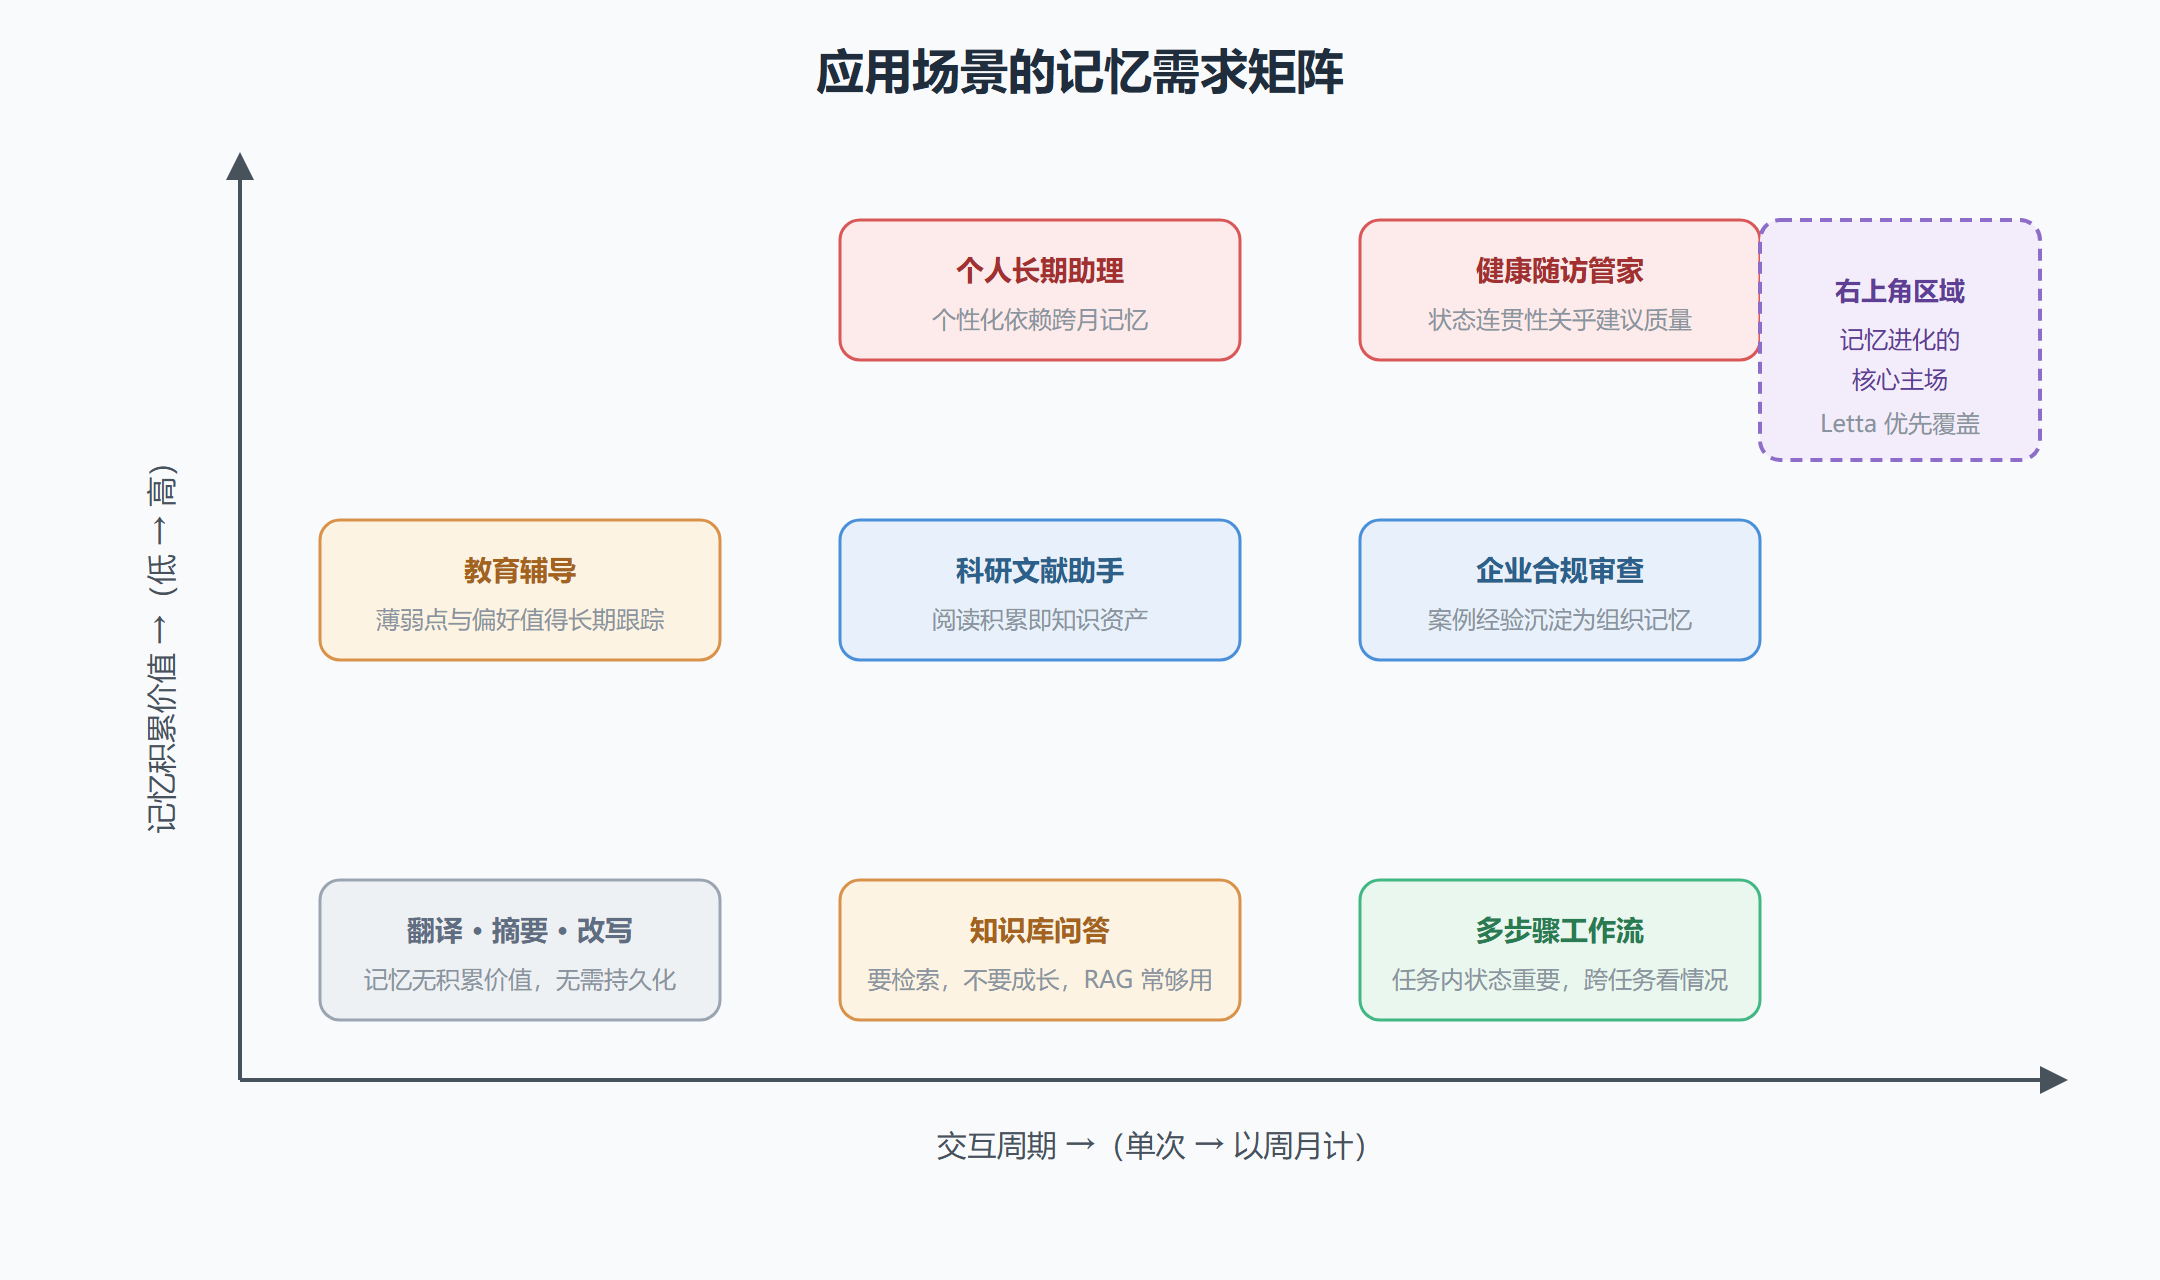
矩阵只是粗筛,真正的判断还要看三点:信息是否随时间演化(用户偏好会变,法规文档也会更新);错过历史信息是否造成实际损失(随访漏掉一次用药反馈,代价真实存在);交互是否高频到值得为记忆付存储与推理成本。三点同时成立,才值得把 Letta 请进来。
完整案例:企业合同审查助手
光看地图不过瘾,这里把一个典型场景从头到尾走一遍。案例是某法务团队的合同审查助手,需求来自真实痛点:审查标准散落在历次审查意见里,老律师的经验没有结构化沉淀,新合同总在与三个月前相似的问题上重复踩坑。
背景与目标。 团队的目标不是"AI 替人审合同",而是让助手记住每一份历史合同的审查结论与特批口径,在初审新合同时主动提示"本条与去年某项目的约定冲突"。换言之,要的是一份会自己长大的组织记忆。
操作过程。 第一步,为团队创建一个长期存活的审查智能体,把通用审查规范写进初始记忆块:
agent = client.agents.create( name="contract_reviewer", memory_blocks=[ {"label": "persona", "value": "你是合同初审助理。审查时逐条比对历史案例," "发现冲突必须指出历史合同编号;结论不确定时明说不确定。"}, {"label": "human", "value": "服务对象是公司法务团队,遵循最新版采购合同模板。"}, ], model="openai/gpt-4o", embedding="openai/text-embedding-3-small", tools=["archival_memory_search"], # 显式挂载档案检索 )
第二步,把近年的历史审查意见批量写入存档存储,向量检索使它们可被语义召回。第三步,进入日常运行:每份新合同初审时,智能体自主检索档案中的相似条款,把比对结论写进回复;特批口径经法务确认后,由模型写入核心记忆,成为后续审查的默认依据。
结果与解读。 运行一个季度后,团队观察到两个变化:初审意见中引用历史案例的比例明显上升,说明记忆检索真的进入了决策链;更重要的是,相似的特批口径在不同审查者之间不再出现矛盾——因为确认过的口径进了共享的记忆块,智能体成了口径的统一出口。解读这个结果的关键在于:价值不是来自"模型更聪明",而是来自交互产生的经验被留在了系统里。
过程中的两次返工也值得记录。 第一次返工发生在第二周:审查者抱怨助手"什么都往档案里塞",检索回来的多是无关的历史片段。诊断结论是 persona 里缺少写入标准,档案沦为流水账——补上一条"只有经法务确认的口径才写入存档"后,检索质量立刻回升。第二次返工发生在第六周:一个早已作废的旧模板仍被助手当作现行标准引用,根因是核心记忆里的模板版本没有随业务更新。这两次返工指向同一课:记忆系统上线只是开始,治理(第 5 章的主题)才是长期运营的主要工作。把返工过程如实记录在这里,是因为它比成功路径更有参考价值——你大概率会在同样的地方摔倒。
变式。 同一套骨架换个记忆内容就是另一个产品:把审查意见换成患者随访记录,是慢病管理管家;换成学生的错题与提问史,是长期辅导导师;换成项目会议纪要与阻塞记录,是跨会话的项目管理助理。共同点只有一个——交互本身在生产值得沉淀的经验。
场景与记忆机制的对应关系
不同场景对记忆部件的依赖权重不同,选型时值得对照下表校准:
| 场景 | 首要记忆需求 | 关键机制 | 特别注意 |
|---|---|---|---|
| 个人长期助理 | 偏好与事实的长期保持 | 核心记忆块自我修订 | 防止过时信息堆积(第 5 章) |
| 科研文献助手 | 海量知识的语义沉淀 | 存档存储向量检索 | 写入要有筛选,避免档案变垃圾场 |
| 合规审查助手 | 案例口径的组织级一致 | 共享记忆块加档案检索 | 记忆变更需可审计 |
| 健康随访管家 | 状态的跨会话连贯 | 持久化状态加召回存储 | 敏感数据的隔离与留存策略 |
| 多步骤工作流 | 任务内进度不丢 | 状态持久化加心跳触发 | 与编排框架的边界(见 1.5 节) |
这张表的最后一列是最容易被忽略的:每个场景在享受记忆红利的同时,都背着一笔治理债务。记忆不是越多越好,堆积的过时记忆反而会污染决策——这既解释了为什么第 5 章要专门讨论记忆膨胀治理,也提醒你别把"装上记忆"当成一劳永逸的终点。
还有一个跨场景的共性值得点破:这些场景对记忆的读取节奏完全不同。个人助理与随访管家是"每轮都要读"——核心记忆高频参与推理;文献助手与审查助手是"按需深挖"——存档检索才是主战场。读取节奏决定了记忆结构的设计重心:前者的功夫花在核心记忆的条目质量上,后者的功夫花在档案的写入粒度与检索策略上。动手设计自己的场景时,先回答"我的场景靠哪层记忆吃饭",设计就不会跑偏。
场景判断的自查问题
落不了地的时候,用几个具体问题把自己问醒。第一问:三个月后,这次对话里的信息还有用吗? 答案为否的场景(改写一段文案、解释一个概念),记忆纯属浪费。第二问:用户会为"被记住"付钱吗? 教育辅导、健康管理、专属助理的答案通常是肯定的——个性化本身就是付费点;而通用问答类产品,用户并不在乎你记不记得他。第三问:记忆的维护成本谁承担? 记忆需要治理(第 5 章的课题),如果产品没有持续运营的团队,积累的记忆只会逐渐腐坏。三问之后仍为肯定的场景,才值得进入选型环节。
本节要点回顾
- 判断标准:交互产生值得跨会话保留的积累,才需要持久化记忆;单次任务用记忆纯属浪费。
- 矩阵定位:个人助理、随访管家、组织知识类应用落在需求矩阵右上角,是记忆进化的核心主场。
- 案例要点:合同审查助手的价值来自经验沉淀,模型自主检索加共享记忆块统一了团队口径。
- 可复用骨架:初始记忆块定规范、档案库存历史、运行中沉淀口径——换掉记忆内容即适配新场景。
- 治理提醒:每个记忆场景都附带治理债务,落地前先想清楚过时记忆怎么清理。
下一节回到横向对比:同样的需求摆上 LangChain、Assistants API 或独立记忆层的桌面,Letta 的位置在哪里,边界又在哪里。