- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
Letta 教程导读:给智能体装上会进化的记忆
最初的对话式 AI 常常让人既惊叹又失望:它能瞬间写出像样的方案,却会在紧接着的几轮问答里忘掉你刚提过的偏好。研究者把这种健忘称作无状态,把上下文窗口视作模型与生俱来的天花板。要治好健忘症,光把窗口做得更大并不够——真正的出路是给智能体装上一套会自己整理、会自我修订的记忆系统。本册 Letta 教程,就沿着这条线索,把"给智能体装上会进化的记忆"拆解成一场可以亲手操作的实验。
回顾这段技术源流,故事的起点是 2023 年 10 月加州大学伯克利分校 Sky Computing Lab 发表的 MemGPT 论文。论文把操作系统里的虚拟内存思想搬进了大语言模型:上下文窗口当作"主存",数据库当作"磁盘",让模型自己决定何时把信息在两者之间换入换出。2024 年,这个学术原型正式更名为 Letta,从一篇论文成长为一个服务化、可部署的智能体框架。今天你再打开 Letta,看到的已经是一套把"记忆块、自我编辑、持久化状态、多智能体共享"当作一等公民的完整体系——这正是我们把它选作记忆实验台的原因。
本册主线:把记忆进化拆成五个实验阶段
与其把这本教程读成"框架功能清单",不如把它读成一份实验记录。全册以"记忆进化实验"为主线,分为五个递进的实验阶段,每个阶段对应一章:
- 实验起点(第 1 章):先看清实验对象。什么是无状态模型的"金鱼记忆",MemGPT 到 Letta 的演化解决了什么问题,以及它和同类框架相比适合摆在什么位置。
- 实验原理(第 2 章):拆开记忆系统的构造。分层存储怎么设计,记忆工具如何形成自我编辑的闭环,Server 与存储层的架构如何支撑这套循环。
- 实验环境(第 3 章):搭建实验台。Pip 与 Docker 两种安装路径、SQLite 到 PostgreSQL 的迁移、环境变量与连接管理。
- 实验观测(第 4 章):学会观察记忆。用 ADE 可视化仪表盘盯着智能体的"内心独白",用 CLI 与 SDK 把实验脚本化。
- 实验进阶(第 5 章):让记忆真正进化。创建智能体、接入模型、编写工具、跨会话保持状态,再到共享记忆块与记忆膨胀治理。
全册知识地图
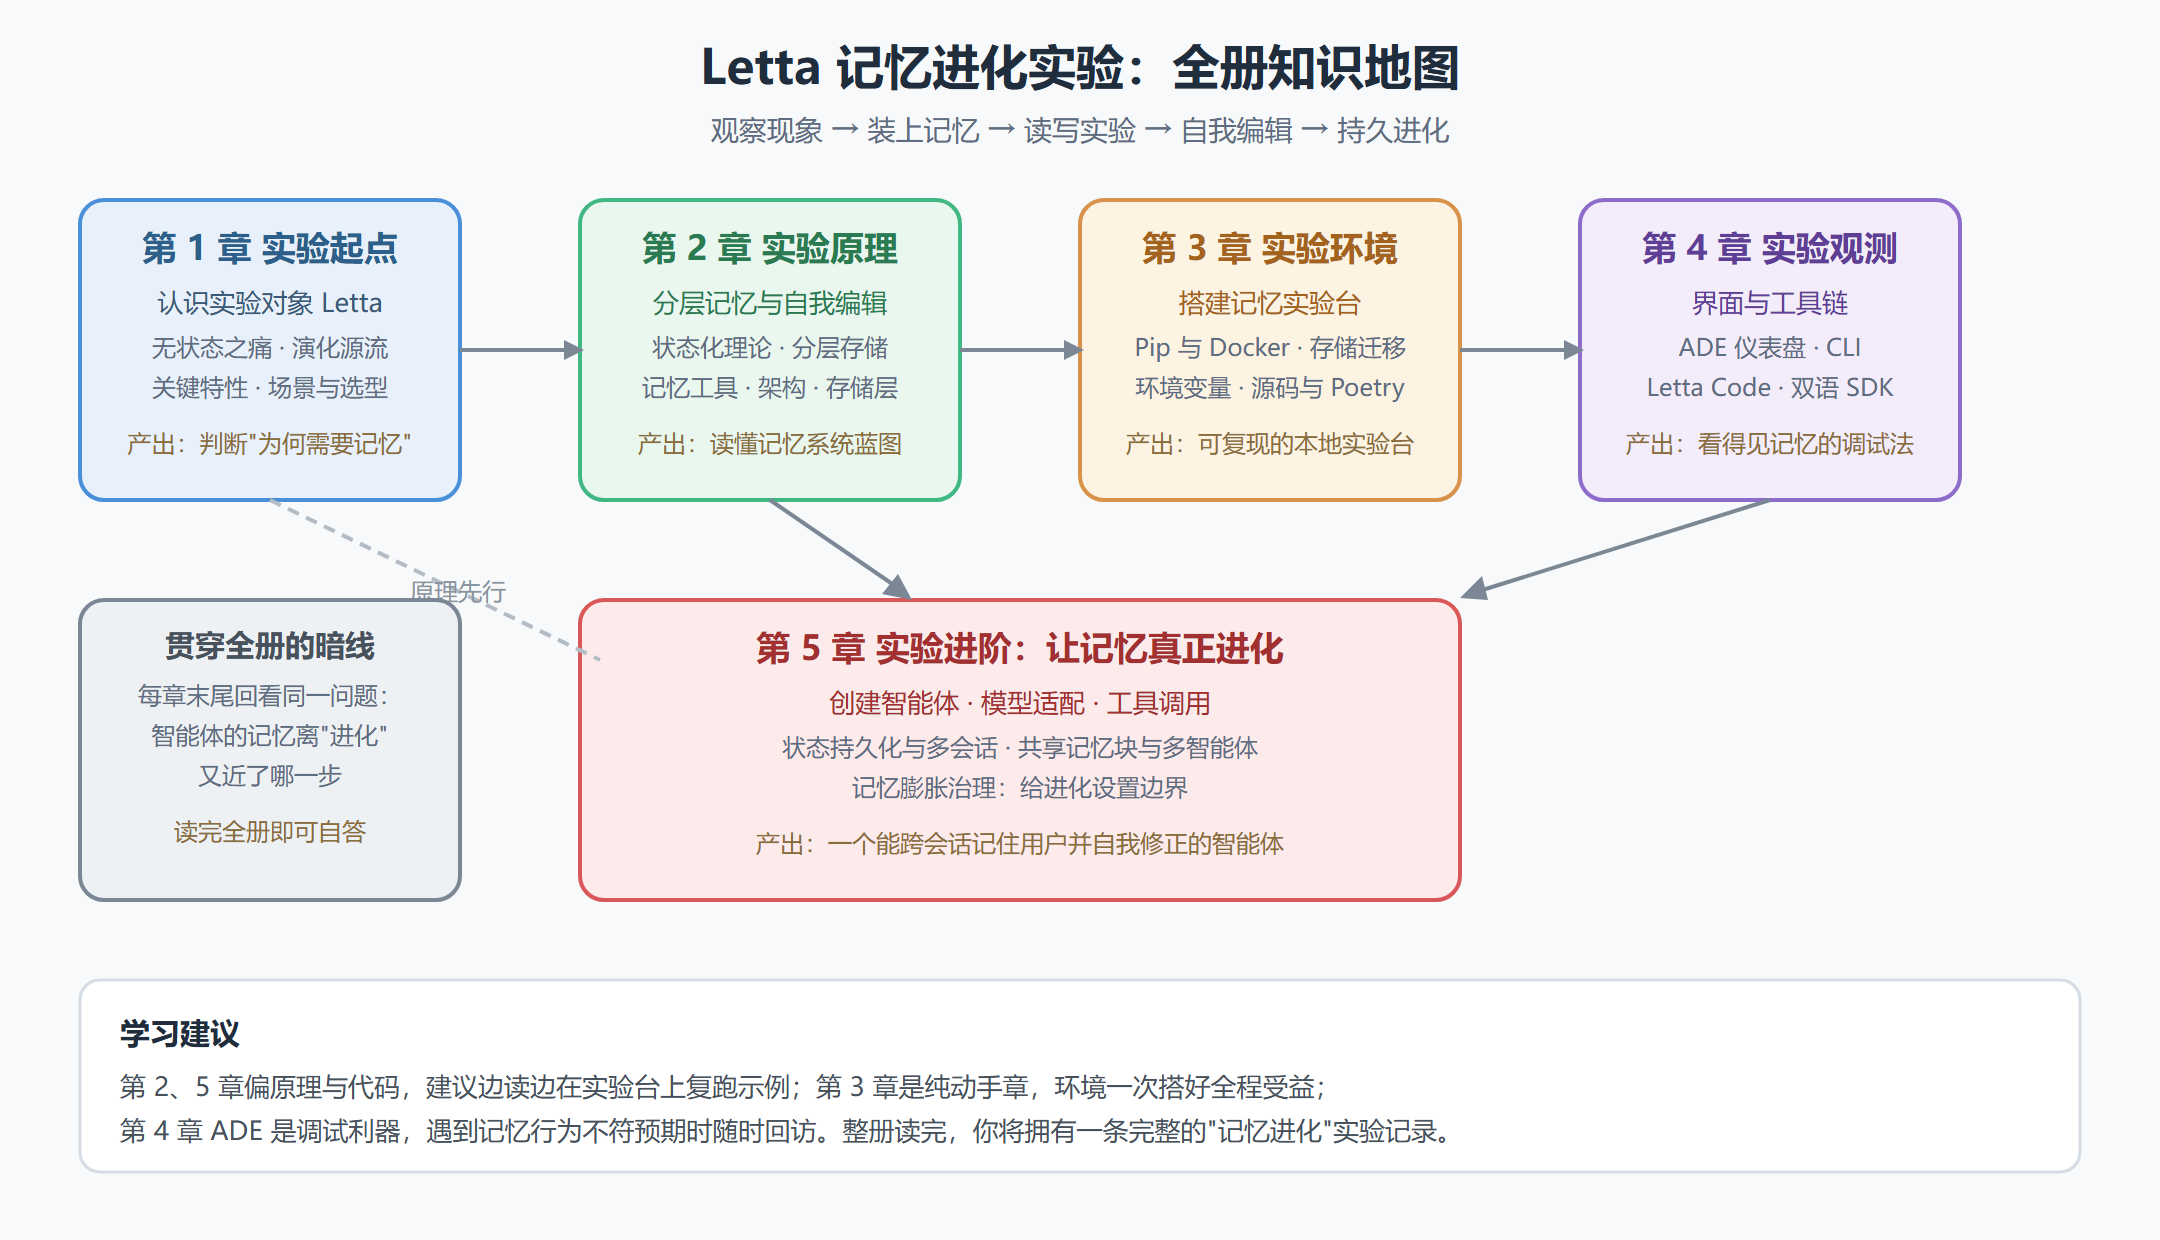
下图给出全册的知识地图:箭头表示学习依赖关系,先弄清实验对象与原理,再搭环境、学观测,最后进入进阶实验。每个实验阶段都建立在前一阶段的产物之上——没有第 2 章的分层记忆模型,第 4 章的 ADE 观测就只是一堆界面截图;没有第 3 章的持久化环境,第 5 章的跨会话状态实验根本无从谈起。
图 0-1 Letta 记忆进化实验全册路线图
这册教程适合谁
如果你满足下面任意一条,这份教程就是为你准备的:正在做聊天机器人、个人助理或企业知识库,饱受"对话一长就失忆"困扰的应用开发者;已经用过 LangChain 之类编排框架,想给智能体补上长期记忆与自我演化能力的工程师;研究 Agent 记忆机制、想找一个白盒化实验台的学生或研究人员。反过来说,如果你只想找一个拿来就用的聊天产品,这册内容对你会偏重工程细节——它假定你愿意写代码、读日志、改配置。
阅读前建议备好三样东西:一个可用的 Python 环境(3.10 以上版本)、一个主流模型的 API 密钥(OpenAI、Anthropic 或本地模型均可,第 5 章有适配细节)、以及一份"把实验做完"的耐心。Letta 的趣味在于反馈回路:你改一行记忆块,下一轮对话就能看到智能体行为的改变。
读完你会得到什么
到全册结束,你应当能独立完成下面这些事:解释 Letta 分层记忆的构成,说清核心记忆、召回存储与存档存储各自的分工与淘汰逻辑;在本机把 Letta Server 跑起来,并完成 SQLite 到 PostgreSQL 的生产级迁移;用 Python 或 TypeScript SDK 创建智能体、注册自定义工具、观察并干预它的记忆状态;设计一个跨会话记住用户偏好、且能自我修正过时认知的记忆策略;识别记忆膨胀与上下文污染的早期症状,并给出治理方案。
这些能力合在一起,指向同一个母题:智能体的长期价值不取决于某个瞬间的回答有多华丽,而取决于它能否在时间的流动里沉淀经验、修订自我。这本教程不敢承诺把你带到通用智能的门口,但它能保证一件事——读完之后,你再看"AI 助手"这个词时,脑子里会出现一个会记笔记、会翻旧账、会改笔记的实验对象,而不是一段每次都从头开始的文本补全。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...