4.4 客户端 SDK:Python 与 TypeScript 集成
4.4 客户端 SDK:Python 与 TypeScript 集成
本节摘要:SDK 是程序观测与操作智能体的标准通道:官方提供 Python 与 TypeScript 两个一等公民客户端,接口语义一致。本节给出两侧的接入方法与核心代码样例,讲清异步模型、类型化响应与流式接收三个集成要点,并给出一套可复用的观测代码骨架。读完本节,你的业务代码就能把记忆观测纳入自动化。
双语 SDK 的同一套世界观
第 2 章讲过:智能体是网络资源,SDK 只是把 HTTP 协议翻译成顺手的语言结构。这决定了两个官方 SDK 的关系不是"谁强谁弱",而是同一套资源模型在两种语言里的投影——agents、blocks、messages、tools 四类资源的增删改查,两边的方法名与返回结构彼此对应。你可以放心按语言选型:数据科学管线用 Python,Web 与 Node 服务用 TypeScript,跨语言团队甚至可以各用各的而不必对齐版本。
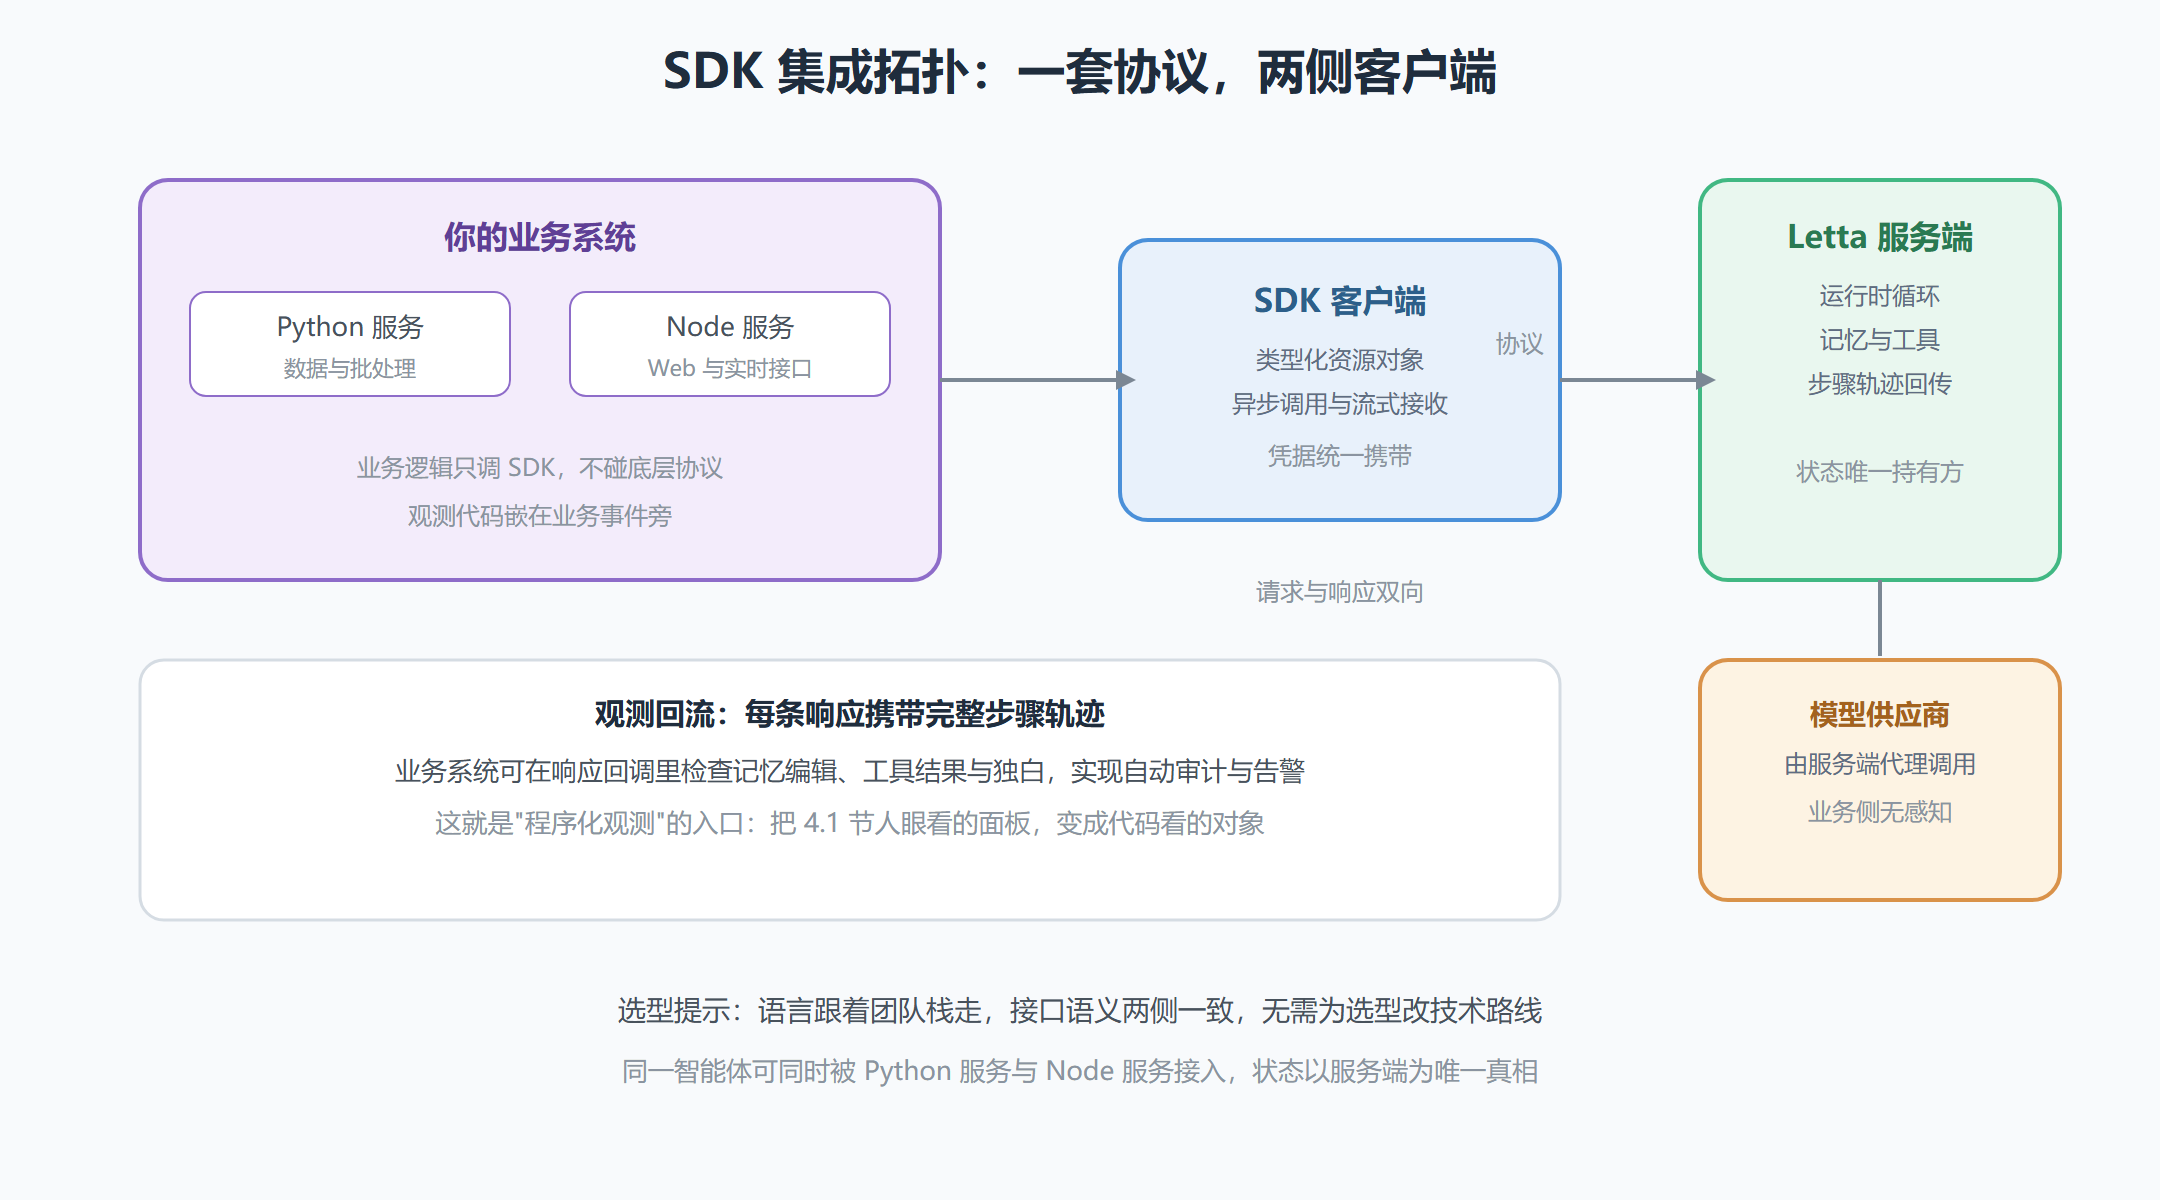
集成拓扑上,SDK 客户端处于业务系统与 Letta 服务端之间:业务逻辑调用 SDK,SDK 走协议访问服务端,服务端读写数据库并代理模型调用。观测数据的回流路径也在这条链上——每条响应携带的步骤轨迹,经 SDK 的类型化对象递到你的代码里:
图 4-2 SDK 集成拓扑:业务系统与智能体服务的标准接法
安装与初始化:两侧各一分钟
两侧 SDK 都从包管理器一行装起,初始化只差服务地址与凭据:
# Python 侧 pip install letta_client # TypeScript 侧 npm install @letta-ai/letta-client
初始化时把配置收进环境变量而不是写死在代码里——服务地址会随环境切换(本地、测试、生产),凭据按 3.3 节的纪律管理。Python 侧从环境读地址的写法:Letta(base_url=os.environ["LETTA_BASE_URL"]);TypeScript 侧同理。这一分钟的规范,换来的是同一份业务代码跨环境零修改的部署体验。
Python 侧:异步与流式两个要点
Python SDK 的基础用法此前章节已经反复出现,本节补上集成阶段的两个进阶要点。第一是异步客户端:业务服务通常是高并发环境,同步调用会在线程池上白白阻塞,异步客户端让你在单进程内并发地把消息发给多个智能体:
import asyncio from letta_client import AsyncLetta client = AsyncLetta(base_url="http://localhost:8283") async def ask(agent_id: str, question: str) -> str: resp = await client.agents.messages.create( agent_id=agent_id, messages=[{"role": "user", "content": question}], ) return last_text(resp) async def main(): # 并发询问多个智能体:互不阻塞 answers = await asyncio.gather( ask("agent-a", "本周待办有哪些"), ask("agent-b", "上次评审结论是什么"), ) print(answers) asyncio.run(main())
第二是流式接收:长回答场景下,等完整响应再返回会让用户等得心焦。流式模式下,模型每生成一段就推送一段,你的代码在回调里逐段处理(转发给前端、写日志、做敏感词检查都行)。两个要点叠加,构成生产集成的标准姿势:异步并发加流式推送。
集成调试期还有一条实用建议:先把响应对象完整打印出来看一眼结构,再动手写解析代码。类型化的响应对象字段比文档记得更真实——message_type 的实际取值、轨迹消息的嵌套层次、元数据字段的位置,看一遍真实样本胜过十次猜测。这也是类型化 SDK 的好处:结构即文档,探索即学习。
TypeScript 侧:同样的资源,前端的距离
TypeScript SDK 的价值在于把智能体带到了 Node 与浏览器生态的距离之内。同样的四类资源、同样的调用语义,前端与 BFF 层可以直接编排对话:
import { LettaClient } from "@letta-ai/letta-client"; const client = new LettaClient({ baseUrl: "http://your-letta-server:8283" }); // 与 Python 侧同构:发消息、读轨迹、查记忆块 async function coachCheckIn(agentId: string, note: string) { const resp = await client.agents.messages.create(agentId, { messages: [{ role: "user", content: note }], }); // 从响应中检查记忆编辑:观测逻辑与业务逻辑并肩存在 const edits = resp.messages.filter((m) => m.messageType === "tool_call"); if (edits.length > 0) { console.log("本轮发生了记忆编辑:", edits.length, "次"); } } // 读取记忆块的当前值:渲染到界面上的"智能体认知卡片" const blocks = await client.agents.blocks.list(agentId);
这段代码的末尾藏着一个对前端特别有价值的模式:把记忆块的当前值渲染成"智能体的认知卡片",用户能亲眼看到智能体记住了自己什么——4.1 节 ADE 的观测理念,借 SDK 延伸到了产品界面里,变成了一种信任建立机制。
认知卡片在产品上还有一层惊喜的副作用:它让用户主动参与记忆纠错。 用户看到卡片里写着"偏好:简洁回答",若这已不符合实际,会顺手在界面上纠正——相当于把 5.6 节的记忆治理分了一部分给用户,治理成本下降,记忆准确率上升。把观测做成产品功能而不只是开发工具,是 SDK 视角独有的机会:ADE 服务于开发者,SDK 把同样的能力递到了用户手里。
工程上再补一个细节:前端直连服务端与后端代理两种接法怎么选?原型期直连最快;生产环境通常走后端代理——凭据不落前端、可加限流与审计,安全边界更清晰。两种接法代码几乎相同,切换成本极低,按安全要求演进即可。
关于 SDK 集成的常见疑问
问:SDK 版本与服务端版本需要严格对齐吗? 服务端升级后保持 SDK 在近期版本即可——协议是稳定契约,SDK 只是它的封装。升级服务端时顺手升级 SDK、跑一遍验证脚本,是省心的组合动作;跨多个大版本滞后才需要仔细看变更说明。
问:脚本与 SDK 报错"连接被拒",先查什么? 顺序固定三步:服务是否在跑(健康检查)、地址端口是否正确(对照启动日志)、凭据是否携带(3.3 节的密码机制)。三步之外的问题才需要往网络层找。
问:轮询记忆变化好还是事件通知好? 当前以按需读取为主:读块、读消息都是廉价操作,业务里在需要的时机顺手读即可。对实时性要求极高的场景(界面实时展示记忆变化),用流式消息接口观察每轮编辑事件,比轮询优雅得多。
一套可复用的观测骨架
把本章各节的观测需求汇总,落成一个业务侧的观测函数骨架,五个检查点覆盖九成的集成观测需要:
def observe_response(resp) -> dict: """每次智能体响应后的标准观测:五检查点,可接告警与审计。""" report = {"edits": [], "tool_errors": [], "latency_hint": None} for m in resp.messages: if m.message_type == "tool_call": report["edits"].append(m.name) # 检查一:记忆编辑发生 if m.message_type == "tool_return" and not m.status_ok: report["tool_errors"].append(m.return_value) # 检查二:工具失败 # 检查三:独白长度异常增长,常提示模型在打转 # 检查四:响应耗时环比,提示模型或检索变慢 # 检查五:最终回答为空或拒绝作答,提示上下文异常 return report
骨架里的检查三到五留作练习——它们不需要新的接口知识,只需要你对"正常轨迹长什么样"积累手感,而这手感正是靠本章工具日复一日的观测养成的。接告警时给每类检查配独立的阈值与静默期,避免第一周就告警疲劳;接审计时把 report 对象原样入库——五项检查的输出,就是你系统里第一批结构化的"智能体行为日志"。观测不是一章的知识,是一个习惯;从这里起步,把它带进第 5 章的每个实验。
收尾前把三种客户端的适用场景串成一句话,方便你日后随时回忆:要"看全貌"开 ADE,要"跑操作"敲命令行,要"进程序"用 SDK——三者并行不悖,共用服务端的同一份状态。本章之后的所有实验都会同时用到它们:ADE 定性看效果,脚本定量收数据,SDK 把有效的实验固化成业务能力。
本节要点回顾
- 同一套世界观:双语 SDK 是同一资源模型在两种语言的投影,选型跟着团队栈走即可。
- Python 两要点:异步客户端支撑高并发,流式接收改善长回答体验,合为生产标准姿势。
- TypeScript 价值:把智能体带进 Node 与前端生态,认知卡片模式把观测变成产品内的信任机制。
- 观测骨架:编辑发生、工具失败、独白异常、耗时环比、拒绝作答——五个检查点覆盖多数集成观测。
- 习惯养成:观测是习惯不是知识,把本章工具带进后续每个实验。
第 4 章至此收官。仪器齐备、观测已成习惯,第 5 章进入真正的进阶实验:让记忆在受控条件下发生进化,并学会治理它的边界。