5.1 智能体创建:定义角色、工具集与初始记忆
5.1 智能体创建:定义角色、工具集与初始记忆
本节摘要:创建智能体不是填一张参数表,而是为未来的记忆进化"立宪":初始记忆块划定认知范围,persona 写下行为准则,工具挂载授予行动能力。本节按创建参数逐一讲清设计要点,给出一份可直接套用的初始记忆设计清单,并用一个完整案例演示从需求到创建的全过程。读完本节,你创建的每个智能体都会有清晰的进化起点。
创建不是填表,是立宪
同样一句"创建智能体",随手创建与设计创建的差距,会在数周后拉开两个数量级。随手创建的智能体:persona 一句话带过,human 块留空,工具全量挂载——运行三周后,记忆块里堆满互相矛盾的信息,行为风格漂移得连开发者都认不出。设计创建的智能体:每个记忆块有明确的职责声明,persona 里写清"什么时候该记、什么时候该问",工具只挂需要的——数周后它的记忆依然像一份整理过的档案。
差距的根源在于:初始状态决定了进化的吸引子。 模型在后续交互中怎么写记忆,很大程度上是照着初始记忆的样子"延续"的——初始块里条目清晰、粒度统一,后续写入也会模仿这个格式;初始块里是一团浆糊,后续写入只会更糊。这就是本节标题把创建称为"立宪"的意思:你在为这个智能体未来的所有认知活动立下根本法。
用一组对照实验可以亲手验证这个论断。创建两个同任务的智能体:甲的 human 块预填三条格式统一的条目,乙的块留一句"随意记录用户信息"。跑上几天对话再看:甲的块里新条目整齐地延续着既有格式,乙的块里长短混杂、主题跳跃——同一家模型、同一个使用者,唯一的差别是起点的样子。这个实验成本极低,说服力却极强,建议在每个团队里做一次,让"立宪"从比喻变成共识。
一份创建参数的设计指南
创建时的每个参数都值得想清楚再填。核心的创建调用把五个设计决策收在一处:
from letta_client import Letta client = Letta(base_url="http://localhost:8283") agent = client.agents.create( # 决策一:命名——按职能命名并带环境前缀,便于多智能体管理 name="ops_oncall_dev", # 决策二:初始记忆——persona 写行为准则,业务块各司其职 memory_blocks=[ {"label": "persona", "value": "你是运维值班助理。规则:先说结论与影响面;" "事故相关的关键决定必须记入 incident_notes 块;" "不确定时明确说不确定,禁止编造。"}, {"label": "human", "value": "服务对象:后端值班团队,关注变更记录与告警响应。"}, {"label": "incident_notes", "value": "(暂无在办事故)"}, ], # 决策三:引擎——起步用低成本模型,关键场景再升级(见 5.2 节) model="openai/gpt-4o-mini", embedding="openai/text-embedding-3-small", # 决策四:工具——按需挂载,不给不需要的能力 tools=["archival_memory_search"], )
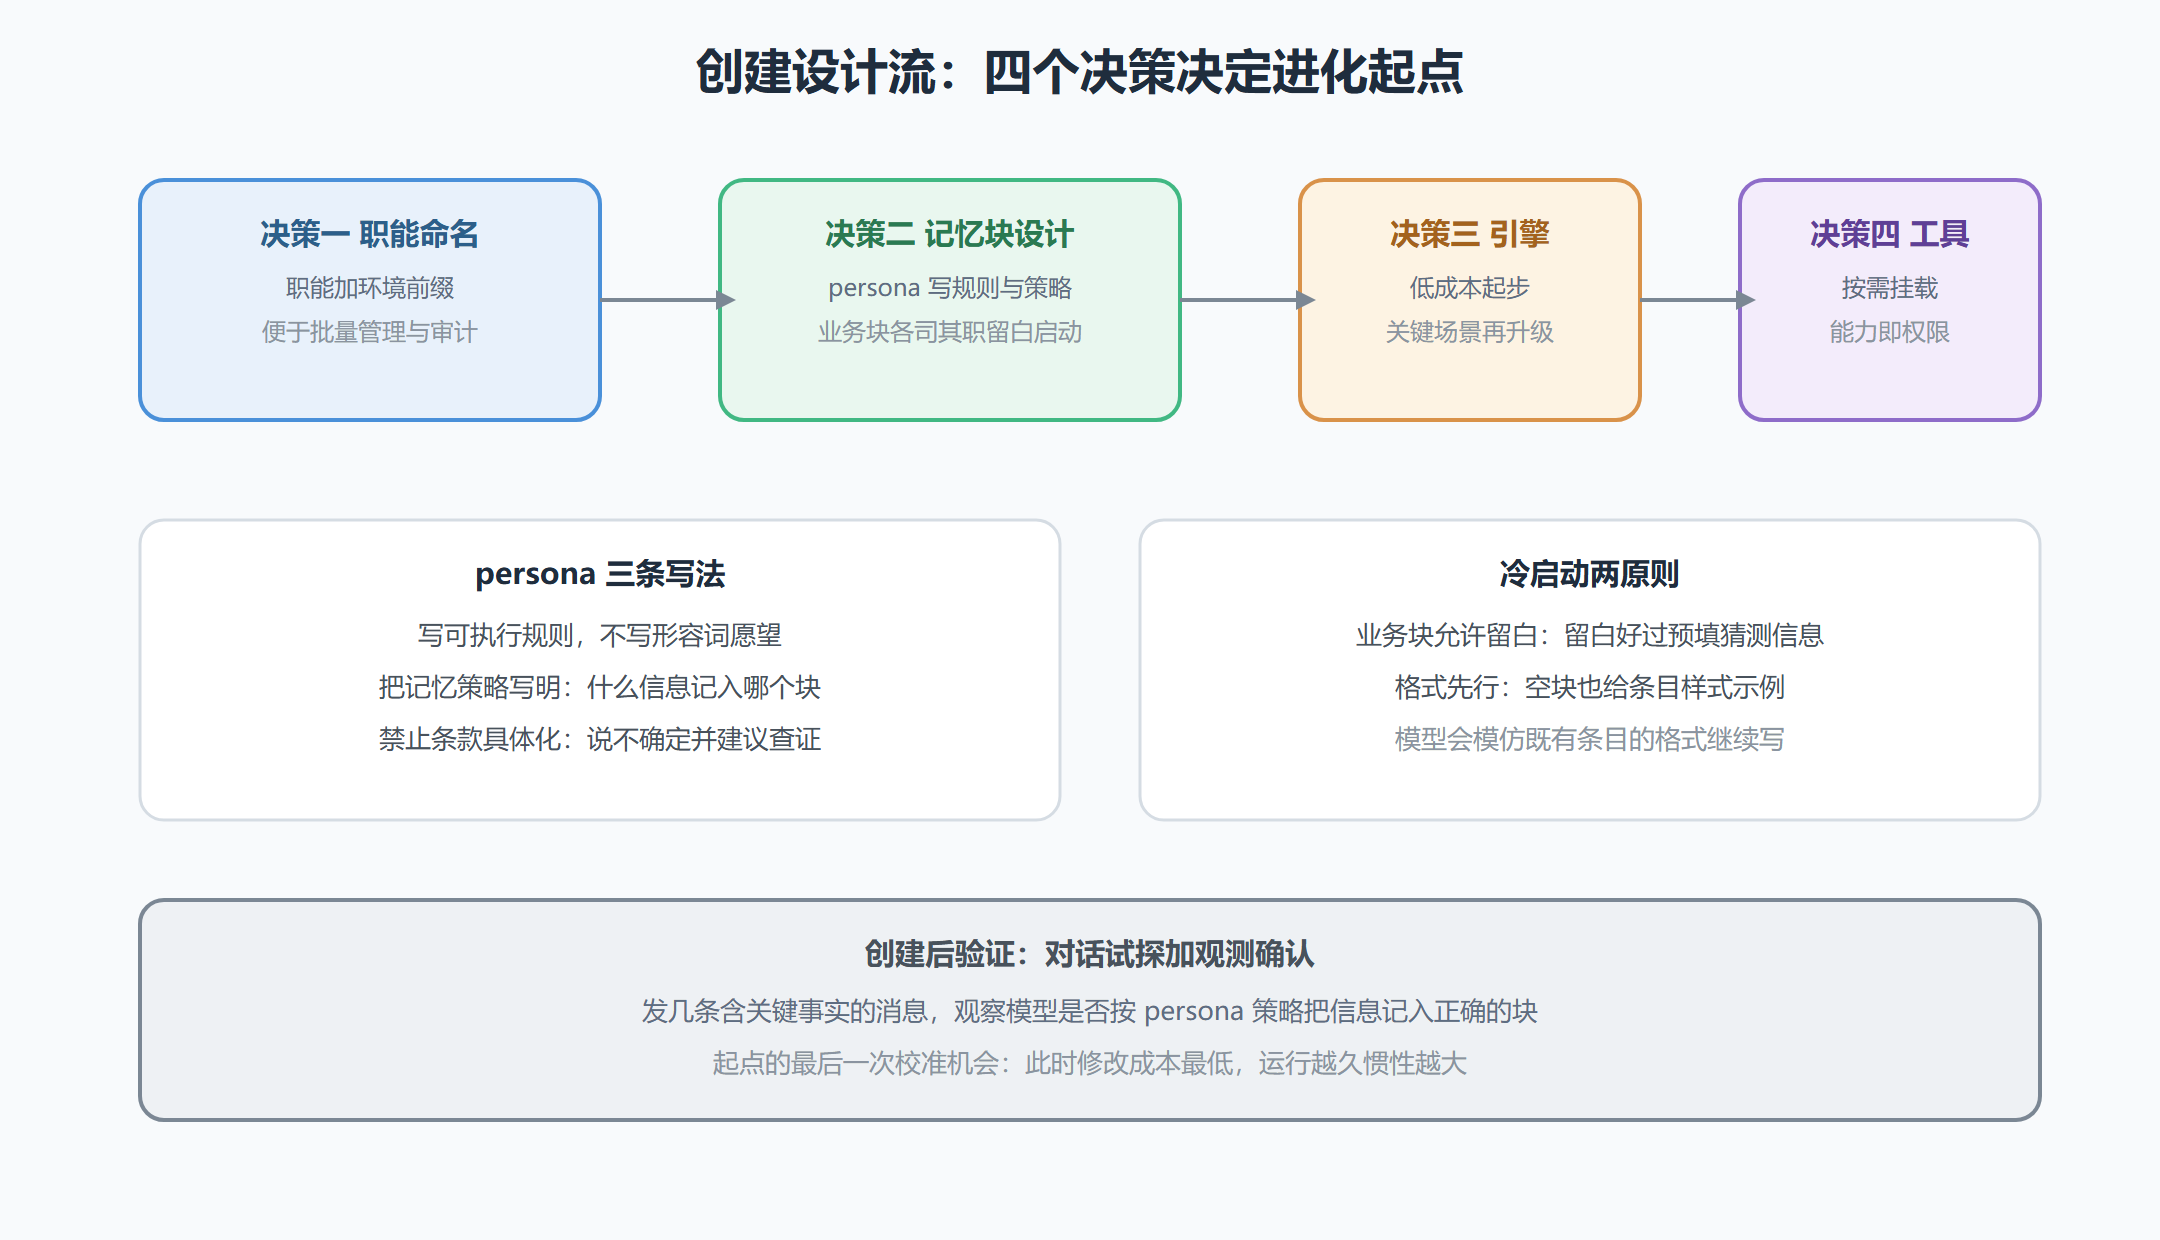
四个决策里最费思量的是 persona 的写法。三条经验规则:其一,写规则不写形容词——"回答先说结论"是可执行的规则,"你要表现得专业"是无效的愿望;其二,把记忆策略写进 persona——明说"什么样的信息该记入哪个块",这是对模型编辑行为最直接的引导(4.1 节案例的排查结论在此兑现);其三,禁止条款要具体——"禁止编造"远弱于"不确定时说明不确定并建议查证",模型对具体指令的遵循远好于抽象要求。
图 5-1 智能体创建的设计决策流
冷启动:留白好过猜测
初始记忆里的 human 块常常让新手为难:要不要预先填一些用户信息?经验是留白好过猜测——凭想象预填的用户画像,错了会固化成模型最坚定的"事实"(模型对写在记忆里的东西深信不疑),纠错成本远高于空块起步。正确的冷启动姿势是把"采集"交给运行:persona 里写明"首次接触时,主动了解对方角色与关注点",让真实信息经由模型的记忆工具进入正确的块。
有一种例外情况值得预填:格式示例。如果希望某个业务块的条目按特定格式累积(如事故记录统一按"时间、影响、决定"三段式),可以在空块里放一条标注为示例的条目——模型会忠实地模仿既有格式。这不是猜测信息,而是声明格式约定,两者有本质区别。
工具挂载同样讲究"起点最小化"。默认挂载的内置记忆工具保留(它们是记忆系统的法定通道),业务工具按需添加——每多挂一个,模型的选择空间就多一分复杂度。起步时只挂"这个智能体离开它就没法干活"的工具;运行中发现模型频繁表达"我做不到某事",那是补挂工具的信号,而不是一开始就把工具库全量倒进去。能力给得越克制,模型用它时越果断。
创建之后的第一课:验证起点
创建完成的标志不是接口返回成功,而是起点行为验证通过。做法很朴素:准备几条含关键事实的测试消息(披露身份、给出偏好、报告变更),逐条发送,同时在观测面板确认两件事——模型是否把该记的信息记入了正确的块;不该记的琐碎信息是否被恰当地忽略。这轮验证是修改成本最低的时刻:persona 的一行措辞调整、一个块职责的重新划分,现在改只是几秒钟的事;运行数周后再改,还要考虑存量记忆的清洗。
💡 把每类智能体的最终验证版 persona 与记忆结构存成模板。第二个同类智能体直接从模板创建,第三个、第四个会越来越顺手——你实际上在沉淀组织的"智能体宪法库",这是从个人实验走向团队资产的第一步。
模板沉淀时顺手记录一件事:每个字段的设计理由。为什么 incident_notes 块留白启动、为什么 persona 强调"先说结论"——理由跟着模板走,后来者才不会知其然不知其所以然地乱改。理由本身也是活的:业务变了、模型换了,当年的理由可能失效,有理由可查的模板才有迭代的基础。一个智能体模板的成熟度,看它的注释密度就能估出七八分。
关于创建的常见疑问
问:一个智能体服务多个用户,记忆怎么隔离? 创建层面就分开:每个用户一个智能体实例(共享同一套记忆块模板与 persona 策略),记忆天然隔离。想共享的少数组织级事实,走 5.5 节的共享块。反过来"一个智能体记住所有用户"的做法,会把用户画像搅成一锅粥,是新手最危险的捷径。
问:persona 写中文还是英文? 与服务人群及模型倾向一致即可——面向中文用户就用中文写,模型对策略语言的遵循没有神秘偏差。比语言更关键的是措辞形态:祈使句、具体化、可判定,任何语言都适用。
问:创建后还能改 persona 和块吗? 随时可以,接口与界面都支持。但请把"起点验证"的纪律带过来:改动越大、运行越久,连带影响越难估——大改 persona 前先留存当时的记忆快照,改完对照观察行为变化,别让"随手改一下"变成不可追溯的漂移源。
本节要点回顾
- 立宪思维:初始记忆决定进化的吸引子,创建时的设计质量决定数周后的行为秩序。
- 四项决策:职能命名、记忆块设计、引擎起步、工具按需挂载,每个都影响后续演化。
- persona 三则:写规则不写形容词、写明记忆策略、禁止条款具体化。
- 冷启动原则:信息留白交给运行采集,格式示例可以预填——两者本质不同。
- 起点验证:创建后立即用试探消息验证记忆行为,模板化沉淀验证通过的宪法。
下一节解决引擎问题:不同模型驱动同一智能体有何差异,如何选配与验证。