5.3 工具调用与自定义函数集成
5.3 工具调用与自定义函数集成
本节摘要:自定义工具让智能体从"能说"进化到"能做":一个带文档说明的 Python 函数,经注册后即可被模型在推理中调用。本节讲清函数变成工具的完整链路、文档说明为何是工具质量的命门,以及工具执行结果如何回流进记忆系统。读完本节,你能把业务能力安全地接入智能体。
一个函数如何变成智能体的手
普通函数与智能体工具之间,隔着一道翻译工序:模型看不见代码,只看得见文字描述的结构化说明——工具叫什么、干什么用、接受哪些参数、各是什么类型。注册工具时,框架从函数签名与文档字符串自动生成这份说明,并交付给模型;模型在推理中若判断需要该能力,就按说明的格式发起调用;框架校验参数、执行真身函数、把结果回填给模型。
图 5-2 自定义工具的完整链路:从函数到行为
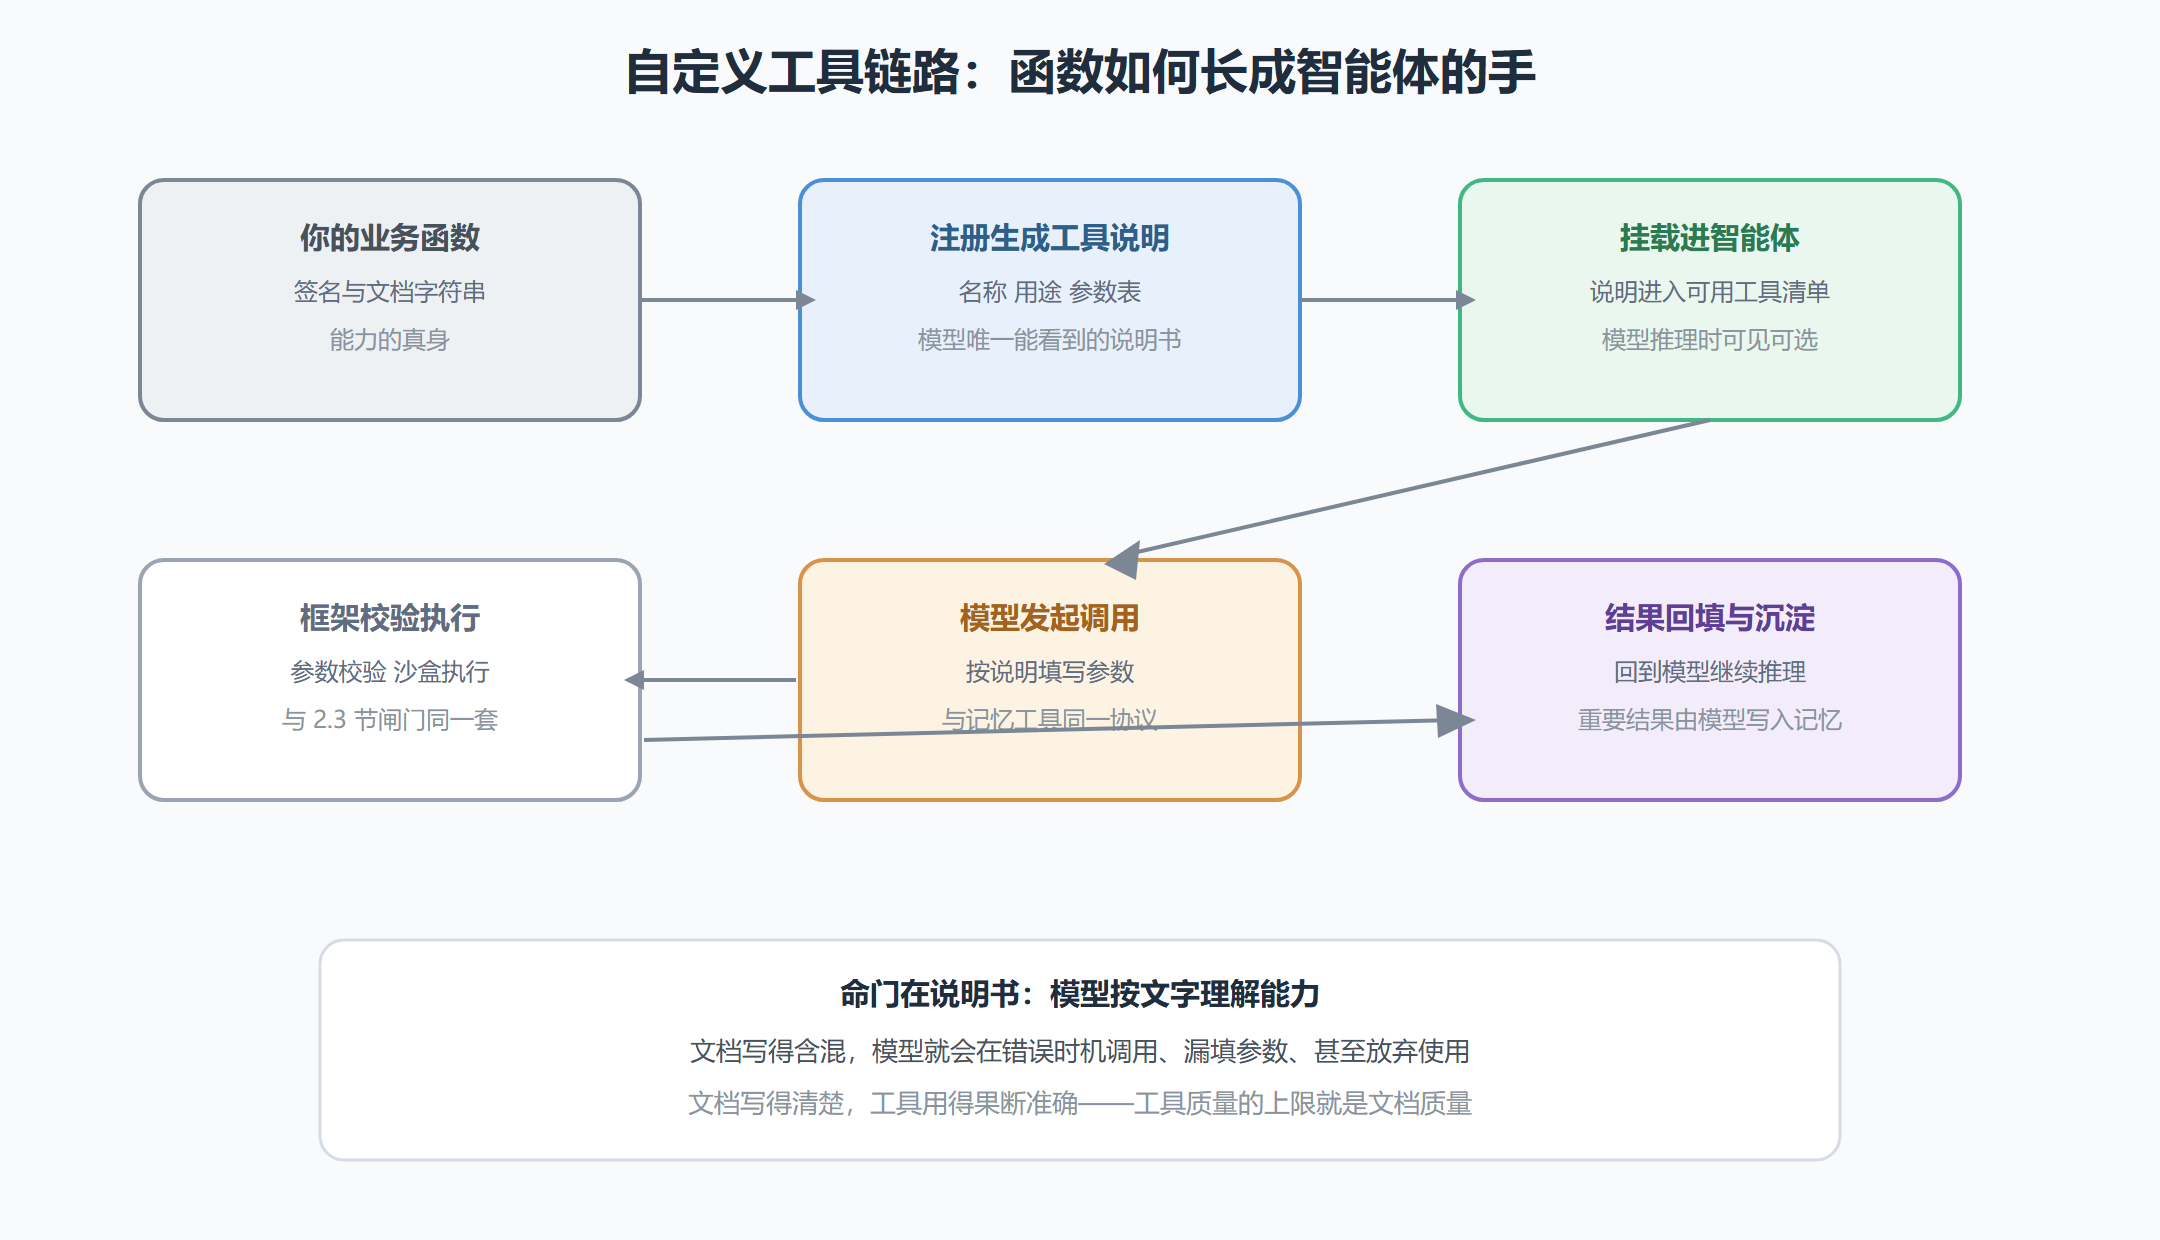
链路里最值得标重点的是"注册生成工具说明"这一环:模型的全部决策依据来自那份文字说明,而不是函数实现。函数写得再好,说明书含混,模型照样用错时机、漏填参数。工具质量的上限是文档质量——这是自定义工具的第一定律。
这条定律还有个工程推论:工具文档值得像接口文档一样做版本管理。改了参数含义、收窄了适用范围、换了返回形态,都是对模型认知的变更——模型不会读你的更新日志,它只知道最新版说明。所以文档变更要伴随小心的观察:改完文档的头几轮对话里,盯一下轨迹中该工具的调用时机与参数质量,确认模型已经"重新学会"了这个工具。把工具文档当产品文案对待的团队,工具用起来明显更顺。
写一个真正可用的自定义工具
用一件典型的小事走通全流程:让运维助理智能体能查询部署平台的发布状态。函数本体平平无奇,功夫全在文档字符串里。写之前先想清楚一件事:这个工具在模型的"能力版图"里补的是哪块空白——内置记忆工具管记忆,检索类工具管历史,而"查发布状态"属于智能体自己够不到的实时外部世界。定位清楚了,文档才知道该向模型强调什么。
def get_deploy_status(service: str, env: str = "prod") -> str: """查询指定服务在目标环境的最新发布状态。 适用于:用户询问某服务是否已发布、发布到哪个版本、 或判断故障是否与近期发布相关时。 参数: service: 服务名,例如 "order-api"。 env: 目标环境,默认生产;可选 "prod"、"staging"。 返回: 一句话状态,含版本号、发布时间与最近一次变更摘要。 """ result = deploy_platform.query(service=service, env=env) # 你的业务实现 return f"{service}@{env}:版本 {result.version}," f"发布于 {result.time},变更摘要:{result.notes[:80]}"
注册与挂载只是把函数交给框架:client.tools.upsert_from_function(func=get_deploy_status),再把它加入智能体的工具清单。之后在对话里问"order-api 今天发过版吗",模型就会自行发起这次调用——它从文档里读懂了工具的用途与参数含义。
这段文档字符串有三个值得照抄的写法。用途段写"适用于":不只是定义功能,更圈定使用时机,模型据此判断"现在该不该用"。参数段给例子:例如 "order-api" 一句话,把格式歧义消解在源头。返回段说清形态:模型知道拿到的是"一句话状态",就知道怎么把它转述给用户。反面教材也顺手立此存照:把文档写成 def get_deploy_status(service, env): "查询状态"——"状态"是什么状态、"服务"是什么格式全无交代,模型用起来就是开盲盒。
工具与记忆的协作:闭环的另一半
自定义工具与记忆系统的配合,才是智能体形态的精髓。回到运维助理的场景:模型调用发布查询工具后拿到结果,接下来的动作展示了两种信息的不同去向——用户问的是当下状态,答案直接转述即可;但模型若发现"发布时间是十分钟前",它可能判断"故障与这次发布相关"值得记住,于是紧接着发起一次 archival_memory_insert,把"事故时间线:疑似与某次发布相关"写进档案。
工具负责当下,记忆负责沉淀。 工具调用结果的留存有个容易误解的点:调用轨迹本身会完整存入召回存储(作为事件流的一部分),不需要你操心"调用历史丢不丢";但语义层面的结论——"这次故障可能与发布相关"——不会自动成为智能体的长期认知,需要模型主动执行记忆写入,或由你在 persona 里引导"工具结果若影响判断,请记入对应记忆块"。引导这层协作的笔,始终握在写 persona 的人手里。
从观测视角再补一刀:工具调用是检验智能体"判断力"的最佳切片。轨迹里连续的工具调用序列,就是模型思路的显影——它先查什么、后查什么、拿到意外结果时怎么转向,全在序列里。给智能体做体检时,与其泛泛地聊,不如设计一个需要两三次工具协作的小任务,看它调用的顺序与取舍。工具用得有没有章法,比回答流畅与否更能说明这个智能体的成熟度。
工具设计的四条守则
最后把散落在前文的要点收成一份设计守则。其一,粒度宁小勿大:一个工具做一件事,组合交给模型——大而全的工具参数复杂、文档难写、模型易错。其二,返回值精炼:模型按 token 消化结果,返回几百行原始数据只会稀释注意力,先在函数里提炼。其三,失败要可读:异常信息返回"服务暂不可用,建议稍后重试"比抛出堆栈有用,模型能把可读的失败转告用户。其四,敏感操作加闸:删除、支付、对外发送类工具,在函数内部做二次确认或权限校验,永远不要把这类决定完全交给模型。
关于工具集成的常见疑问
问:一个智能体最多能挂多少工具? 机制上限宽松,工程上限在注意力:工具清单整体进入提示词,工具越多,模型选择时的干扰越大,选错的概率随数量上升。经验值是常驻工具控制在个位数;工具真的多,按任务场景拆智能体,每个专注一组工具。
问:工具执行很慢,会拖死对话吗? 会,所以要设防。慢工具(外部接口、重计算)应该在函数内部做超时控制与降级返回,把"工具暂时不可用"作为一种正常结果交还模型——它能对用户解释并给出替代路径。让模型干等一个无超时的慢调用,是最伤体验的实现方式。
问:工具能修改记忆块吗? 原则上不要。记忆编辑有专门的内置工具与校验闸门,业务工具绕开它们直改记忆,等于拆掉 2.3 节的防线。正确姿势是工具返回结论、由模型(或你的代码)再走正规记忆工具落笔——多一跳,但每一步都有轨迹可查。
本节要点回顾
- 翻译工序:模型只见文字说明不见代码,注册时从签名与文档生成工具说明,文档质量即工具上限。
- 文档三写法:用途圈定时机、参数给例子、返回说清形态,照抄即用。
- 协作精髓:工具管当下,记忆管沉淀;调用轨迹自动入召回,语义结论需主动写入。
- 设计四守则:粒度宁小勿大、返回精炼、失败可读、敏感操作加闸。
下一节处理时间维度:多会话之间状态如何保持一致,任务中断与并发写入如何不丢不乱。