5.1 显示过滤器语法详解:字段、运算符与求值
5.1 显示过滤器语法详解:字段、运算符与求值
解剖功夫(第 4 章)让人看懂一帧,筛子功夫让人从几百万帧里找到该看的那帧。本节把显示过滤器的语言系统讲透:字段从哪来、运算符有哪些、逻辑怎么组合、未定义怎么处理。它是 5.2 节套路清单与 5.3 节自动化的文法基础,也是全册使用频率最高的一节。
字段:过滤器的词汇表
显示过滤器操作的对象是字段树上的注册字段(3.3 节讲过来历),不是字符串。这意味着两件事:字段名必须真实存在(查户籍用 tshark -G field-names),字段带类型(数值、布尔、字符串、地址),运算符会按类型校验。常用词汇按层速记:
frame.len frame.protocols frame.time_delta eth.src eth.type vlan.id ip.src ip.dst ip.addr ip.ttl ip.flags.df ipv6.src ipv6.hop_limit tcp.srcport tcp.dstport tcp.port tcp.flags.syn tcp.window_size tcp.analysis.rto tcp.stream udp.port udp.srcport dns.qry.name dns.flags.rcode dns.a http.request.method http.response.code http.host tls.handshake.type tls.record.content_type
其中 ip.addr 与 tcp.port 是复合字段:前者等价于"源或目的任一匹配",后者等价于"源端口或目的端口任一匹配"。它们省字,但方向信息被抹掉——要区分方向时必须用原子字段 ip.src 与 ip.dst。
运算符:从精确到模糊的光谱
# 相等与不等 http.response.code == 504 dns.qry.name != "www.example.org" # 注意:!= 对复合字段有陷阱,见下文 # 数值比较 frame.len > 1500 # 超过常见 MTU 的帧,疑有巨帧或分片 tcp.analysis.rto > 1 # 重传超时超过一秒 # 集合归属 tcp.port in {80 443 8080 8443} # in 后的花括号里用空格分隔 # 子串与正则 http.request.uri contains "/admin" http.user_agent matches "(?i)curl" # PCRE 正则,(?i) 忽略大小写 # 存在性 http.cookie exists # 只看带 Cookie 的请求 # 布尔字段直接用 tcp.flags.syn == 1 等价于 tcp.flags.syn !tcp.flags.syn # SYN 位为零(含纯 ACK、FIN 等)
运算符还有一套等价英文写法(eq、ne、gt、lt、and、or、not),语义相同,混用合法但同一份过滤器里保持一种风格更可读。
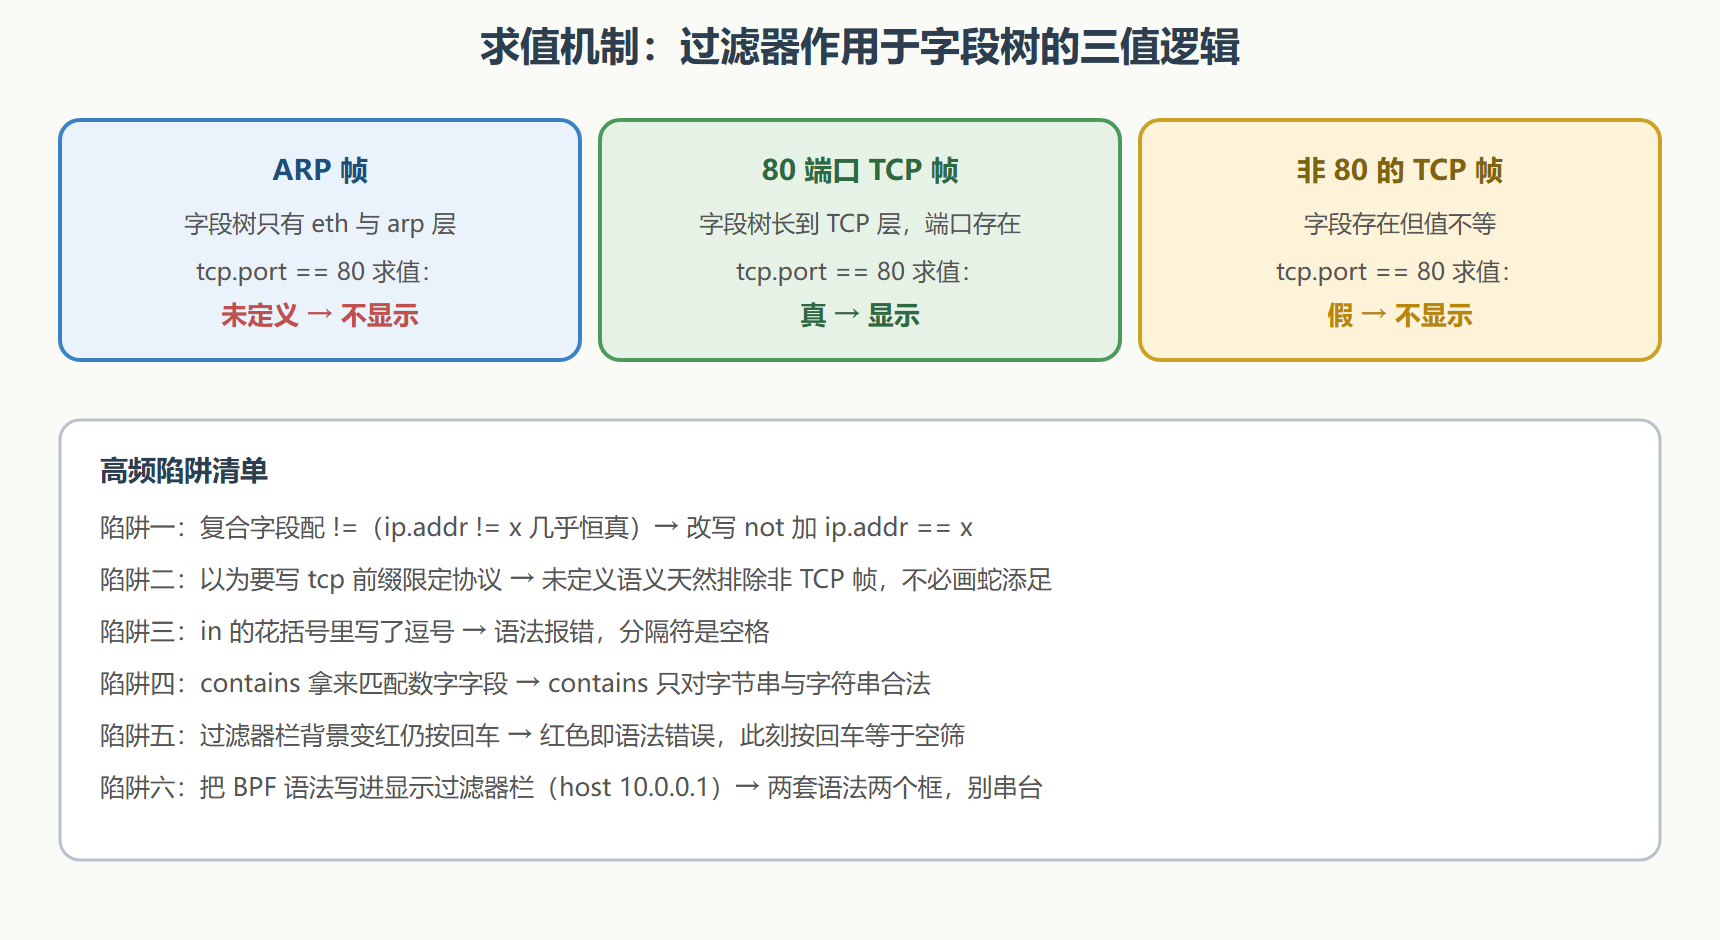
复合字段与 != 的陷阱是新人最常踩的坑。ip.addr != 10.0.0.5 的求值是"源不等于或目的不等于",几乎恒真——正确的"排除该地址全部流量"写法是 !(ip.addr == 10.0.0.5)。记一条军规:复合字段配 !=,多半不是你想要的意思,改用取反加相等。
逻辑组合:括号决定语义
&& 与 || 可以组合出任意条件,但人的直觉对优先级的把握不可靠,括号永远写全:
# 意图:来自内网、目标是 443 端口、且不是浏览器的流量 (ip.src == 192.168.31.0/24) && (tcp.dstport == 443) && !(http.user_agent matches "Mozilla") # 意图:DNS 失败或 TLS 警报,二选一即可 (dns.flags.rcode > 0) || (tls.record.content_type == 21)
地址可以用 CIDR 斜杠写法,时间类字段可以做减法组合(frame.time_delta > 0.5 表示与前一帧间隔超过半秒)。
未定义:既非真也非假
这是显示过滤器语义里最精妙的部分:在 ARP 帧上求 tcp.port == 80,结果不是假,而是"未定义"——这帧根本没有 TCP 层,字段不存在。未定义的帧一律不显示。理解它有两个推论:
其一,tcp.port == 80 不需要先写 tcp 来"限定协议"——非 TCP 帧天然落空。其二,取反要小心:!(tcp.port == 80) 并不是"80 之外的全部流量",而是"TCP 且端口非 80 的帧"加上"求值为真的非 TCP 帧"——实践中往往不符合直觉,需要排除某端口时更稳的写法是 not tcp.port in {80} 配合明确协议前缀。
切片与函数:进阶武器两件
切片用方括号取字节的片段,对协议分析很有用:
# 载荷前四个字节(十六进制比较,适合认魔术字) tcp.payload[0:4] == 13:0a:17:ff # 以太网目的地址的厂商前缀(OUI) eth.src[0:3] == 88:c9:d0
函数为表达式提供加工能力:len() 算长度、upper() 统一大小写、string() 做类型转换。典型用法:
# URI 去大小写后匹配 upper(http.request.uri) contains "/API/V2" # 载荷长度筛出可疑隧道(长而频繁) len(tcp.payload) > 512 && tcp.len > 0
语法报错的排修
过滤器栏背景红就是语法错误,常见三类排修路径:字段名拼错(查 tshark -G field-names);类型不匹配(数值字段用 contains);括号不配对(写复杂表达式时先写全括号再填内容)。命令行下 tshark 会直接指出错误位置:
$ tshark -r x.pcapng -Y "tcp.port in {80,443}" tshark: Unexpected character ',' in filter string. ^ <- 花括号内应为空格分隔
💡 建过滤器的工作流建议:先从一帧典型帧的详情树右键"作为过滤器引用"拿到合法字段,再逐步加条件缩小范围。从"字段 exists"起步,比从零默写正确率高得多。
构造演练:从需求到表达式的五步走
语法知识要落成"拿到需求就能写"的手感。走一遍完整的构造过程——需求:"找出内网里走老版本 TLS 的 Windows 客户端"。
# 第 1 步:拆需求成条件 # 内网 → 源地址段;老版本 TLS → 握手版本字段;客户端 → 握手发起方 # 第 2 步:每个条件找字段(查户籍,3.3 节的工具) $ tshark -G field-names | grep "tls.handshake.version" tls.handshake.version # 第 3 步:逐条试写,先各自单独验证命中量 ip.src == 192.168.0.0/16 # 命中 84 万:条件成立 tls.handshake.type == 1 # 命中 1.2 万:握手发起方字段选对 tls.handshake.version == 0x0303 # 命中 3400:版本字段选对 # 第 4 步:组合(括号写全) (ip.src == 192.168.0.0/16) && (tls.handshake.type == 1) && (tls.handshake.version == 0x0303) # 第 5 步:加产出字段,让结果直接可用 $ tshark -r mixed.pcapng -Y "(ip.src==192.168.0.0/16) && (tls.handshake.type==1) && (tls.handshake.version==0x0303)" \ -T fields -e ip.src -e tls.handshake.extensions_server_name | sort -u 10.0.3.8 mail.corp.example.cn 10.0.3.17 intranet.example.cn <- 两台内网机器仍在 TLS 1.2 上,整改对象出炉
五步法(拆条件、查字段、逐条验证、组合、配产出)的价值在第 3 步:逐条验证让每个条件的命中量可见,组合后数量异常时能立刻定位是哪个条件出了问题——比直接写长表达式再猜错在哪高效得多。
结案要点
- 过滤对象是字段不是字符串:字段查户籍,类型定运算。
- 复合字段省字但抹方向,配 != 几乎必错,改用取反加相等。
- 未定义不显示:天然协议感知,也解释了取反的微妙。
- 切片与函数是两件进阶武器:魔术字识别、统一大小写、按长度筛。
- 红色背景即语法错误:排修三查——字段名、类型、括号。
文法在手,下一节是成套的断案表达——按案情组织的过滤器套路清单。