8.2 大文件性能调优:让仪器扛住百万帧
8.2 大文件性能调优:让仪器扛住百万帧
三小时的镜像口捕获轻松过百万帧、上 GB,GUI 打开就开始转圈。本节把"卡"拆成四个来源,给出按性价比排序的调优五步,并把分片流水线与统计先行的策略组装起来。它综合了 3.4 节的呈现段开关、7.1 节的管道姿势与 2.2 节的整备工具——大现场勘验是全书技能的汇合点。
卡顿从哪来:四个来源
解析成本:每帧都要长字段树,百万帧就是百万棵树。这是不可回避的固定成本,只能靠"少解析不关心的帧"来摊薄。
内存驻留:解析结果驻留内存支撑交互(过滤、跳转),文件大小与内存占用大致同数量级放大。内存吃满后系统换页,卡顿从"慢"变成"死"。
渲染成本:列表滚动、着色求值、名称解析——3.4 节讲过的呈现段三慢源,在百万帧下被放大百万倍。
状态累积:会话表、重组缓冲随流数量增长;3.3 节讲过"解剖刀有状态",状态就是内存。
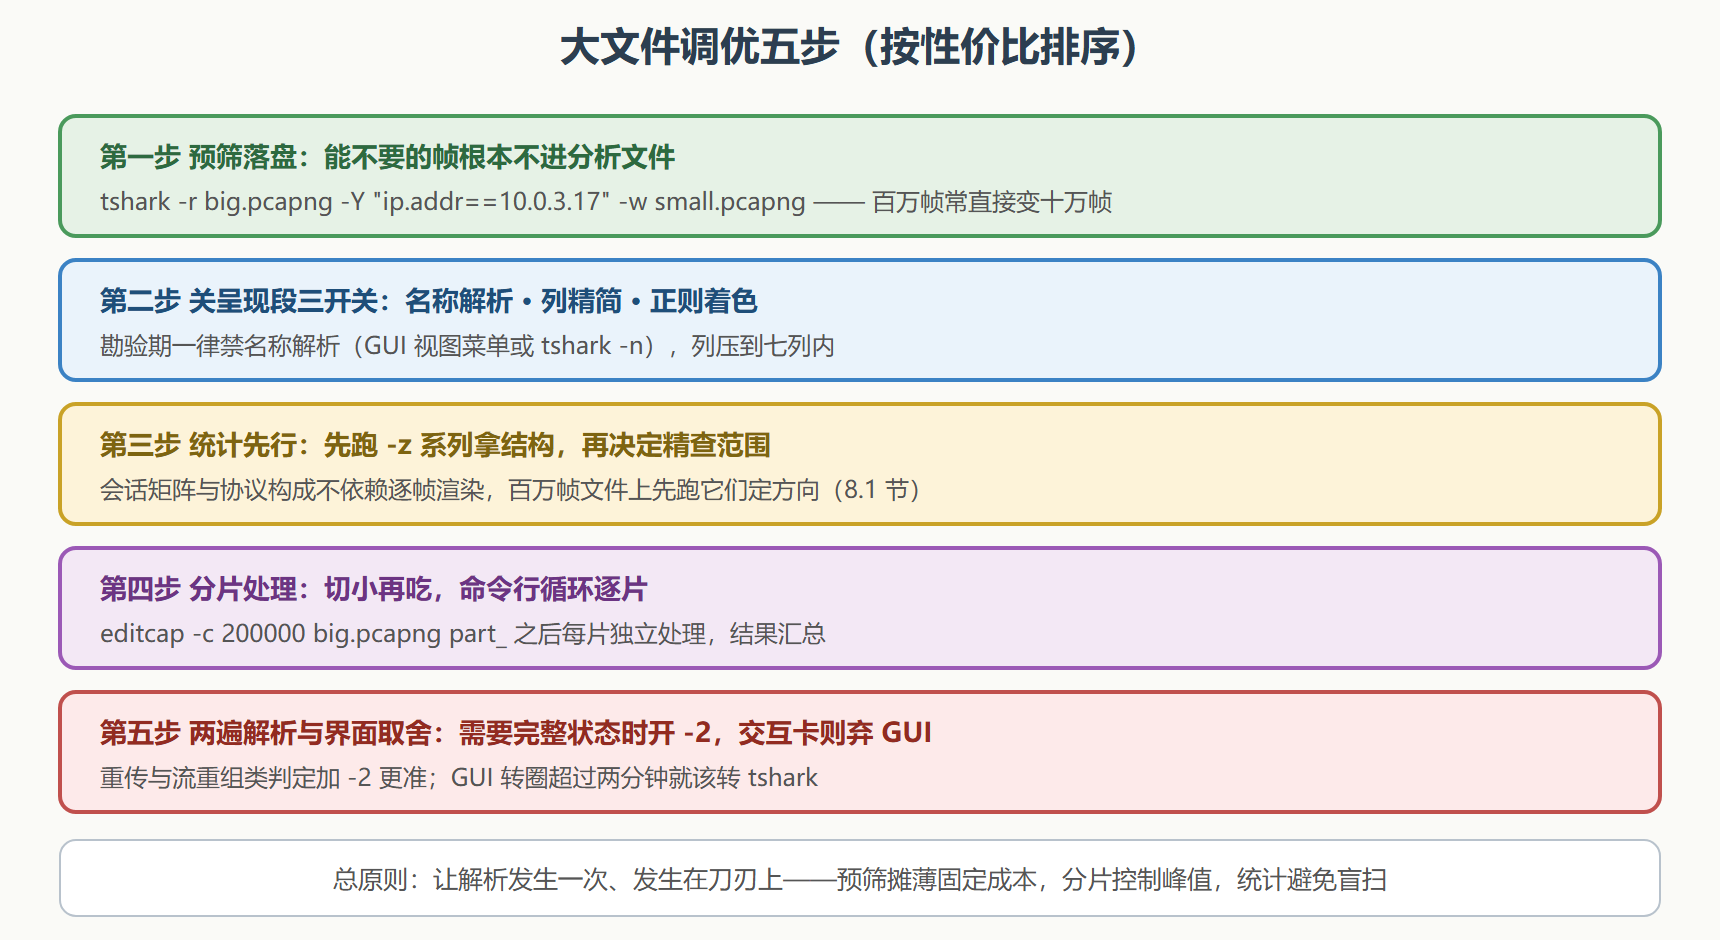
五步的实战展开
**预筛是第一杠杆。**案子都有明确对象(一台主机、一个网段、一个端口),第一件事就是把对象之外的全部扔掉:
$ tshark -r big.pcapng -Y "ip.addr == 10.0.3.17 || ip.addr == 203.0.113.25" \ -w focused.pcapng 4618282 -> 384117 帧(缩到不足十分之一)
注意预筛用的是 -Y(读后筛),因为现场往往只有成品文件;下一轮采集要提前用 -f 把筛子搬到门口(5.3 节的参数位之分)——同样的过滤条件,捕获期执行成本近乎零。
**分片流水线。**没有明确对象的普查型案子(安全案常态),按 7.1 节的管道思路逐片处理:
# 切片:每片二十万帧 $ editcap -c 200000 big.pcapng part_ # 逐片跑同一统计,结果追加 $ for f in part_*.pcapng; do echo "== $f" >> census.txt tshark -r "$f" -q -z conv,tcp >> census.txt done # 片间连续性:会话跨片的合并问题——普查统计可忽略, # 精查某条流时用 tcp.stream 的流过滤器先在全量上定位,再取该片
分片的代价是"跨片会话被切断",普查类统计(会话矩阵、端点排行)对此不敏感,按流精查时回到全量文件配合流编号即可。
**统计先行的性价比。**给三种分析方式的耗时排个序(同一份百万帧文件的实际量级感受):
纯统计(-z conv / io,phs) 快:一遍线性扫描,无交互渲染 字段导出(-T fields 带 -Y) 较快:线性加过滤 GUI 交互打开 慢:解析驻留加渲染,内存吃紧时不可用
所以工作流的正确顺序是统计拿结构、导出做核对、GUI 只在收窄后的小文件上登场——这也是 8.1 节"统计先行"在性能维度的理由。
内存与版本:两条工程边界
内存判断的经验法则:预留文件体积两到四倍的内存余量再谈 GUI 交互。一 GB 的文件配四 GB 余量的机器勉强流畅;swap 开始工作就该换命令行。另一个常被忽视的杠杆是版本升级——解析引擎的性能优化几乎每个大版本都有,老版本上"卡到不能用"的文件,新版常常直接打开。升级零成本,永远排在手工优化之前。
⚠️ 高码流长跑采集还有个前置问题:文件大小本身。环形缓冲(2.1 节)控制磁盘预算,捕获过滤控制进门量;等文件长到几十 GB 再想"筛一筛",传输它都是负担。大文件问题的一半要在采集端预防,这是 2.1 节与本节的呼应。
一次调优的完整会话
把五步走一遍,用真实数字感受各步的收益。案情:镜像口抓了两小时,文件 3.8 GB,GUI 打开十分钟仍在转圈。
# 第 0 步:先看体检报告,确认没有采集质量问题 $ capinfos big.pcapng | grep -E "packets|duration|order" Number of packets: 4182233 Capture duration: 7112.4 seconds Strict time order: True <- 文件本身健康,是纯分析性能问题 # 第 1 步:案子只关心两台服务器之间的往来,预筛落盘 $ tshark -r big.pcapng -Y "ip.addr==10.0.3.17 && ip.addr==203.0.113.25" -w focused.pcapng 4182233 -> 214873 帧,文件 210 MB <- 缩到百分之五 # 第 2 步:GUI 打开 focused.pcapng,关掉名称解析,列压到七列 # (视图菜单的名字解析全部取消勾选) # 结果:能滚动,但跳转到第 20 万帧仍有两三秒延迟 # 第 3 步:回答"重传集中在何时"根本不用打开 GUI $ tshark -r focused.pcapng -q -z io,stat,60,"COUNT(tcp.analysis.retransmission)" \ | sed -n '5,11p' | Interval | Frames | Bytes | COUNT | | 0000.000-0060.000 | 14122 | 9.2M | 3 | | 0420.000-0480.000 | 28110 | 18.9M | 512 | <- 第 7 分钟爆发 | 0480.000-0540.000 | 11844 | 7.1M | 487 | <- 延续一分钟 | 1020.000-1080.000 | 13998 | 9.0M | 4 | # 第 4 步:把爆发窗口切出来精查 $ editcap -A "2026-09-04 10:15:00" -B "2026-09-04 10:17:00" focused.pcapng burst.pcapng # 412 帧,GUI 秒开,逐帧解剖与账本推演从这里开始
四步下来,"3.8 GB 打不开"变成"412 帧的精查现场",全程十来分钟。注意第 3 步的哲学:问题问得越具体,需要的帧越少——"重传在何时"只需要计数,不需要渲染。
常见疑问
**问:预筛会不会把证据筛丢?**会,所以预筛只用在两个前提下:案由明确(知道要证明什么)、原件仍在(筛出来的是工作副本)。取证案一律先封存原件再预筛,与 6.2 节的纪律一致。
**问:分片后想看一条跨片的流怎么办?**先用流编号定位:在全量文件上跑 tshark -r big.pcapng -Y "过滤条件" -T fields -e tcp.stream | sort -u 拿到流号,再用 tcp.stream eq N 配合时间窗取片。流编号是跨片的锚(3.3 节的会话状态赋予的便利)。
**问:机器内存不小,还非得这么折腾吗?**五步的成本其实是时间管理问题:统计与预筛在命令行里跑着,你可以同时干别的;GUI 转圈的十分钟是纯等待。性能调优调的是人的时间,不只是机器的时间。
**问:两遍解析什么时候必须开?**判定依赖"前后文"的分析都受益于两遍:重传标记的完整化、跨帧协议的重组(如分片的 HTTP 或大 TLS 记录)。tshark 用 -2 显式开启,代价是文件要完整读两遍——大文件上按需使用,不是默认姿势。
结案要点
- 四个成本来源:解析、内存、渲染、状态——前三者可摊薄,第四者随流数增长。
- 五步按性价比:预筛、关三开关、统计先行、分片、两遍解析与弃 GUI。
- 筛子能早就早:-f 在门口近乎零成本,-Y 读后筛是补救。
- 普查用分片,精查回全量:流编号是跨片的锚。
- 升级先于优化,内存余量两到四倍:两条工程边界。
仪器扛住大现场之后,最后一节把全部功夫收束成可复用的判定路径——故障排查模式库。