第4章 · 数据层高并发与高可靠
第 4 章 · 数据层高并发与高可靠
章节摘要:数据层是高并发系统最容易被打穿的一层——数据库扛不住读写、缓存一崩全站雪崩。这一章讲两个核心手段:缓存体系(多级缓存、热点防护),数据库扩展(读写分离、分库分表)。重点理解缓存不是万能药,它带来三类新故障(击穿、穿透、雪崩),每类都要有对应的防护;分库分表能扩容但引入分布式事务的代价,要权衡。
学习目标
阅读完本章,你应当能够:
- 设计一个多级缓存体系
- 说清缓存击穿、穿透、雪崩三类故障的成因和防护
- 理解读写分离的原理和主从延迟带来的一致性问题
- 设计一个分库分表方案,理解分片键的选择
- 权衡分库分表带来的分布式事务代价
核心概念速览
数据层高并发的两大支柱:缓存挡住大部分读、分库分表分散写。但两者都引入新问题,防护比建设更重要。
子章节导航
4.1 缓存体系与热点防护
讲多级缓存(本地+分布式)、缓存更新策略,重点是三类缓存故障——击穿(热点 key 过期)、穿透(查不存在的 key)、雪崩(大量 key 同时过期)——各自的成因和防护手段。
4.2 数据库扩展与分库分表
讲读写分离(主写从读、主从延迟的一致性权衡)、分库分表(垂直拆分、水平分片、分片键选择)、以及分库分表引入的分布式事务代价。
子章节之间的逻辑关系
4.1 用缓存扛读压力,4.2 用拆分扛写压力和存储压力。读多写少的系统重点在 4.1,写多的系统重点在 4.2。
4.1 缓存(扛读) + 4.2 分片(扛写与存储)
前置知识与后续延伸
- 前置知识:前三章的架构和应用层知识。
- 后续延伸:数据层扛住了,第 5 章讲怎么让整个系统扛得住故障(容灾和韧性)。
延伸:读扩展与写扩展的分道扬镳
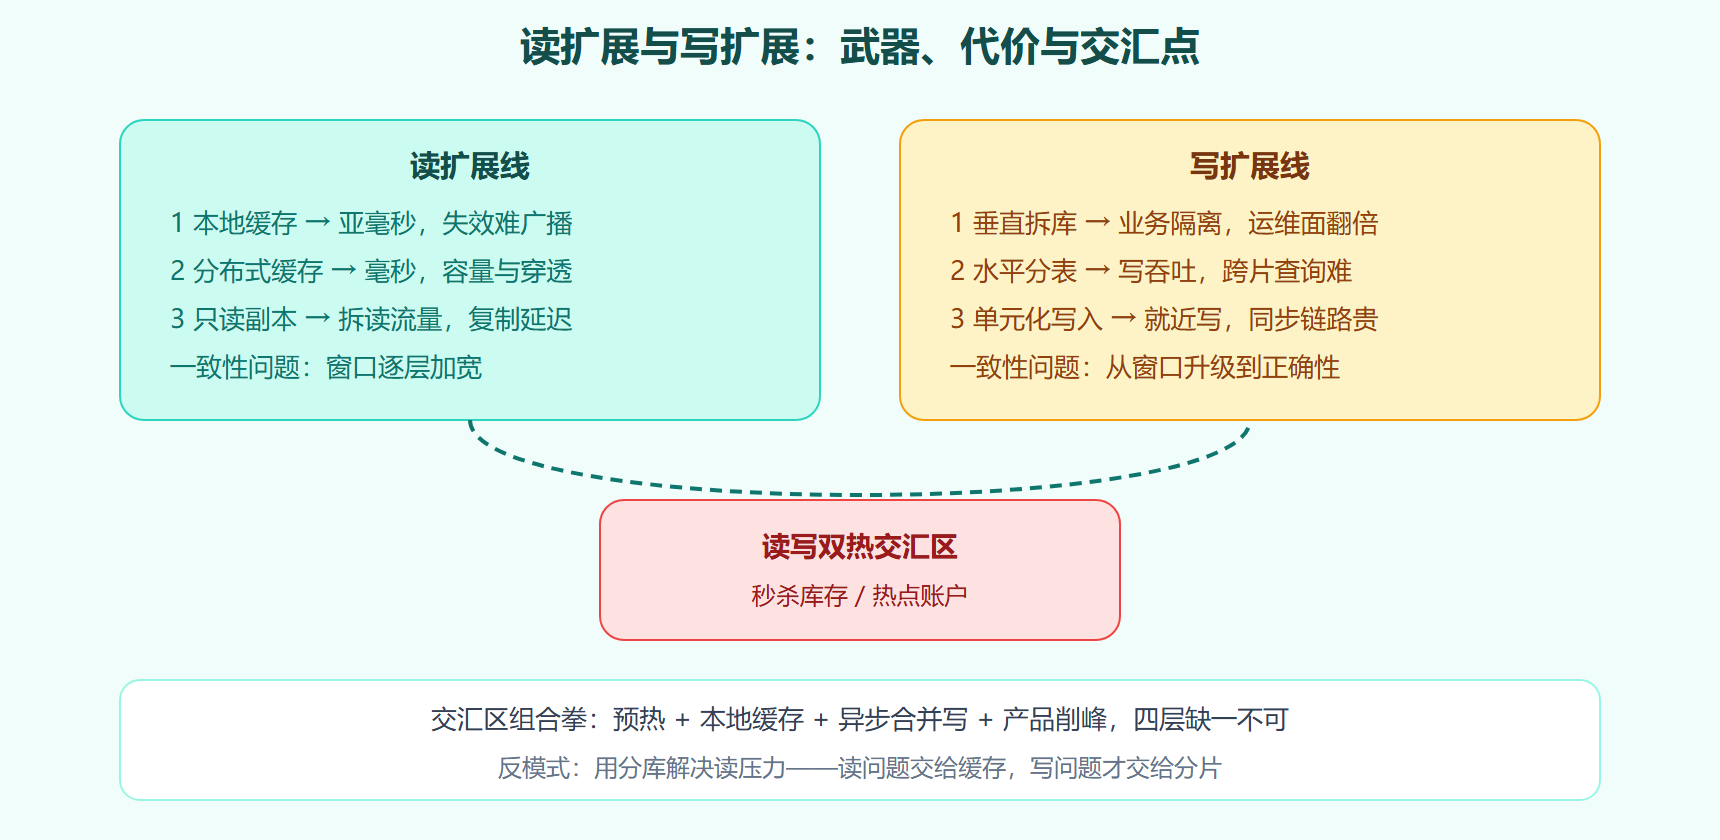
数据层的所有招式,归根到底是在分别回答"读怎么扩"和"写怎么扩"两个问题,把两条线分开看会清晰很多。读扩展的武器库是缓存序列:本地缓存、分布式缓存、只读副本、物化视图,一层层把读流量从主库身上剥离,代价是一致性窗口逐层变宽。写扩展的武器库是分片序列:垂直按业务拆库、水平按分片键拆表、再到单元化写入,每一步都在缩小单点写入的压力,代价是跨片事务和全局查询的能力折损。两条线独立演进,互不阻塞——多数系统死在"想用一个方案同时解决读写",比如为了写吞吐引入分库,却把本可以用缓存解决的读压力也拖进了分片复杂度里。
两条线的交汇点是热点:读热点用缓存防护,写热点用分片打散,但总有一类"读写双热"的数据(秒杀库存、明星动态)需要组合拳——预热、本地缓存、异步合并写、以及产品层面的削峰设计。这类场景没有银弹,只能靠分层组合把每一层压力都压在阈值之下。下面的对比图把两条线各自的能力与代价并排铺开,做容量规划时可以直接对照。
图:读扩展与写扩展的路线对比
本章两节是递进关系:缓存解决读、分片解决写,先缓存后分片的次序不能颠倒——很多团队跳过缓存直接分库,把读压力一起拖进分片复杂度,事后回头补缓存时又要处理分片环境下的缓存一致性,难度翻倍。学完自检三个问题:你的系统里最热的十个键是什么、它们的一致性预算各是多少、分片键选了什么理由是什么。三个问题都有书面答案,数据层的功课才算做完。
还有一个跨层视角值得点破:缓存和分片的组合存在顺序依赖,先缓存后分片能省下的不只是成本,还有决策空间——缓存把读压力降下来后,很多时候发现根本不需要分库,读写分离加垂直拆库就够了。跳过缓存直奔分片的团队,等于是用最贵的方案解决最便宜的问题,还把后续所有查询能力都锁死了。这也是把"先读后写"作为本章阅读次序的原因。
最后点一个和数据团队的协作约定:缓存的键规范和数据层的表规范要统一维护,键名里带表名和版本号,表结构变更时缓存键同步升版。见过键规范各自为政的团队,一次字段类型调整后新旧缓存键并存,排障花了一周才发现是两个团队各改各的。规范统一这类小事,越是高并发系统越是保命的细节。
数据层还有一个跨章对比值得回味:缓存的"分层口袋"和第 5 章容灾的"阶梯"是同构的思想——都是按数据的温度和代价分级安置,只不过一个按访问热度、一个按故障影响。看清这个同构,两章的方案就可以互相借用:容灾的分级思路用来决定哪些数据进缓存主从、哪些只留单副本;缓存的一致性预算思路反过来约束多活环境的数据同步优先级。架构思想的高级形态就是这样跨域复用。