4.1 缓存体系与热点防护
4.1 缓存体系与热点防护
本节摘要:缓存是数据层扛高并发的第一道防线,它挡住了大部分读请求不打到数据库。本节讲多级缓存体系(本地缓存加分布式缓存)、缓存更新策略,重点是缓存带来的三类典型故障——击穿、穿透、雪崩——它们的成因和防护。核心认知:缓存不是越多越好,引入缓存的同时必须配套防护三类故障,否则缓存本身会成为新的故障源。
学习目标
阅读完本节,你应当能够:
- 设计一个多级缓存体系,说清每层的职责
- 说清缓存击穿、穿透、雪崩的成因差别
- 给出每类缓存故障的防护手段
- 理解缓存更新策略(Cache Aside、Write Through)的取舍
- 判断哪些数据适合缓存、缓存多久
一、问题与直觉
大部分互联网应用的读写比是极度不对称的——读远多于写。一个电商商品页,可能被读上万次,但商品信息一天才更新几次。如果每次读都查数据库,数据库早就扛不住了。
缓存的思路就是:把读多写少的数据放在更快的存储里(内存),读请求优先查缓存,命中就直接返回,不打数据库。一个配得好的缓存,命中率能到 90% 以上,意味着 90% 的读请求根本不碰数据库,数据库压力直接降一个数量级。
但缓存不是加上就万事大吉。它引入了三类新的故障:击穿、穿透、雪崩。这三类故障的共同特点是——它们不是数据库本身的故障,而是缓存机制设计不当导致的。一个没做防护的缓存,在大促时反而会成为雪崩的导火索。理解这三类故障和防护,是这一节的核心。
二、核心原理
2.1 多级缓存体系
生产环境通常用多级缓存,每一级速度和容量不同,互相配合。
本地缓存:在应用进程内存里的缓存(如 Guava Cache、Caffeine)。速度最快(纳秒级),但容量小、多实例不共享。适合缓存极热点的少量数据。
分布式缓存:独立的缓存服务(如 Redis 集群)。速度较快(毫秒级),容量大、多实例共享。是缓存的主力。
数据库:最终的数据源。速度最慢,但数据最全最准。
读请求的查找顺序:先查本地缓存,命中返回;未命中查分布式缓存,命中返回并回填本地缓存;仍未命中查数据库,返回并回填两级缓存。这个多级结构,让最热的数据在本地缓存(最快),次热在分布式缓存,冷的才查数据库。
2.2 缓存更新策略
缓存里的数据和数据库的数据怎么保持一致?这是个经典问题。常见的策略有几种。
Cache Aside(旁路缓存):最常用的策略。读时先查缓存,未命中查数据库并回填缓存;写时先更新数据库,再删除缓存(注意是删不是更新)。为什么是删不是更新?因为更新缓存可能涉及复杂计算,且并发更新会有竞态条件;删除更简单——下次读时自然回填最新值。
Write Through(写穿透):写时同时更新数据库和缓存。缓存永远是最新的,但写入开销大。适合写少读多的场景。
Write Behind(写回):写时只更新缓存,异步批量刷回数据库。写入快,但有数据丢失风险(缓存挂了没刷回的数据丢了)。适合容忍丢失、写量大的场景(如日志)。
| 策略 | 写操作 | 一致性 | 适用场景 |
|---|---|---|---|
| Cache Aside | 更新库+删缓存 | 最终一致 | 通用主流 |
| Write Through | 更新库+更新缓存 | 强一致 | 写少读多 |
| Write Behind | 只更新缓存 异步刷库 | 弱一致 | 容忍丢失 |
2.3 三类缓存故障与防护
这是本节的重点。缓存引入的三类故障,成因不同,防护手段也不同,必须区分对待。
缓存击穿:某个热点 key(如首页推荐)在过期的瞬间,大量并发读同时发现缓存失效,全部去查数据库,数据库瞬间被压垮。防护:热点 key 不设过期(或后台异步刷新),或用互斥锁——缓存失效时只让一个请求查数据库回填缓存,其他请求等。
缓存穿透:查询一个根本不存在的数据(如不存在的商品 ID),缓存里没有,数据库里也没有,每次都查到数据库。如果有人恶意构造大量不存在的 ID 请求,数据库被压垮。防护:把查不到的结果也缓存(缓存空值,设短过期),或用布隆过滤器预先过滤掉一定不存在的 key。
缓存雪崩:大量 key 在同一时刻过期(或缓存服务整体故障),所有请求全打到数据库,瞬间压垮。和击穿的区别是规模——击穿是一个热点 key,雪崩是大量 key。防护:给 key 的过期时间加随机扰动(避免同时过期),缓存服务做高可用集群,做限流兜底(数据库前的最后一道防线)。
| 故障类型 | 成因 | 规模 | 防护手段 |
|---|---|---|---|
| 击穿 | 热点 key 过期瞬间 | 单个 key | 互斥锁/不过期/异步刷新 |
| 穿透 | 查不存在的数据 | 持续 | 缓存空值/布隆过滤器 |
| 雪崩 | 大量 key 同时过期/缓存宕机 | 大面积 | 过期时间加随机/高可用/限流 |
三、工程实践要点
3.1 缓存命中率是核心指标
缓存配得好不好,看一个核心指标:命中率(命中缓存的请求占总请求的比例)。命中率 90% 意味着只有 10% 打到数据库;命中率 50% 意味着一半打到数据库,缓存价值大减。
提升命中率靠几个手段:合理设过期时间(变化慢的数据过期长)、预热热点(大促前把热点数据提前加载进缓存)、合理的缓存粒度(别太细导致命中率低,别太粗导致更新频繁)。
3.2 一致性权衡
缓存和数据库的一致性是个永恒权衡。强一致(任何时刻缓存和数据库完全一致)开销大、复杂度高,大多数场景不值得。最终一致(短暂不一致,最终会一致)是主流选择——用 Cache Aside 策略,接受短暂不一致,换取性能和简单。
关键是识别哪些场景必须强一致(如金融余额),这些场景要么不用缓存,要么用复杂的强一致方案;其他场景接受最终一致即可。
3.3 限流是缓存失效的最后兜底
即使做了击穿、穿透、雪崩的防护,仍可能有意外导致大量请求打到数据库。这时数据库前要有一道限流——超过数据库承受能力的请求直接拒绝,保住数据库不挂。数据库挂了是灾难性的(全站不可用),限流拒绝部分请求(降级)是可接受的代价。
⚠️ 常见坑:只加缓存不做防护,大促时热点 key 过期引发击穿,或大量 key 同时过期引发雪崩,缓存反而成了雪崩导火索。引入缓存的同一步,就要配套击穿穿透雪崩的防护,别留缺口。
💡 关键直觉:缓存是用“数据可能短暂不一致”和“三类新故障风险”换“读性能大幅提升”。这笔交易在读写比悬殊的场景非常划算,但前提是你把三类故障防护做齐了。没做防护的缓存,是埋在系统里的定时炸弹。
本节要点回顾
- 多级缓存:本地缓存(最快,不共享)+分布式缓存(Redis,共享)+数据库,逐级查找。
- 更新策略:Cache Aside(删缓存,主流)、Write Through(强一致)、Write Behind(异步刷库)。
- 击穿:热点 key 过期瞬间并发查库,防护用互斥锁或不过期。
- 穿透:查不存在的数据打到库,防护用缓存空值或布隆过滤器。
- 雪崩:大量 key 同时过期或缓存宕机,防护用过期时间加随机和高可用。
- 命中率:缓存价值的核心指标,靠合理过期、预热、粒度提升。
- 限流兜底:数据库前最后防线,保库不挂比保所有请求重要。
下一节讲数据库本身的扩展——读写分离和分库分表,解决单库扛不住的问题。
多级缓存的一致性预算
多级缓存的核心矛盾是性能与一致性的交换,每加一层缓存,就用更宽的一致性窗口换更快的响应,这个交换要有意识地进行。工程上建议给每个缓存层写"一致性预算":本地缓存允许过期五秒,分布式缓存允许过期一分钟,两者叠加后用户看到的数据最多滞后一分零五秒——这个数字要和业务方确认过能不能接受。交易类数据(库存、价格)超预算就不能进本地缓存,甚至不能进任何缓存;展示类数据(昵称、头像)预算宽裕,可以放心多级叠加。预算的执行靠失效策略:短过期兜底、关键变更主动失效、跨实例失效用消息广播——三者是冗余关系,层层兜底,任何一层失灵都不至于数据永久错乱。
热点防护还有一个进阶话题:热点的发现要自动化。人工维护的热点白名单永远落后于真实流量,明星结婚这种热点无法预知。方案是对访问日志做实时统计,键的访问频率超过阈值自动进入"热点模式"——本地缓存延长过期、拆分子键分散到多个缓存节点、极端情况切换为静态化响应。热点模式要有自动退出机制,热度回落后恢复正常策略,否则本地缓存越积越多,内存先撑不住。
图:多级缓存的一致性窗口叠加
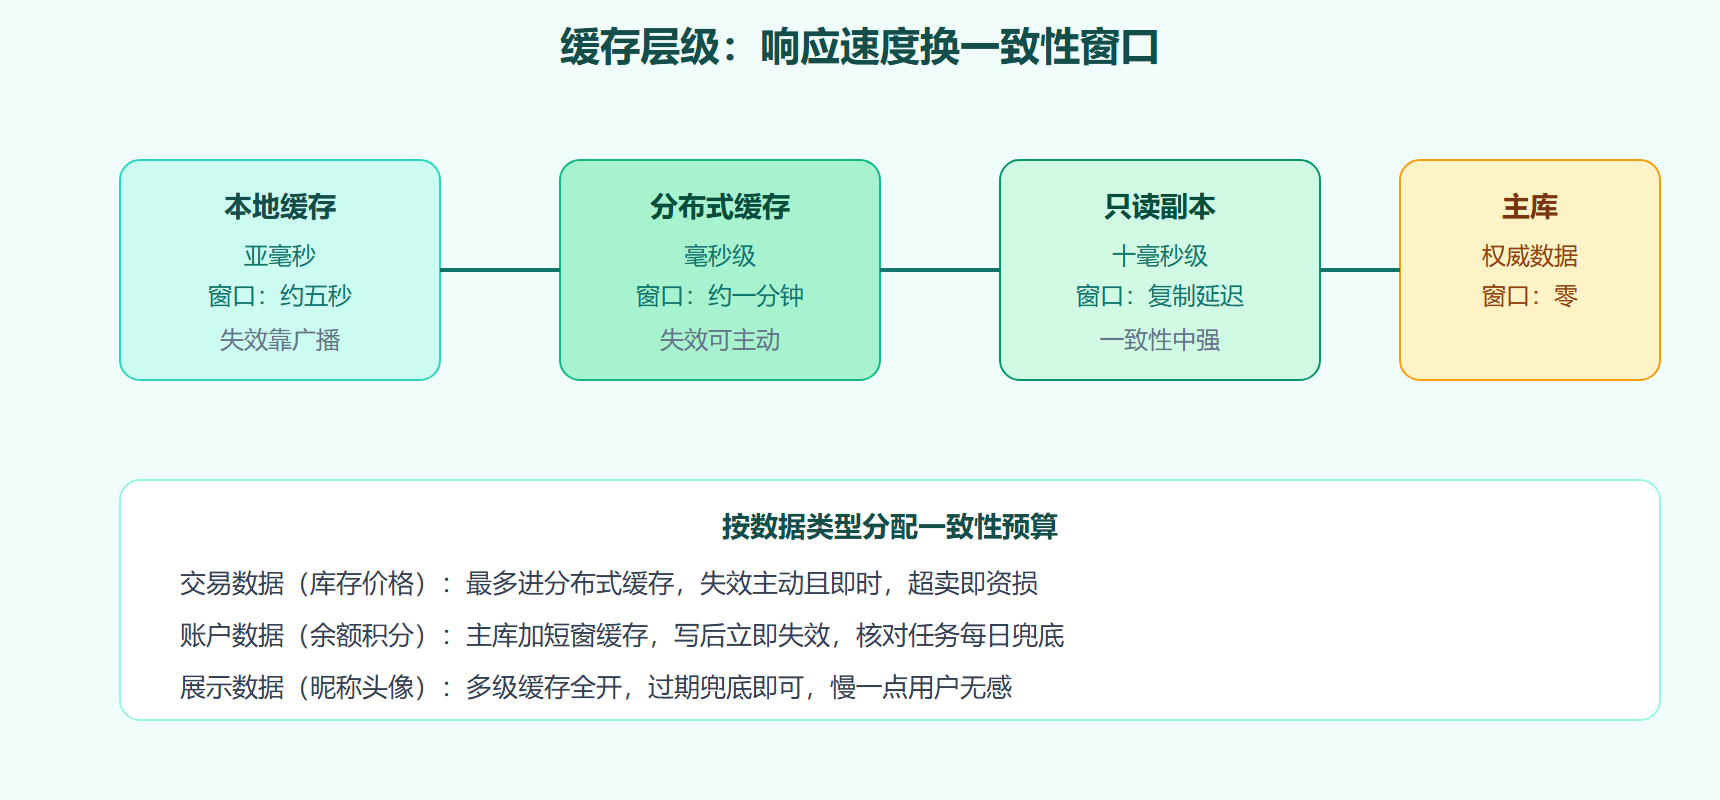
图里的分派原则可以直接抄进团队的缓存规范:每类数据上线前先声明类型、领预算、定失效策略,三样填齐才允许接缓存。见过太多事故的起因就是某条"顺手加个缓存"的优化,没分类没预算,最后在交易数据上栽了跟头。
最后提一下缓存的高可用本身:缓存集群故障时,全部流量穿透到数据库,往往是雪崩的开始。防护要点有二:一是客户端熔断加本地兜底——缓存集群不可用时自动切换到本地快照(哪怕数据旧一点),保护数据库不被打死;二是缓存的预热与逐步放量——故障恢复后不能瞬间全量回源,要按百分比爬坡。把缓存当成一个会故障的独立系统来设计它的降级预案,而不是默认它永远在线,这个观念在多数团队里都值得补课。
缓存运维还有个值得养成的习惯:给缓存集群做"定期断网演练"。方法是在测试或预发环境模拟缓存全不可用,观察数据库水位的瞬时变化和恢复路径。这个演练能回答一个平时没人知道答案的问题——缓存挂了系统还能撑多久。答案是三十秒和三十分钟,对应的容灾投入完全不同;而多数团队在真实故障发生前,从来没有量过这个数字。