第5章 · 可靠性与韧性工程
第 5 章 · 可靠性与韧性工程
章节摘要:高并发系统不只是要跑得快,更要扛得住故障——机房断电、网络抖动、依赖服务挂掉,这些都会发生。这一章讲怎么让系统具备韧性:容灾多活(同城双活、异地多活,故障时自动切换)和混沌工程(主动注入故障验证系统韧性)。核心认知:故障不可避免,关键是怎么让它在用户无感的情况下被吸收。
学习目标
阅读完本章,你应当能够:
- 区分同城双活、两地三中心、异地多活几种容灾架构
- 理解故障域隔离的原理和实现
- 说清混沌工程的核心思想和价值
- 设计一个故障注入实验验证系统韧性
- 建立“故障必然发生,设计要能吸收故障”的认知
核心概念速览
韧性不是“不发生故障”(不可能),而是“故障发生了用户无感”。这靠容灾兜底加混沌验证。
子章节导航
5.1 容灾多活与故障隔离
讲几种容灾架构(同城双活、两地三中心、异地多活)的原理和代价,以及故障域隔离——怎么把故障限制在局部不蔓延。
5.2 混沌工程与韧性测试
讲混沌工程的核心思想(主动注入故障,验证系统真实韧性),它和传统测试的差别,以及怎么做一次故障注入实验。
子章节之间的逻辑关系
5.1 讲怎么建(容灾架构),5.2 讲怎么验(混沌工程)。前者是韧性工程的建设,后者是韧性工程的验证,缺一不可——没验证过的容灾,真故障时未必切得过去。
5.1 容灾建设 + 5.2 混沌验证
前置知识与后续延伸
- 前置知识:前四章的架构、应用层、数据层知识。
- 后续延伸:第 6 章讲可观测性——怎么看得清系统状态,才能知道故障发生和容灾切换是否生效。
延伸:三种容灾等级的投入产出
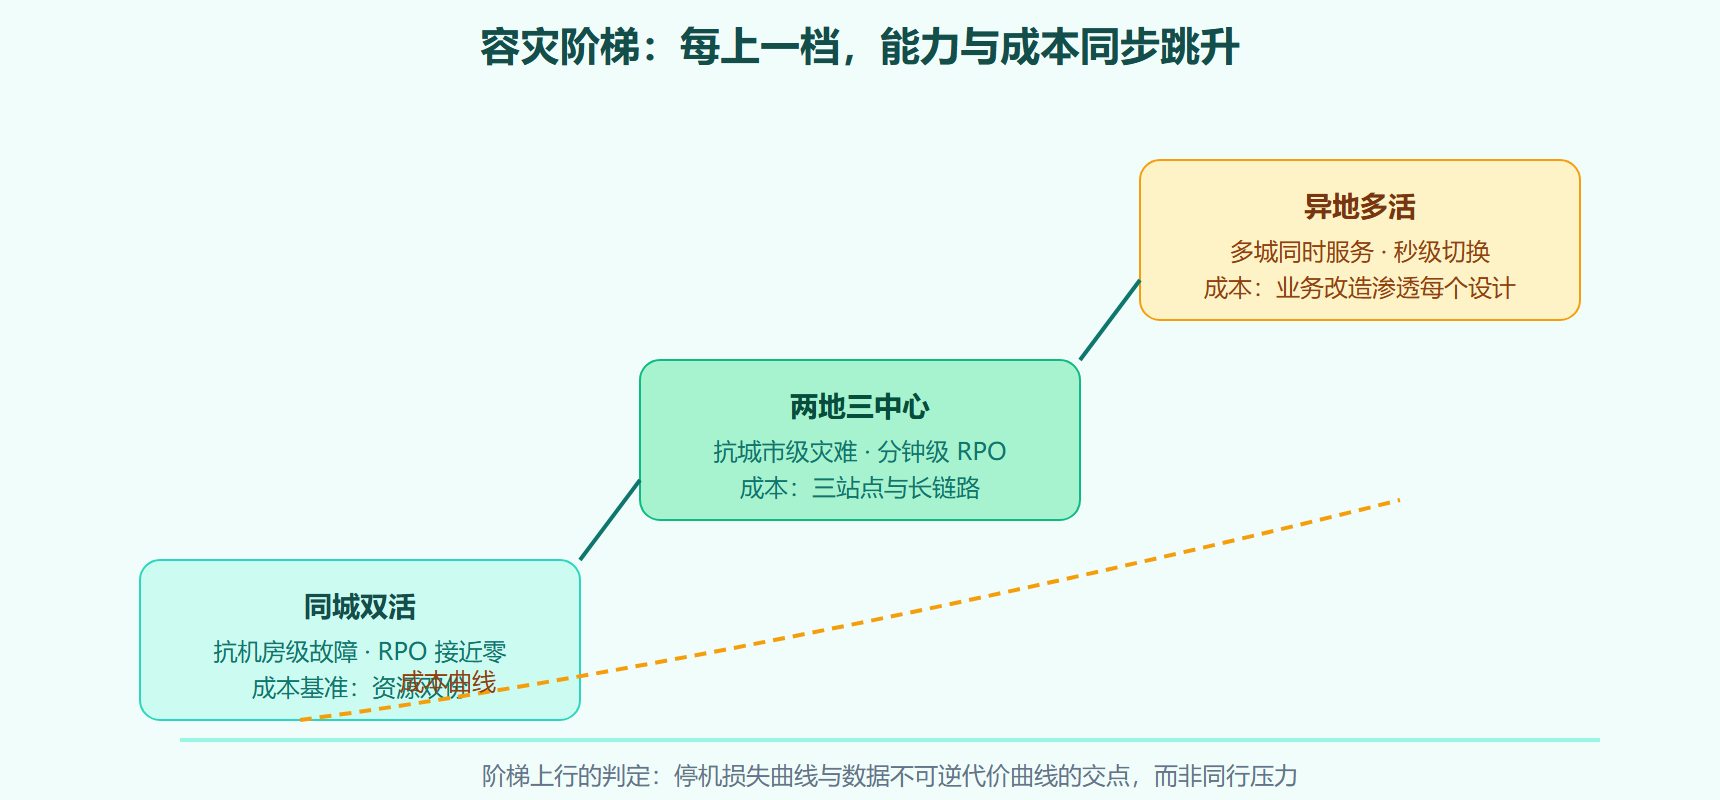
容灾不是二元选项,同城双活、两地三中心、异地多活是投入差一个数量级的三档,对比清楚才能选对。同城双活解决机房级故障,两个机房延迟两毫秒以内,数据同步几乎无感,建设成本主要是双份资源和链路,是大多数业务的第一步。两地三中心解决城市级灾难,异步复制带来分钟级数据丢失窗口,适合能容忍这个窗口的业务。异地多活则是终极形态,多个城市同时承载流量、数据双向同步,城市故障时分钟级切换且几乎不丢数据——但它的成本不只是多倍资源,更是把一致性约束渗透进每个业务设计里,没有强组织能力的团队很难驾驭。
选档位的判断依据是"单位时间停机的业务损失"和"数据丢失的不可逆代价"两条曲线的交点。社交信息流丢一分钟数据无伤大雅,交易系统丢一分钟订单就是资损事故,前者停在两地三中心绰绰有余,后者才有资格谈多活。常见误区是倒过来——用交易级的要求建设全部业务,成本失控后削减真正核心链路的投入,得不偿失。分级的纪律比升级的雄心更重要。
图:容灾三档的能力与成本阶梯
两节之间的关系再点一句:容灾多活是"结构",混沌工程是"验证",前者建设故障下的生存能力,后者持续检验这个能力是不是真的存在。只做结构不验证的容灾体系,会在真实故障时暴露演练从未覆盖的链路;只做验证不建结构的团队,则永远在给一副没有韧性的骨架做体检。两件事交替推进——每次演练暴露的短板驱动下一轮容灾建设,才是韧性工程的正循环。
最后提示一个资源分配的经验比例:韧性建设的投入,七成应该花在频率高影响小的故障上(网络抖动、实例宕机、依赖超时),三成花在频率低影响大的灾难上(机房级、城市级)。反过来分配的团队,日常小故障不断却把预算都花在"永远不会来"的大灾备上,用户体感反而更差。韧性是日常体验,不是极端表演。
本章两节学完后,建议做一次"韧性资产负债表"盘点:列出系统所有单点(每个单点标注有无备份、有无切换预案、预案有无演练过),三个"有无"层层递减是常态——有备份的多、有预案的少、演练过的更少。这张表的最后一列数字(真正演练过的比例),就是团队韧性的真实水位,也是向管理层申请投入时最有力的证据。
再强调一次演练的记录纪律:每次容灾演练的完整记录——时间线、决策点、耗时、发现的问题——要像事故报告一样归档。这些记录既是改进的依据,也是监管和客户问询时的证据链。演练做了没记录,等于没做,这是审计视角下最基本的要求,也是团队之间韧性能力拉开差距的隐性分水岭。
最后给一个韧性建设的年度节奏参考:一季度做故障域盘点和预案更新,二季度完成主要场景的演练(含反向切换),三季度针对演练暴露的短板做架构加固,四季度做一轮混沌实验扩展盲区覆盖。四季循环、逐年加深,韧性问题没有一劳永逸的解法,只有持续经营的复利。