5.2 混沌工程与韧性测试
5.2 混沌工程与韧性测试
本节摘要:混沌工程的核心思想有点反直觉——主动往正常运行的系统里注入故障,看它会不会挂。本节讲为什么要这么做(被动等故障太晚,主动找问题才能提前修)、混沌工程和传统测试的差别、怎么做一次故障注入实验,以及它的执行原则(从小范围开始、可控、可回滚)。核心认知:混沌工程不是搞破坏,是用科学方法验证系统的真实韧性。
学习目标
阅读完本节,你应当能够:
- 说清混沌工程解决的核心问题
- 解释混沌工程和传统测试的差别
- 描述一次故障注入实验的完整流程
- 理解混沌工程的执行原则(爆炸半径控制)
- 设计一个针对自己系统的混沌实验
一、问题与直觉
前面讲了容灾架构,但容灾建好不演练等于没有。传统的演练方式是定期搞一次“故障切换演习”——人工模拟主机房挂了,看备机房能不能接管。这种演练有几个问题:频率低(一年几次),覆盖的故障类型少(只演练预想的故障),人工操作多(容易出错),而且大家知道是演习,行为和真故障时不一样。
混沌工程是另一种思路:不搞集中的演习,而是常态化地、自动地往系统里注入小规模故障,持续验证系统的韧性。比如随机关掉几个实例、模拟网络延迟、把某个依赖搞挂,看系统是不是还能正常服务。这些小故障每天都在发生,系统设计得好应该能吸收它们,吸收不了就说明有隐患,趁早修。
这个思路的哲学是:故障必然发生,与其被动等大故障暴露问题,不如主动用小故障持续暴露问题。小故障在可控范围,大故障是灾难。用前者替代后者的发现作用,是混沌工程的价值。
二、核心原理
2.1 混沌工程 vs 传统测试
混沌工程和传统测试看起来都在“找 bug”,但思路和范围完全不同。
传统测试验证的是“预期内的行为对不对”——给预期输入,看输出对不对。它基于假设:如果所有预期场景都对了,系统就稳了。但真实故障往往不在预期内——你没假设过的故障组合、没预料到的依赖失效。
混沌工程验证的是“预期外的故障系统扛不扛得住”——主动制造你没假设过的故障(实例随机死、网络随机断、依赖随机慢),看系统是不是还能服务。它承认你没法穷举所有故障场景,所以用随机注入来逼近真实的混沌。
打个比方,传统测试像在驾校场地里按固定路线练车(预期场景),混沌工程像把车扔到真实马路上随机应对突发状况(意外故障)。两者都需要,但后者更能暴露真实问题。
2.2 一次故障注入实验的流程
混沌工程不是随便搞破坏,它有严格的科学方法。一次完整的故障注入实验,流程如下。
第一步:假设。先提出一个韧性假设,比如“任意一个实例挂掉,系统仍能正常服务”。假设要具体、可证伪。
第二步:设计实验。确定注入什么故障(杀一个实例)、在什么范围(生产环境的某个服务)、怎么度量(监控错误率、RT)、稳态行为是什么(平时错误率低于 0.1%)。
第三步:执行注入。在受控范围内注入故障。从小范围开始,先在非生产环境或单个实例上试。
第四步:观察度量。密切监控系统的稳态指标,看故障注入后指标有没有偏离正常范围。
第五步:得出结论。如果系统扛住了(指标正常),假设成立,韧性达标;如果系统出问题(指标恶化或服务中断),假设被推翻,发现了韧性弱点,要修复。
2.3 故障注入的类型
混沌工程能注入的故障类型很多,对应系统可能遇到的各种异常。
实例故障:随机关闭实例(模拟实例崩溃),验证弹性伸缩和负载均衡能否接管。网络故障:注入网络延迟、丢包、分区(模拟网络抖动和断连),验证超时重试和熔断。依赖故障:模拟下游依赖变慢或不可用(模拟依赖服务故障),验证熔断降级。资源故障:耗尽 CPU、内存、磁盘(模拟资源竞争),验证资源隔离和限流。
这些故障覆盖了系统可能遇到的主要异常类型。通过组合注入,能发现各种复杂场景下的韧性弱点。
三、工程实践要点
3.1 爆炸半径控制:从小开始
混沌工程最怕的是“实验把系统真搞挂了”。所以执行的核心原则是控制爆炸半径——故障的影响范围必须可控。
做法是从小到大逐步扩大:先在非生产环境做,验证实验设计没问题;再在生产环境的非核心服务上做;最后才在核心服务的小范围实例上做。每次注入前,要有明确的回滚方案(怎么立即恢复),注入过程中密切监控,一旦指标恶化超出预期立即回滚。
⚠️ 常见坑:一开始就在生产环境的核心服务上大规模注入故障,结果系统真挂了,造成生产事故。混沌工程必须循序渐进,从最小爆炸半径开始,确认安全后再逐步扩大。宁可慢,别搞砸。
3.2 常态化而非运动式
混沌工程的价值在于常态化——持续地、自动地注入小故障,而不是偶尔搞一次大演习。常态化才能覆盖更多故障组合,才能在故障累积成大问题前发现。很多团队用自动化平台,每天在非高峰时段自动跑一批小规模混沌实验,发现弱点就记录修复。
3.3 修复比发现更重要
混沌工程发现问题只是第一步,更重要的是修复发现的问题。每次实验暴露的韧性弱点,都要进入修复流程,修完再用实验验证确实修好了。如果只做实验不修复,混沌工程就变成了纯粹的破坏,没有产出。
💡 关键直觉:混沌工程的本质是“用可控的小故障,替代不可控的大故障来暴露问题”。它不是破坏系统,而是用科学方法提前发现系统的脆弱点。一个经过混沌工程持续验证的系统,对真实故障的免疫力远高于没验证过的系统——因为你已经主动把各种故障都试过一遍了。
本节要点回顾
- 核心思想:主动注入故障验证韧性,用可控小故障替代不可控大故障暴露问题。
- vs传统测试:传统测试验预期行为,混沌工程验预期外故障的承受力。
- 实验流程:假设→设计→注入→观察→结论,科学方法不是乱搞。
- 故障类型:实例、网络、依赖、资源四类,覆盖主要异常。
- 爆炸半径:从小到大逐步扩大,非生产先于生产,非核心先于核心。
- 常态化:每天自动跑小实验比偶尔大演习更有价值。
- 修复为先:发现问题要修复验证,只实验不修复是纯破坏。
最后一章讲可观测性——怎么看得清系统状态,才能知道故障发生、容灾切换、混沌实验的效果。
混沌实验的成熟度阶梯
混沌工程不是上来就拔网线,它有自己的成熟度阶梯,爬梯子的过程比单次实验更重要。第一级是故障注入演练:人工制造已知故障(杀进程、加延迟),验证预案是否有效,这是最基础的形式,价值在于让预案从文档变成肌肉记忆。第二级是自动化实验:把故障注入做成平台能力,定期在低峰期自动执行,系统自动比对实验前后的指标偏离。第三级才是真正的混沌:在生产环境持续注入随机故障,让系统在日常就暴露弱点,所谓"混沌即常态"。多数团队停在第一级就已经收获巨大——因为第一级就会暴露预案里的过时信息:联系人对不上、开关失效、依赖早已下线。
实验设计有一个黄金原则:先定义稳态假设再注入故障。"杀掉一个库存服务实例,下单成功率不应低于百分之九十九点九"——先有这句可度量的假设,实验结果才有解读意义;没有假设的注入只是捣乱。另外 blast radius 的控制是安全底线:实验范围(影响的流量比例、服务范围、时长)要在设计阶段框死并支持一键终止,生产环境的实验必须有"abort 机制比实验本身更可靠"的觉悟。混沌工程的初心是建立对系统弱点的认知,而不是表演破坏力,爬梯子的节奏永远跟着团队的消化能力走。
图:混沌实验闭环与成熟度阶梯
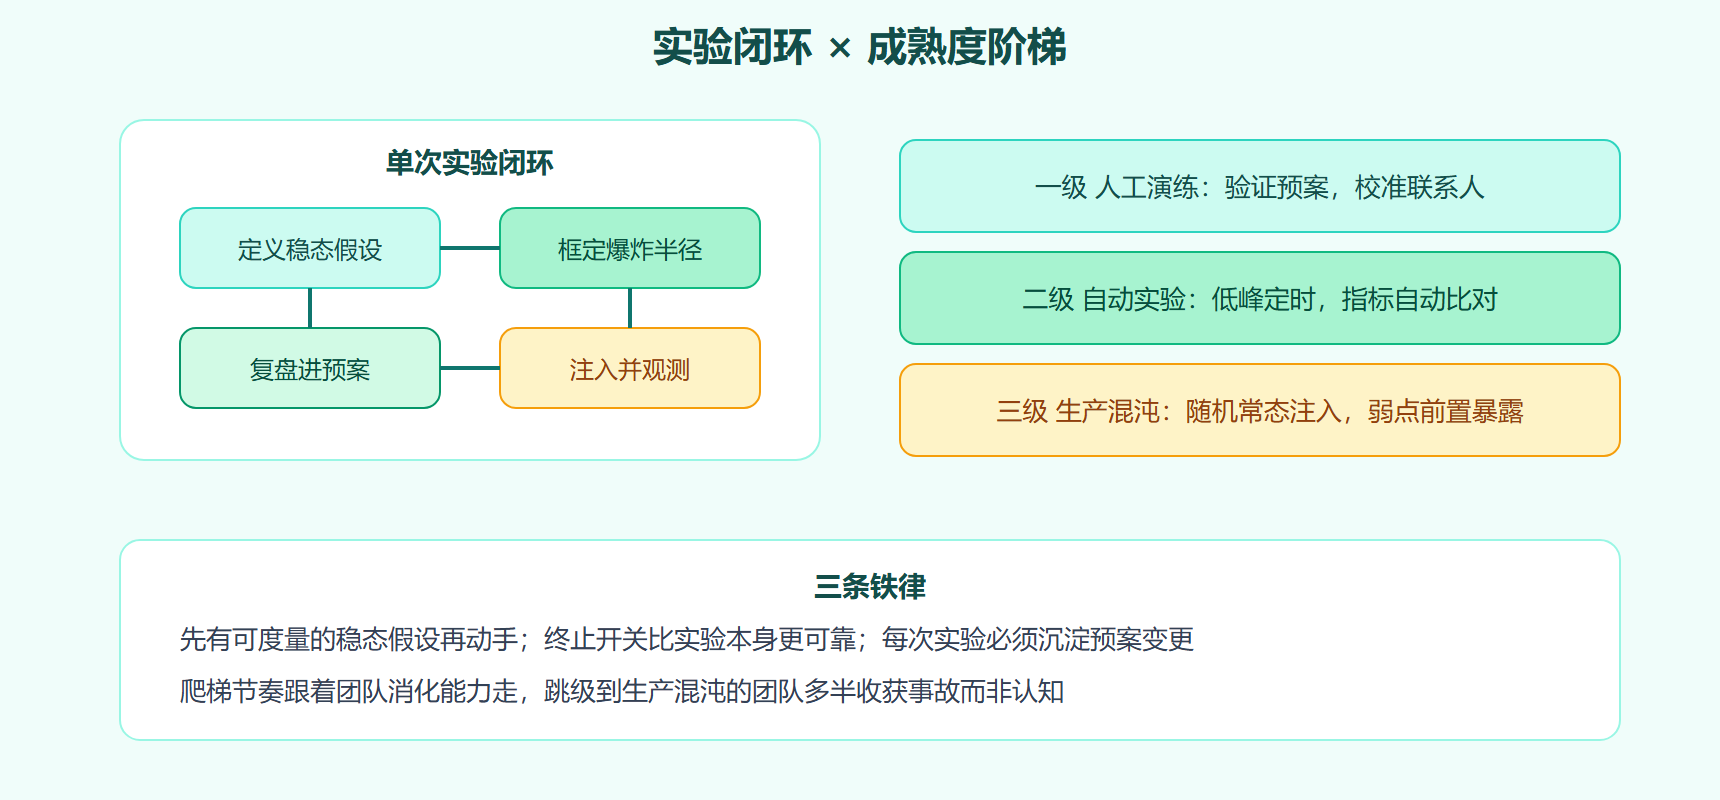
这张图把单次实验的方法论和长期成熟度分成两个轴:左边的闭环每做一次都要完整走完,右边的阶梯决定你多久做一次、在哪里做。两者乘起来才是混沌工程的真实能力——闭环残缺的团队爬再高的阶梯都只是在制造噪声。
再补一个落地建议:混沌实验的产出物要接入问题跟踪系统而不是留在文档里。每次实验暴露的弱点,直接建单、指派负责人、排期修复,下次实验把该场景作为回归项验证修复效果——形成"暴露、修复、回归"的闭环。实验报告躺在共享文件夹里无人认领,是混沌工程推行失败的常见剧本,组织上的闭环设计和实验本身一样重要。
顺带一个度量建议:混沌工程的成效要用两个指标跟踪——检测时间(故障注入到告警触发的间隔)和恢复时间(注入到指标回稳的间隔)。每季度画出两个指标的趋势线,检测时间的缩短说明观测体系在进步,恢复时间的缩短说明预案和自动化在起效。没有这两个数字,混沌工程就只是活动,不是工程。另外实验场景的优先级排序,按"发生概率乘以检测盲区"来定,而不是按故障严重程度——高频且无自动检测的场景排最前,纯验证性的排最后,稀缺的实验窗口要留给盲区的暴露。
再补最后一个小技巧:实验结果的传播。每次实验后,把"稳态假设、注入内容、观测结果、改进项"浓缩成一页纸在团队周会过一遍,让没参与实验的人也知道系统的弱点在哪。混沌工程的认知资产只有扩散到整个团队才真正保值——值班的人知道系统的已知弱点,处置故障时的第一直觉就会准得多。