第6章 · 运维与可观测性闭环
第 6 章 · 运维与可观测性闭环
章节摘要:高并发系统复杂到没人能凭脑子掌握它的全貌,必须靠可观测性——看得清状态,才能发现问题、定位故障、做容量规划。这一章讲可观测性的三大支柱(指标、日志、链路)怎么配合,以及容量规划与压测怎么形成闭环。核心认知:可观测性不是出事才看,而是持续洞察系统,把被动救火变成主动预防。
学习目标
阅读完本章,你应当能够:
- 说清指标、日志、链路三者各自的作用和配合方式
- 设计一个覆盖核心链路的可观测体系
- 理解容量规划的核心方法和压测的作用
- 建立从监控到告警到处置的闭环
- 用可观测数据驱动系统优化决策
核心概念速览
指标告诉你“出事了”,日志告诉你“发生了什么”,链路告诉你“卡在哪”——三者缺一不可。
子章节导航
6.1 指标日志链路三维可观测
讲三大支柱各自的特性和采集方式,重点是怎么配合——指标发现异常、日志看细节、链路追根因,形成从告警到定位的高效闭环。
6.2 容量规划与压测闭环
讲容量规划的核心方法(基于历史数据预测、基于压测定极限),以及全链路压测怎么做。容量规划是把可观测数据转化为扩缩容决策的桥梁。
子章节之间的逻辑关系
6.1 讲怎么看得清(可观测),6.2 讲看清楚后怎么做决策(容量规划)。前者是洞察,后者是行动,合起来是完整的运维闭环。
6.1 可观测(看清状态) ──► 6.2 容量规划(做决策)
前置知识与后续延伸
- 前置知识:前五章的全部内容,特别是第 1 章的指标体系。
- 后续延伸:附录的指标与组件对照表,方便运维时查阅。
延伸:告警治理——可观测性的下半场
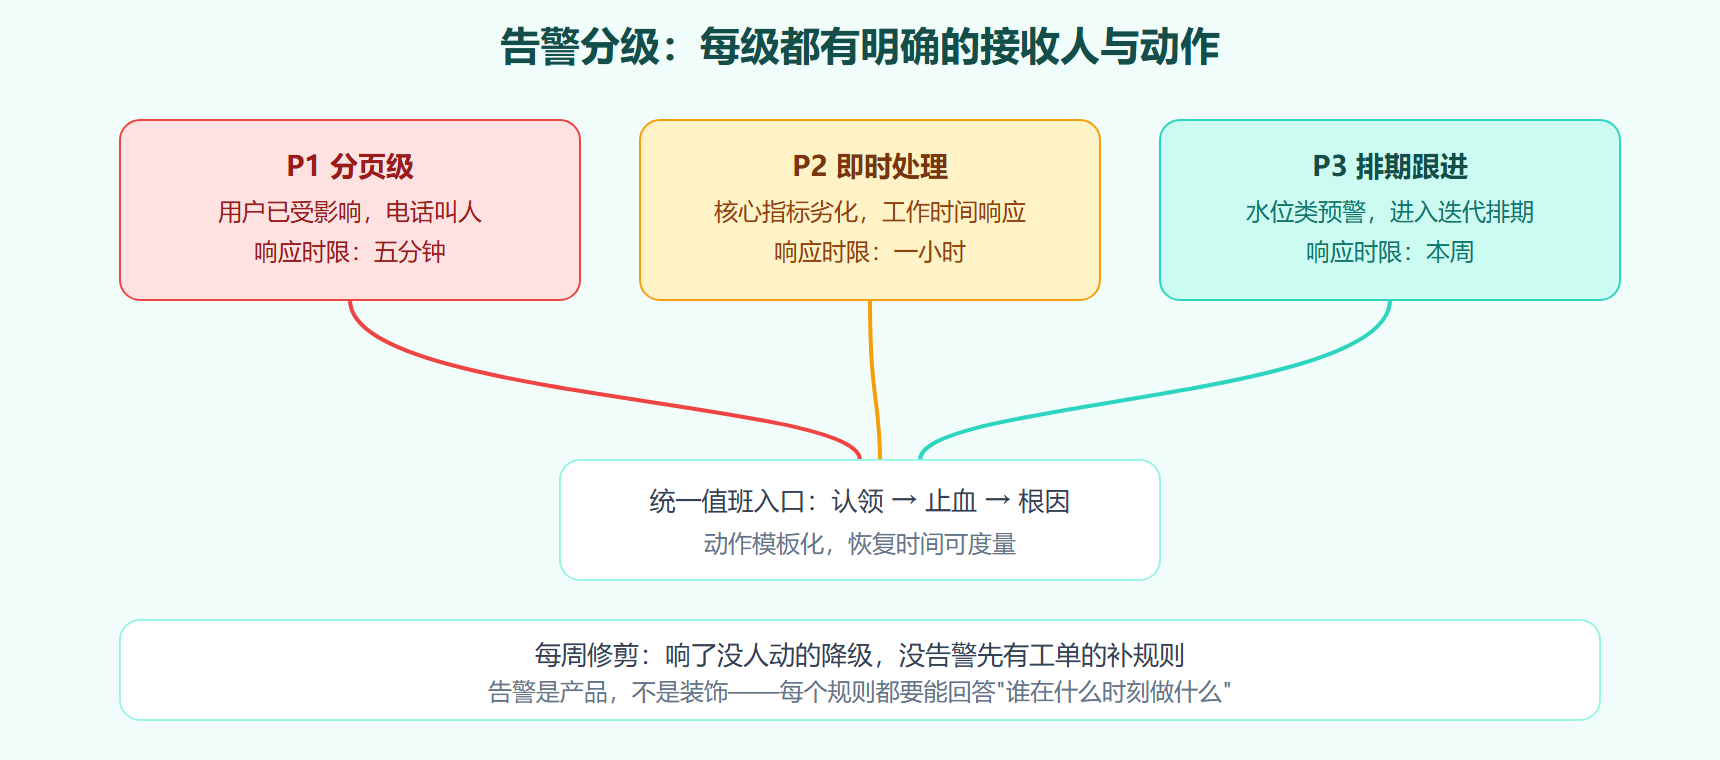
搭起指标、日志、链路三板容易,难的是让它们可持续地工作,这里面的主要矛盾是告警疲劳。系统规模一大,告警量先涨,团队先是麻木、继而关掉通知,最后真正的故障淹没在噪声里——可观测性建设反而降低了可靠性。治理的思路是把告警当作产品来运营:每条告警都要回答"收到它的人此刻该做什么",答不上来的告警降级为dashboard指标或直接删除。分页级告警(会打电话叫醒人的)必须是"用户已受影响或即将受影响",内部抖动类信号一律降级。定期做告警复盘:哪些告警响了没人动、哪些故障没告警先有工单,两头的数据反向修剪告警规则。
容量规划与压测是观测数据的出口:看板上发现水位规律性逼近阈值,就进入扩容评估;压测里发现某分片提前饱和,就驱动数据层再平衡。观测数据不驱动动作,就是昂贵的装饰品。建议每季度做一次"从指标到决策"的走查:抽十个看板,逐个问这组指标最近半年触发过什么决策,一个都没触发的看板候选下线。留着没人看的看板不只是浪费屏幕,更会稀释新人判断重点的能力。
图:告警分级的响应闭环
最后把全书串起来收个尾:第 1 章教你判断问题规模,第 2 到 5 章给出各层的方案与取舍,本章的观测与容量闭环则是所有决策的裁判——方案好不好、取舍对不对,最终都由数据说话。读完本章,建议给自己立一个规矩:任何架构变更上线两周后,回到看板看它对核心指标的真实影响,把结论写进变更记录。这个习惯坚持一年,你会拥有团队里最值钱的东西:一份数据背书的架构决策档案。
顺带一句工具观:可观测的工具链三年一换代,指标口径和容量基线却是十年资产。投入的重心放在数据资产的积累和口径的统一上,工具随缘——这是本章内容里最保值的一条建议。
本章学完可以给自己出最后一道综合题:用一周时间,把自己系统的核心链路画成一张包含指标、日志、链路三要素的作战图——每个环节标注关键指标、日志事件码、以及容量水位。这张图做好后贴在值班室,新值班员上手时间减半,这既是本章知识的综合应用,也是团队可观测性建设的成果验收。
给本章一个最小落地方案:如果暂时没有精力建全套观测体系,先做三件事——核心接口的黄金指标看板、统一格式的错误日志、每周一次的容量水位走查。这三样覆盖八成日常排障需求,投入不到全套的十分之一。先跑起来再逐步补齐,比等完美方案落地更现实,也更容易在团队里坚持下来。
全书最后再送一句话:高并发架构的所有章节,最终都汇流到本章的看板上——流量的判断、分层的取舍、数据层的预算、韧性的验证,全部以指标的形式在这里相遇。把看板经营好,等于给整个架构体系装了仪表盘;看板荒废,再好的架构也是在黑夜里开车。这既是收官章的定位,也是我们把它放在最后的原因。