第3章 · 防御机制与鲁棒性增强
第 3 章 · 防御机制与鲁棒性增强
章节摘要:第 2 章讲了攻击者怎么打,这一章讲怎么防。防御分两大类:主动防御通过改变模型本身让它在对抗样本上也不出错,核心是对抗训练(用攻击样本训练模型);被动防御不改模型,而是在输入进模型前后加处理(检测对抗样本、净化扰动)。对抗训练是当前最有效的防御,但它有鲁棒-精度权衡——越鲁棒的模型在自然样本上精度越低。被动防御(检测、净化)更轻量但易被自适应攻击绕过。本章讲这两类防御的原理、效果和取舍,重点是对抗训练怎么做、它的代价是什么、以及为什么没有银弹。
读前必看
阅读完本章,你应当能够:
- 说清对抗训练的工作原理和它为什么有效
- 解释鲁棒-精度权衡,理解为什么提升鲁棒要牺牲精度
- 区分检测型防御和净化型防御
- 理解被动防御为什么易被自适应攻击绕过
- 设计一个组合的防御方案
第五条是综合应用,要求你把前面四条的知识串起来——能根据威胁模型选主防御(对抗训练打底)、选辅助防御(检测净化补漏)、定评估方法(多种攻击测泛化)。如果读完这章你能为自己的某个模型画出一张"防御层次图"并说清每一层为什么这么选,说明这章真正落地了。
核心概念速览
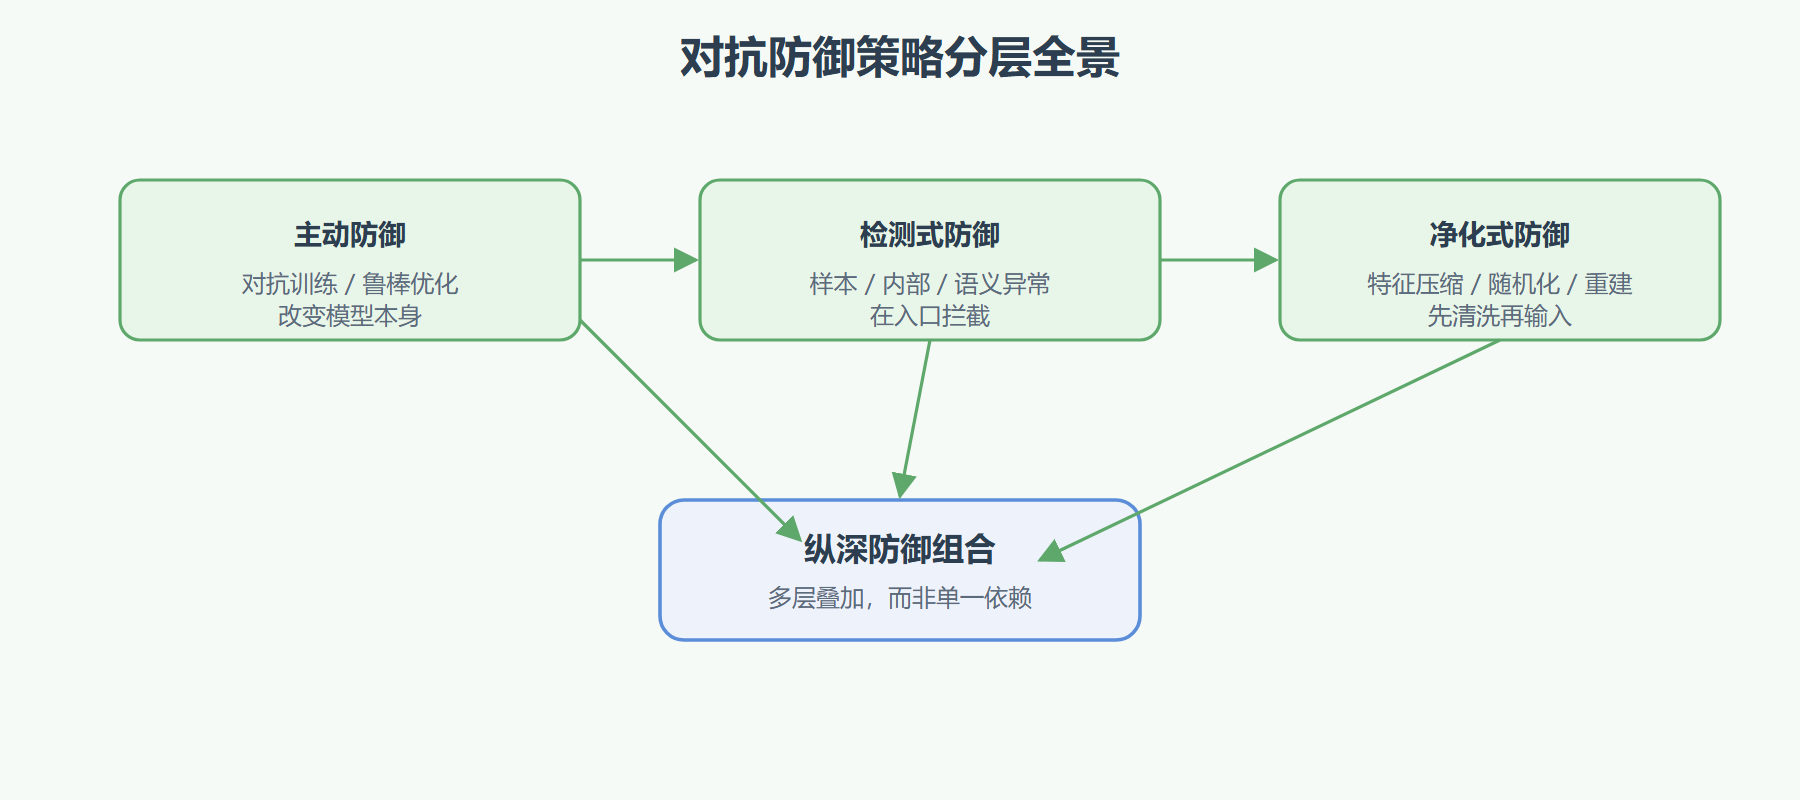
防御的核心权衡:主动防御(对抗训练)有效但伤精度,被动防御轻量但易被绕过。实践中通常组合使用。
图 3-1:对抗防御策略分层全景
子章节导航
3.1 对抗训练与鲁棒优化
讲最有效的主动防御——对抗训练。原理是用攻击算法生成对抗样本加入训练,让模型在训练时就见识攻击。重点讲它的实现、效果,以及不可避免的鲁棒-精度权衡。
3.2 检测与净化的被动防御
讲不改模型的被动防御。检测型防御识别输入是不是对抗样本(是就拒绝),净化型防御去除输入里的扰动(净化后再送模型)。它们轻量但易被自适应攻击绕过,所以更适合作为辅助手段而非主防御。
子章节之间的逻辑关系
先讲最强的主动防御(3.1,对抗训练),再讲轻量的被动防御(3.2,检测净化)。两者各有优劣,实践组合使用——对抗训练打底,被动防御补漏。注意顺序不能反:先做被动防御再想着对抗训练,往往会被绕过白忙一场;先用对抗训练把模型本体练鲁棒,再用被动防御处理对抗训练覆盖不到的边角,才是合理的工程顺序。
3.1 主动防御(改模型) ──► 3.2 被动防御(加处理) (最有效但伤精度) (轻量但易绕过)
贯穿本章的核心权衡
防御这章的核心是"没有银弹",几条权衡贯穿始终,想清楚它们才知道在自己的业务里该怎么取舍。
鲁棒性 vs 精度。 这是整个对抗机器学习最深刻的发现。对抗训练让模型放弃脆弱但有用的非鲁棒特征,换来对扰动的抵抗力,代价就是自然准确率下降。安全攸关场景(医疗、自动驾驶)愿意付这个代价,精度优先场景(推荐、搜索)则要谨慎评估。决策不是"要不要鲁棒",而是"愿意用多少精度换多少鲁棒"。
防御强度 vs 计算成本。 对抗训练要把训练时间拉长好几倍(每个 batch 都要跑内循环生成对抗样本),被动防御推理时也要额外开销。算力紧张的团队得想清楚把预算投在哪——是花在训练阶段把模型练硬,还是花在推理阶段加过滤。两者的长期收益不同,对抗训练是一次性投入持续受益,被动防御是持续开销。
经验鲁棒 vs 认证鲁棒。 大多数防御只能给"经验鲁棒"——测了几种攻击都没破。理论上更强的认证防御能给数学证明(某个扰动半径内输出不变),但保证范围保守、计算复杂、难用于大模型。目前工业实践主要靠经验鲁棒,认证防御还在研究阶段,但它是未来值得关注的突破方向。
前置知识与后续延伸
- 前置知识:第 2 章的攻击算法(FGSM、PGD),因为对抗训练要用它们生成训练样本。
- 后续延伸:本章是推理阶段的防御。第 4 章讲训练阶段的安全(投毒、窃取、后门)——那是另一类威胁。
读这一章要带的判断
防御这章比攻击章更需要"带业务判断来读"。攻击章主要是学工具,方法对就是对;防御章则充满取舍,同一个方案在医疗和娱乐场景下结论可能完全相反。所以读的时候建议不断问自己三个问题:我的业务能容忍多少精度下降?我的模型面对的是白盒还是黑盒威胁?我的算力预算够不够支撑对抗训练?
带着这三个问题读,你会发现每节里的工程取舍不再是抽象的讨论,而是可以直接套到自己项目上的决策依据。比如读到"对抗训练慢 K+1 倍"时,立刻能算出"我的训练集群能不能扛得住";读到"被动防御易被绕过"时,能判断"我把它当主防御还是辅助"。这种主动代入式的读法,比被动接受结论收获大得多。