1.1 给消息称重的起点:信息论为何诞生
1.1 给消息称重的起点:信息论为何诞生
本节摘要:回望度量信息的两次尝试——奈奎斯特与哈特利的对数度量、香农的概率平均度量——弄清一九四八年那篇论文到底新在哪,以及后继的纠错码里程碑如何把"存在性理论"补成"工程可达"。
从电报手感说起:没有秤的年代
最初给信息"定轻重"的不是数学家,而是电报员。莫尔斯码统计了印刷厂的字模数量,把最常见的 E 编成一个点、一点一划的 A 次之,冷僻的 Q 则要四拍起步。这是纯粹的经验压缩:他们知道消息有轻重之分,却没有单位,也没有办法回答"这份电报最少要多少拍"。此后二十余年,线路越铺越长,无线通信登场,带宽和功率开始被立法分配,"容量"成了必须谈的数字——可它仍然没有定义。
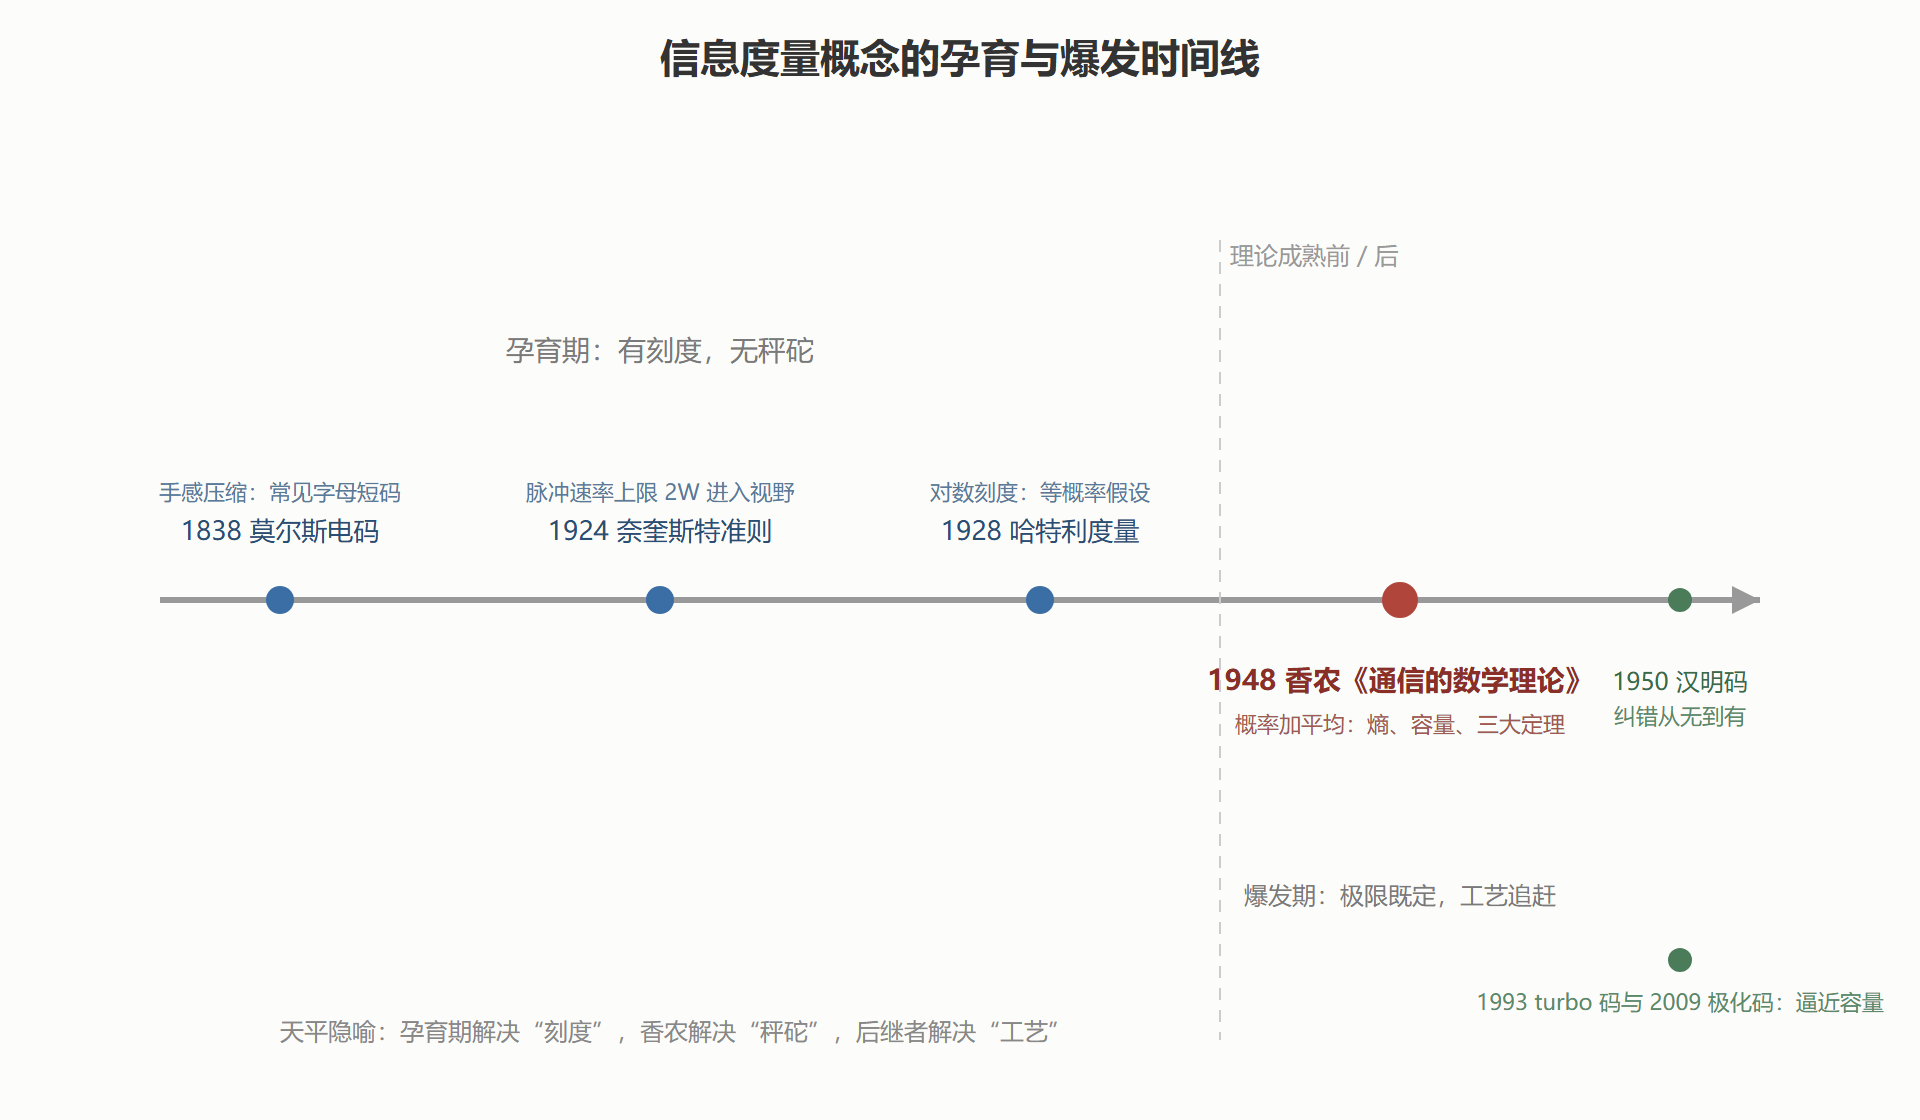
一九二四年,奈奎斯特研究电报传输时给出结论:带宽为 W 赫兹的线路,每秒最多传送约 2W 个独立的脉冲符号。一九二八年,哈特利往前走了一步:若每个符号取 S 种可分辨状态,则可传送的信息量正比于 2W·log S。这是历史上第一次给信息找到"对数刻度"——传一串硬币翻转与传一次大进制骰子的结果,信息量应该可以相互换算。哈特利度量已经具备了比特的雏形,但它有一个致命盲区:所有符号被默认等概率出现。而真实世界里 E 和 Q 的出现概率相差一个数量级,电报员的手感早就告诉世界:轻重不均,才是消息的常态。
香农的两个动作:引入概率,再取平均
一九四八年,贝尔实验室的克劳德·香农发表《通信的数学理论》,做了两个看似温和、实则开创学科的动作。
第一个动作是把概率装进度量。事件 x 的信息量不再由"有多少种可能"决定,而由它发生的概率决定:小概率事件一旦发生,带来的"惊讶"更大,信息量更高;必然事件的信息量为零。概率倾斜得越厉害,同样一条消息的"有效重量"就越轻——这正是莫尔斯码直觉的数学化。
第二个动作是对整个信源取平均。单个事件的信息量随消息涨落,工程上需要的是信源的平均不确定度,香农把它定义为熵:对每个可能消息的信息量按概率加权求和。这两个动作合在一起,"一台消息的秤"才真正铸成——它称的不是消息的长度,也不是消息的含义,而是信源概率分布的不确定程度。
# 用数字对比哈特利度量与香农熵:均匀分布两者一致,概率倾斜则分道扬镳 from math import log2 def hartley(n): # 哈特利:只看符号种类数,不看概率 return log2(n) def shannon(probs): # 香农:按概率加权的信息量平均 return -sum(p * log2(p) for p in probs if p > 0) # 场景一:四符号等概率(典型的四进制传输符号) uniform = [0.25, 0.25, 0.25, 0.25] print("均匀分布: 哈特利 =", round(hartley(4), 3), "香农 =", round(shannon(uniform), 3)) # 输出: 均匀分布: 哈特利 = 2.0 香农 = 2.0 ← 两者读数一致 # 场景二:四符号概率倾斜(模拟真实语言的字母不均衡) tilted = [0.7, 0.15, 0.1, 0.05] print("倾斜分布: 哈特利 =", round(hartley(4), 3), "香农 =", round(shannon(tilted), 3)) # 输出: 倾斜分布: 哈特利 = 2.0 香农 = 1.084 ← 概率倾斜让真实重量骤减
这段代码的第二个读数值得停下来看:同一个四符号信源,只要概率倾斜,平均重量就从每个符号二比特掉到约一点零八比特。压缩的全部空间,就藏在这两个读数的差值里——哈特利看到的是"最坏情形的重量",香农看到的是"实际的重量"。工程系统为最坏情形设计就是浪费,为实际重量设计才是压缩的起点。
立秤之路:从手感度量到公理化理论
下表把这段孕育期与爆发期的关键节点排成一条线,右侧标注该节点在天平隐喻中补上的部件。
后继里程碑:把存在性理论补成工程可达
香农的三大定理都是"存在性"表述:存在编码使码长任意接近熵;存在编码使差错概率任意小——但怎么构造这样的码,论文只给了随机编码的证明技巧,没给可实现的工艺。此后半个多世纪,编码理论的历史就是一部"逼近容量"的工程史,下表列出主干节点。
| 年代 | 人物/成果 | 补上的空白 | 天平角色 |
|---|---|---|---|
| 1950 | 汉明码 | 第一个可纠错的实用码 | 给包裹加第一层防漏包装 |
| 1955 起 | 卷积码与维特比译码(1967) | 流式编码与最优序列译码 | 连续称量的流水工艺 |
| 1960 | 里德-所罗门码 | 突发差错场景(光盘、深空) | 抗摔打的加固包装 |
| 1993 | turbo 码 | 距香农极限只差零点几分贝 | 工艺首次贴着承重线作业 |
| 1996 | LDPC 码复兴 | 并行译码、适合大规模集成 | 高吞吐的现代车间 |
| 2009 | 极化码 | 首个被证明达到容量的显式构造 | 有图纸的极限秤 |
这张表里藏着一条暗线:理论与工艺的时滞。汉明码距容量极限有数分贝的差距,工程师用了四十多年才把这段距离压缩到零点几分贝以内;而极化码给出的"达到容量的显式构造",距离香农的证明已经过去六十年。理解这个时滞,就理解了信息论作为"先定刻度、后做工艺"学科的独特节奏——它先告诉你终点在哪,然后全世界慢慢走过去。
信息论不是什么:三个常见误解
**误解一:信息论研究的是信号波形。**信号处理关注波形、频谱、滤波;信息论关注符号出现的概率。前者是"货物怎么运",后者是"货物有多重"。两者的交点在调制理论,但问题意识完全不同。
**误解二:信息论能度量消息的价值。**香农信息只与概率有关,与语义无关。"明天太阳从东边升起"概率接近一,信息量接近零,但这句话的价值不因概率高而归零。价值与效用属于决策论与语义通信的范畴(本册第 9 章会回到这个边界)。
**误解三:香农给了压缩算法。**香农给了压缩的极限,没给算法。从霍夫曼码到算术编码再到现代的视频编码标准,都是后人在极限之内做的工艺优化——这正是第 3 章的主题。
三问三答:给"信息论是什么"收口
**问题一:信息论与通信原理课是什么关系?**通信原理讲"怎么传"——调制、解调、同步这些波形层的手术;信息论讲"最好能传成什么样"——极限与边界。前者是工艺手册,后者是度量衡局。两门课的交点在信道容量与调制设计的接口处:容量给调制阶数的选择封顶。
问题二:为什么一九四八年之前没人做出来?工具与问题都在酝酿:概率论在二十世纪三十年代公理化完成,电报电话的工程积累提出了真问题,战时密码分析的训练让香农熟悉了统计方法。理论的诞生常被浪漫化为灵光一现,更接近事实的描述是"数学工具成熟与工程需求到位的交汇点"——香农是站在交汇点上的那个人。
问题三:这门前置知识要多少?本册的最低配置是会算期望与条件概率;每一步推导不超出微积分与级数求和。真正的门槛不在数学,在思维方式的切换——从"信号与波形"切换到"概率与符号",从"逐比特较劲"切换到"统计规律兜底"。完成这个切换的标志是:看到任何系统,先问"它的信源熵是多少、信道容量是多少"。
本节要点回顾
- 称量的对象是不确定性:信息量由概率决定,必然事件零信息,小概率事件高信息,与消息含义无关;
- 哈特利与香农的分界在对数刻度相同、概率假设不同,均匀分布下两者读数一致,概率倾斜时哈特利高估重量;
- 香农的两个动作——单事件信息量引入概率、对信源取平均——共同铸成熵这枚砝码;
- 三大定理都是存在性结论,工程逼近依靠汉明、维特比、turbo、LDPC、极化码等后继工艺;
- 理论与工艺存在数十年级时滞,这是信息论"先定刻度"工作方式的自然结果。
下一节我们把这台概念上的秤拆开看机械结构:信源、编码器、信道、噪声、译码器各是什么零件,速率与差错概率这两个仪表怎么读。