1.2 通信系统的天平模型:信源、信道与噪声
1.2 通信系统的天平模型:信源、信道与噪声
本节摘要:拆解香农通信系统模型的六个部件——信源、信源编码、信道编码、信道、译码、信宿,给出速率与差错概率的严格定义,并用 Python 仿真一个二进制对称信道,让"噪声让天平漂移"变成可以亲手复算的现象。
一间机房里的三个仪表
某个凌晨的通信机房里,值班工程师盯着三块仪表:一块显示当前传输速率,一块显示误码率,一块显示接收信噪比。链路在雨天恶化,误码率爬升,系统自动降速保可靠。这个再普通不过的自动行为,背后是信息论最核心的权衡——速率与可靠性的交换。要精确描述这场交换,需要一个把所有通信系统(电报、光纤、无线、存储读写都算)都装进去的抽象模型。
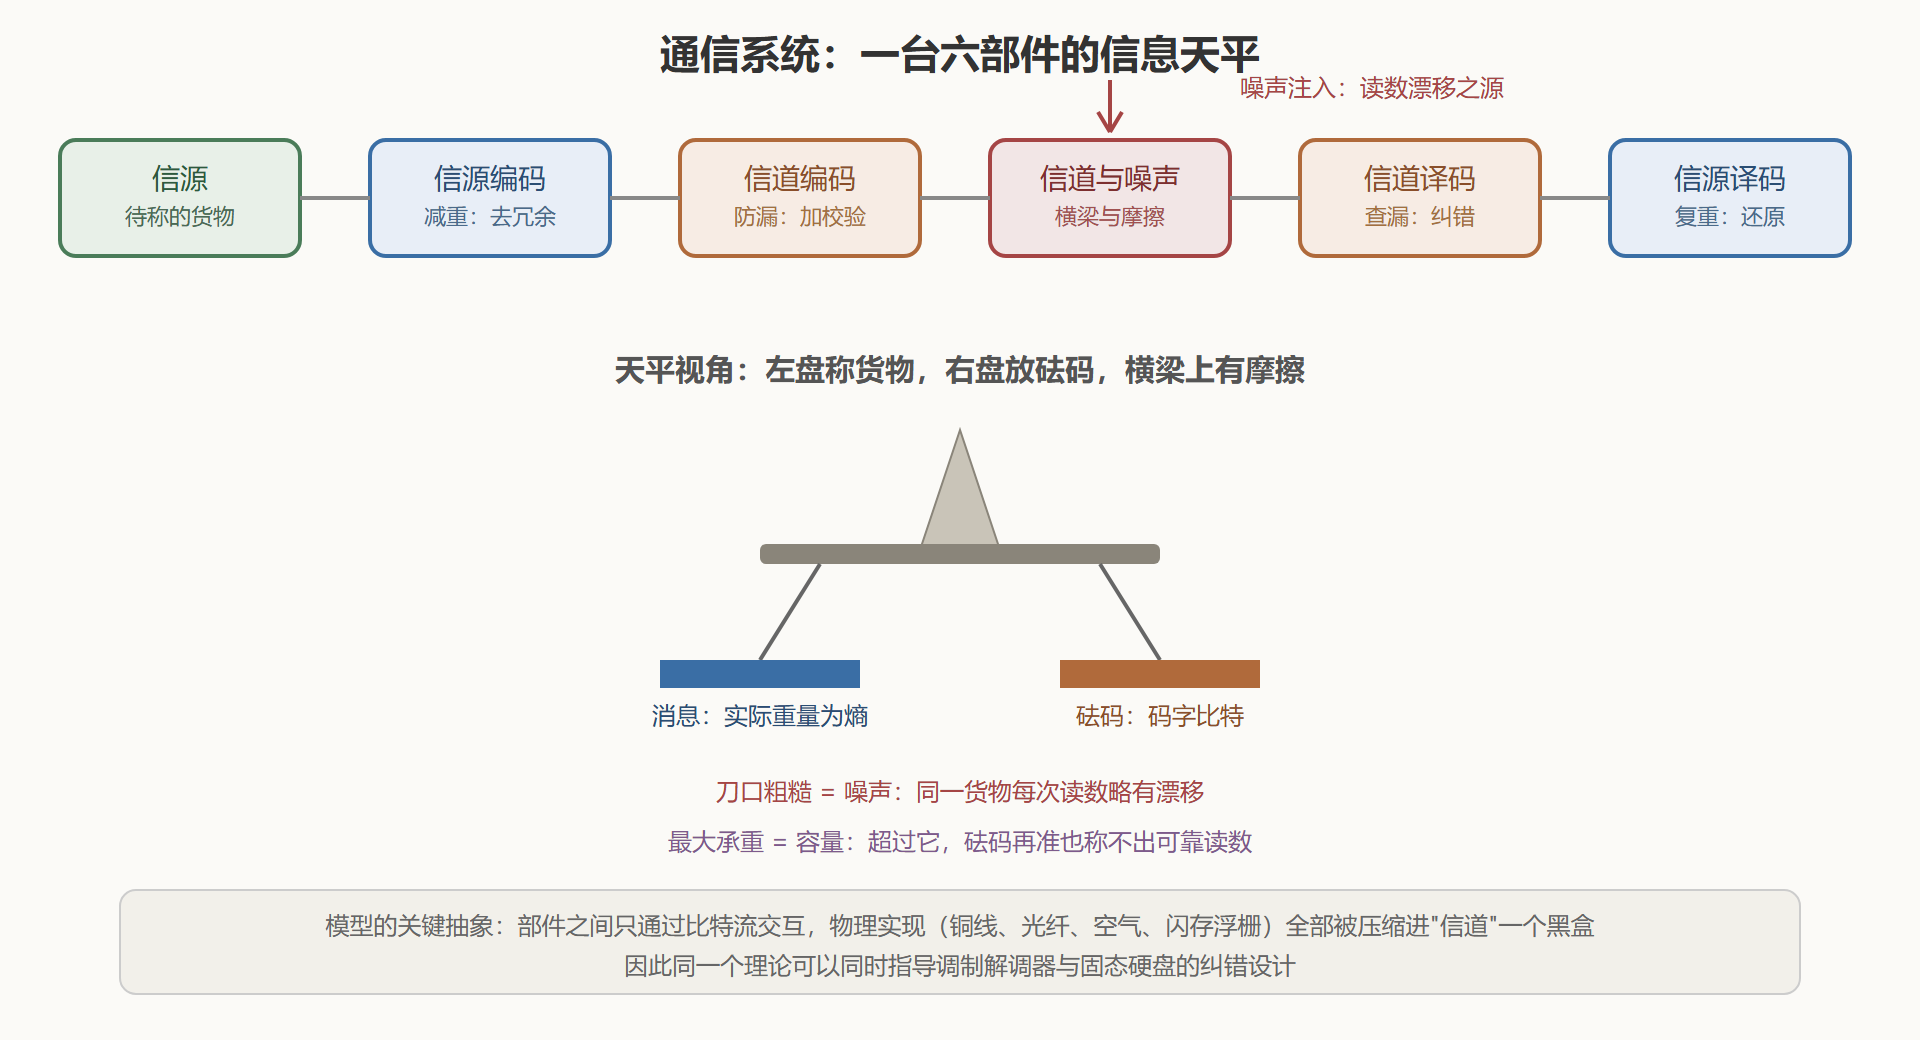
香农在一九四八年论文的开篇就画出了这个模型。它的强大之处在于"部件化":无论物理形态如何,任何通信系统都被拆成六个可分别研究、分别优化的部件。本节的任务是把这个模型拆开上油,并把它翻译成天平隐喻——信源是待称的货物,信源编码是去掉货物中的空隙(减重),信道编码是给包裹加防漏工艺(抗噪),信道是天平的横梁与刀口,噪声是让读数漂移的摩擦。
通信系统的六个部件与天平对应
信源的数学化:从消息流到随机变量
模型的第一步是把信源变成数学对象。一段文字、一串传感器读数、一段视频,在模型里都是一个按某种概率规律吐出符号的随机过程。最常用的简化是离散无记忆信源:符号集大小有限,每个符号独立同分布地出现。"无记忆"假设丢掉了语言里明显存在的前后依赖(字母 q 后面几乎总是跟着 u),换来的是可以先行建立理论——有记忆的情形可以推广到马尔可夫信源与平稳过程,结论的形式不变,只是熵换成熵率。
选择这个抽象的代价与收益值得掂量。代价是第一层压缩会低估可压缩空间(真实文本的熵率低于字符级无记忆熵);收益是整个理论体系的证明不必依赖信源的具体结构,且工程上可以先用自适应统计把有记忆信源"变成"近似无记忆的(这正是压缩软件里建模器的工作,第 3 章展开)。
编码器与码字:把重量翻译成砝码组合
编码器是一个映射:把信源符号(或符号块)翻译成信道能接受的字母表上的串,称为码字。码字的长度就是砝码的个数。信源编码缩短码字(减重),信道编码故意加长码字(加防漏冗余)——两者方向相反,却服务同一目标:在信道承重范围内可靠传完这批货。
设信源编码器把长为 k 的信源块映射为平均长 L 的码字,则每信源符号摊到的码长是 L/k;信道编码再把每 b 个比特扩展成 n 比特码字,信道每秒传 s 个信道符号,则系统速率为 R = (L/k)·(b/n)·s 比特每秒。这个连乘式把两级编码的"重量换算"写得清清楚楚:分子是被称货物的净重,分母里的 n/b 是防漏工艺的开销。
差错概率的定义在译码器一侧:对随机消息与随机噪声取平均,译码输出与发送消息不一致的概率,记作差错概率。信息论关心的是"码长趋于无穷时差错概率能不能压到任意小"——注意这完全不同于工程规格书里"误码率低于十的负六次方"这种单点指标,它是渐近命题。
信道与噪声:让读数漂移的摩擦
信道把输入符号映射成输出符号,映射不确定——同一输入,输出按条件概率分布摆动,这就是噪声。最经典的离散模型是二进制对称信道(BSC):输入翻转成相反比特的概率为 p,保持正确的概率为一减 p。它粗䊁却抓本质:噪声就是"以概率 p 颠倒黑白"。连续信道的主角是加性高斯白噪声信道(AWGN),输出等于输入加一个高斯随机变量,它是无线与有线通信的标准第一近似。
用 Python 可以直接把 BSC 的"读数漂移"仿真出来,顺便验证一个反直觉的事实:肉眼不可见的错误率,在长消息尺度上几乎是必然的灾难。
# 二进制对称信道仿真:小差错率在长消息上如何累积 import random def bsc_transmit(bits, p): out = [] for b in bits: flip = random.random() < p # 以概率 p 翻转 out.append(b ^ 1 if flip else b) return out random.seed(7) msg = [random.randint(0, 1) for _ in range(100000)] # 十万比特消息 for p in [0.5, 0.1, 0.01, 0.001]: recv = bsc_transmit(msg, p) err = sum(1 for a, b in zip(msg, recv) if a != b) print(f"翻转概率 p={p:<6} 实测差错率 {err/len(msg):.5f}") # 典型输出: # 翻转概率 p=0.5 实测差错率 0.49923 ← 信道完全失效,输出与输入无关 # 翻转概率 p=0.1 实测差错率 0.09994 # 翻转概率 p=0.01 实测差错率 0.01004 # 翻转概率 p=0.001 实测差错率 0.00100 # 关键观察:不加纠错时,十万比特里有约一百个错 —— 一张图片就会出现成片噪点
这段仿真的价值不在验证 p 的大小(那本来就是定义),而在两个极端读数的对照:p 等于二分之一时输出与输入统计独立,信道彻底报废——再多功率也救不回;p 很小时差错稀疏,但长消息几乎必然带错。不纠错的长传输是不存在的,这正是信道编码必须存在的根本理由,也是第 4 章整章的动机。
部件、天平与数学对象的对照表
| 部件 | 天平角色 | 数学对象 | 关注的指标 |
|---|---|---|---|
| 信源 | 待称货物 | 随机变量/随机过程 | 熵(每符号平均重量) |
| 信源编码 | 去空隙减重 | 概率到码字的映射 | 平均码长能否逼近熵 |
| 信道编码 | 防漏包装 | 码本(码字集合) | 差错概率、码率 |
| 信道 | 横梁与刀口 | 条件概率分布 | 容量(最大承重) |
| 噪声 | 刀口摩擦 | 随机扰动 | 信噪比、翻转概率 |
| 译码器 | 查漏复秤 | 反映射(推断规则) | 译码复杂度、时延 |
这张表建议放在手边:后面每一章其实都是在其中一格内做深——第 2 章深化"信源"格,第 3 章深化"信源编码"格,第 4 章深化"信道"与"信道编码"两格,第 5 章研究两格之间能否解耦。
模型的伸缩性:从闪存到神经网络
六部件模型的普适性值得最后清点一遍。存储系统:写入是"发送"、长期存放是"信道"(电荷泄漏与磁畴老化就是噪声)、读取是"接收"——固态硬盘的纠错栈完全是这个模型的硬件化(第 8.2 节展开)。生物系统:DNA 转录与翻译可读作四进制信道上的编码传输,密码子的简并性(多种密码子编码同一氨基酸)天然是一种纠错冗余。神经网络:逐层变换可视为"信源-信道-信宿"的压缩中继链,第 8.3 节的信息瓶颈正是用这套语言写的。金融与传感:任何"观测-传输-决策"的流水线都能套进模型,噪声换成测量误差与市场扰动。
同一个框图装下这么多系统的原因,在第 1.1 节已经埋好:香农的三个剥离(含义、波形、工艺)换来了模型与物理实现的完全解耦。模型的价值不在于精确描述任何系统,而在于把所有系统里"与信息流动有关的那部分"抽出来统一称量——这正是"模型"一词的本义。
本节要点回顾
- 六部件模型把一切通信系统(含存储)统一为信源、两级编码、信道、两级译码、信宿的比特流水线,物理形态全部压缩进信道黑盒;
- 离散无记忆假设是理论先行的简化,真实信源可经统计建模近似转化,代价是低估可压缩空间;
- 速率是重量换算的连乘:信源码长比乘以信道码率比再乘符号速率,两级编码方向相反却目标一致;
- 差错概率是渐近定义,信息论问的是码长增大时它能否趋于零,而非某个具体误码率指标;
- BSC 仿真揭示两个极端:翻转概率二分之一意味着信道报废,小差错率在长消息上累积成必然错误,纠错因此不是可选项。
模型立好了,天平怎么从一九四八年的论文一步步长成今天覆盖网络与语义的体系?下一节按三个阶段回放这场演进。