1.3 从莫尔斯码到语义通信:称量思维的演进
1.3 从莫尔斯码到语义通信:称量思维的演进
本节摘要:把七十多年的信息论压成三个阶段——经典奠基期立秤、现代扩张期逼近刻度、泛在融合期外溢——并用一段可复算的代码量化莫尔斯码离熵界有多近,最后看清"语义重回秤盘"这一最新转向的来龙去脉。
一份电码单里的演算:手感离极限有多远
莫尔斯码给字母 E 的编码是一个点,冷僻的 Q 则要四个符号起步。十九世纪的编码员没有熵的概念,却已经按"出现越频繁、编码越短"的原则排兵布阵。这套手感方案离理论极限有多近?这个有趣的问题可以用香农的工具反过来考古代方案。
以标准英文字母频率为信源,逐字母设计:字符熵约每字母四点一八比特;一九五二年的霍夫曼算法按同样频率构造最优前缀码,平均码长约四点二一比特,只比熵高出百分之零点八。而莫尔斯码把每个字母折算成发报时间单位(点记一个单位、划记三个单位),平均每字母约四点五五个单位——若每个时间单位至多承载一个比特,熵下界就是四点一八个单位,莫尔斯码只多花约百分之九。考虑到它还没利用字母间的上下文依赖(英语的真实熵率明显低于字符级无记忆熵),这份十九世纪的成绩单可以说相当体面:手感称重已经贴着静态编码的极限,差的只是"知道自己贴着极限"这件事本身。这正是理论的全部意义——极限一旦显式化,改进就有了方向与尽头。
# 考古式演算:莫尔斯码、霍夫曼码与熵界的三方对照 import heapq from math import log2 freq = {'e':12.7,'t':9.1,'a':8.2,'o':7.5,'i':7.0,'n':6.7,'s':6.3,'h':6.1, 'r':6.0,'d':4.3,'l':4.0,'c':2.8,'u':2.8,'m':2.4,'w':2.4,'f':2.2, 'g':2.0,'y':2.0,'p':1.9,'b':1.5,'v':1.0,'k':0.8,'j':0.15,'x':0.15, 'q':0.10,'z':0.07} # 标准英文字母频率,单位 % # 1) 字符级无记忆熵:称出这批货物的真实平均重量 H = -sum(v/100 * log2(v/100) for v in freq.values()) # 2) 霍夫曼最优前缀码:静态逐字母设计能达到的最好水平 nodes = [(v/100, [k]) for k, v in freq.items()] codes = {} while len(nodes) > 1: nodes.sort(key=lambda x: x[0]) (p1, k1), (p2, k2) = nodes.pop(0), nodes.pop(0) for k in k1: codes[k] = '0' + codes.get(k, '') for k in k2: codes[k] = '1' + codes.get(k, '') nodes.append((p1 + p2, k1 + k2)) huff_len = sum(freq[k]/100 * len(codes[k]) for k in freq) # 3) 莫尔斯码的发报时间:点=1 单位,划=3 单位 morse = {'e':'.','t':'-','a':'.-','o':'---','i':'..','n':'-.','s':'...', 'h':'....','r':'.-.','d':'-..','l':'.-..','c':'-.-.','u':'..-', 'm':'--','w':'.--','f':'..-.','g':'--.','y':'-.--','p':'.--.', 'b':'-...','v':'...-','k':'-.-','j':'.---','x':'-..-','q':'--.-','z':'--..'} morse_time = sum(freq[k]/100 * sum(1 if s=='.' else 3 for s in morse[k]) for k in freq) print(f"字符熵 {H:6.3f} 比特/字母 ← 理论下界") print(f"霍夫曼平均码长 {huff_len:6.3f} 比特/字母 ← 超出熵 {(huff_len/H-1)*100:.1f}%") print(f"莫尔斯发报时间 {morse_time:6.3f} 单位/字母 ← 按 1 比特/单位折算超出 {(morse_time/H-1)*100:.1f}%") # 输出: # 字符熵 4.182 比特/字母 ← 理论下界 # 霍夫曼平均码长 4.213 比特/字母 ← 超出熵 0.7% # 莫尔斯发报时间 4.548 单位/字母 ← 按 1 比特/单位折算超出 8.8%
三个阶段:称量对象的两次扩容
信息论的历史可以按"秤上称的是什么"切成三段。第一段称符号的概率(点对点可靠传输),第二段称工艺与刻度的距离(逼近极限的编码战争),第三段把秤搬进网络、量子和智能系统,甚至开始琢磨称"含义"。下图画出这条扩容路线。
范式演进的三层透视
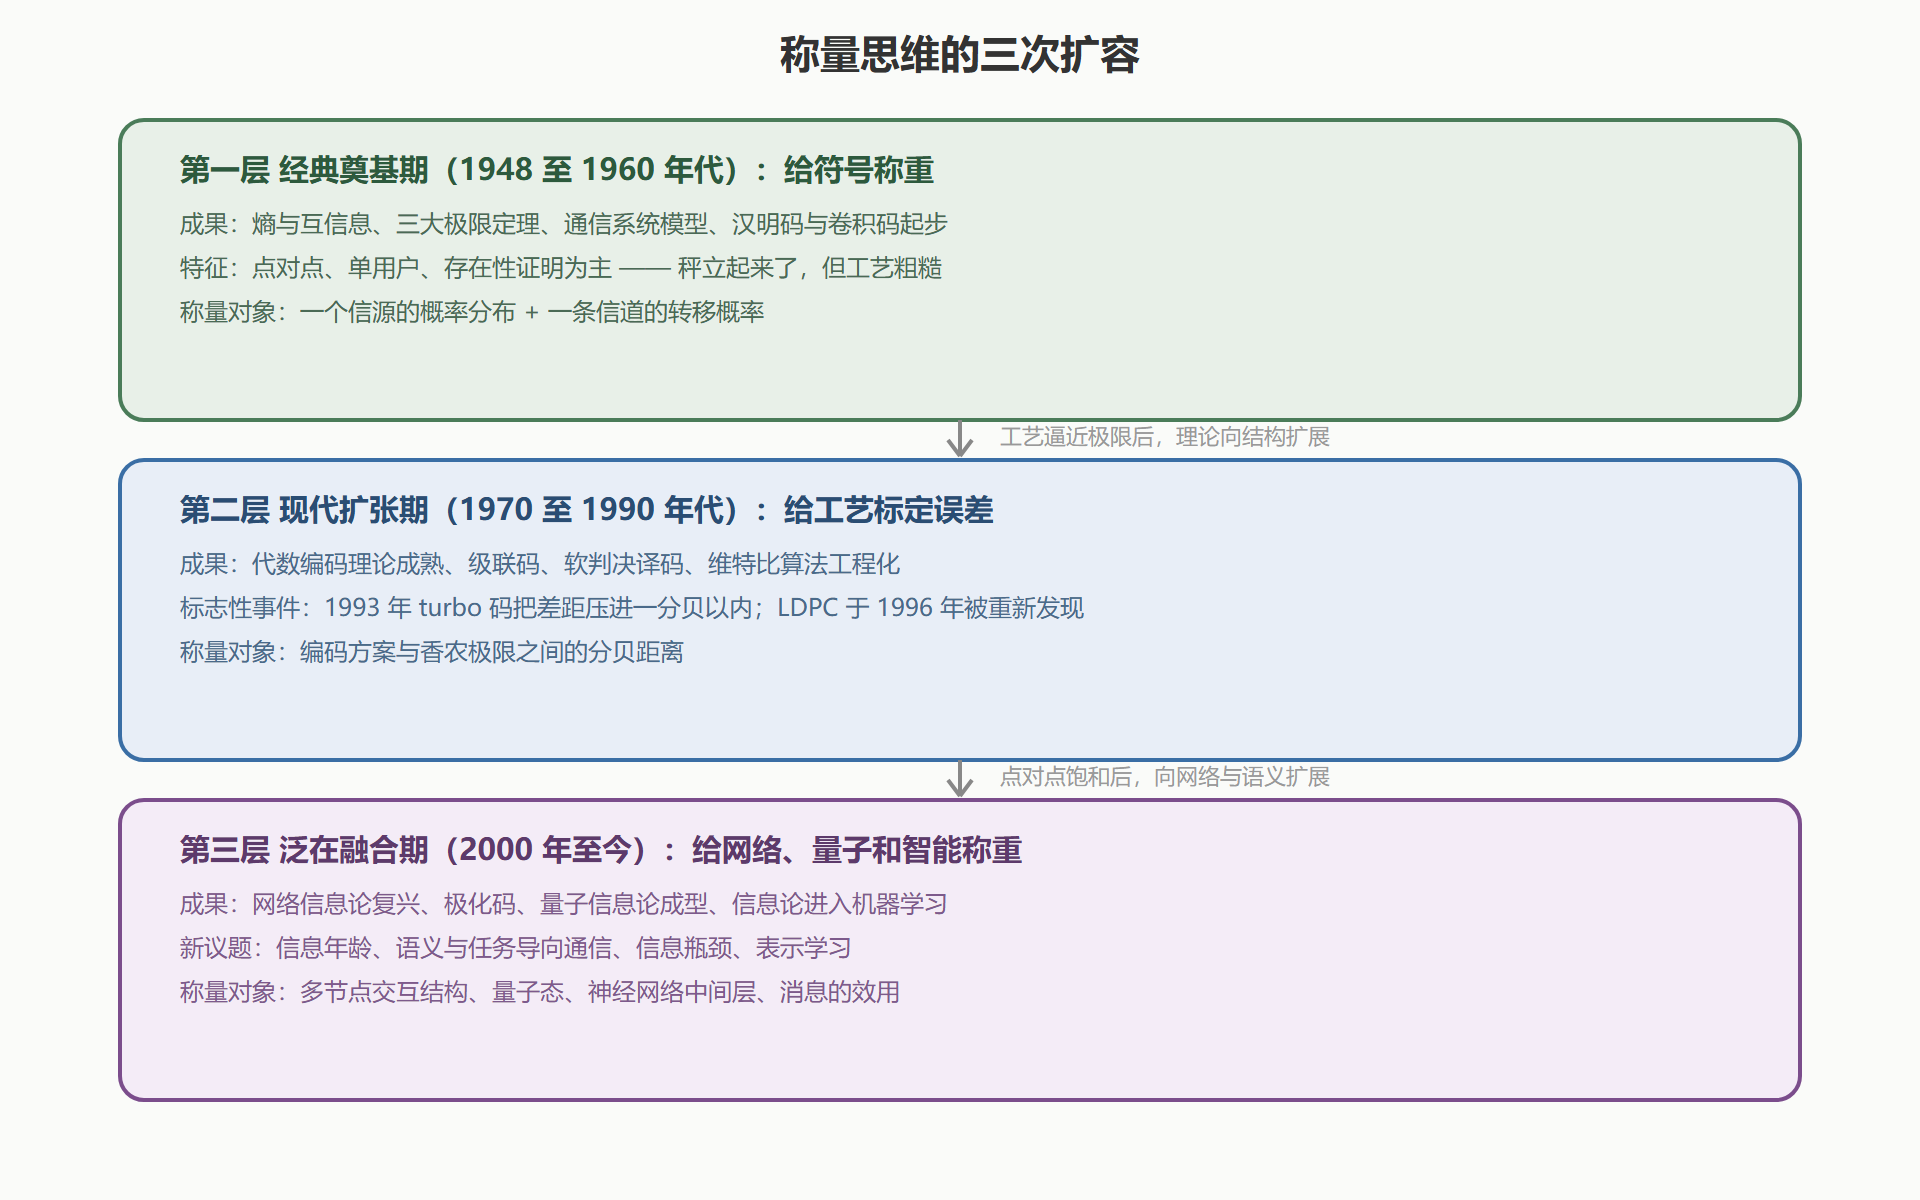
**第一层的关键词是"抽象"。**香农同时完成了三个剥离:信息剥离含义(只留概率)、信道剥离波形(只留转移概率)、设计剥离工艺(只证存在性)。这三个剥离换来了理论的普适——同一套定理对电报、光纤和闪存同样生效。但代价也明摆着:第一层理论对"怎么构造好码"几乎沉默,工程界在之后的二十年里主要靠代数手段自行摸索。
**第二层的关键词是"逼近"。**理论刻度已经立好,工艺开始赛跑。这个时期信息论的直接产出是编码理论的成熟:里德-所罗门码解决了突发差错,卷积码配维特比译码成为深空标准,级联码把两类工艺串联。终局是 turbo 码与 LDPC 的渐近最优——衡量一个码的标准变成了"距香农极限几分贝",理论刻度内化为工程 KPI。移动通信与互联网在这二十年里爆发,并非巧合:编码增益直接兑换成覆盖范围与速率。
**第三层的关键词是"扩容"。**点对点的称量趋于饱和后,秤被搬进了三个新场地。网络场地里,多用户、中继、干扰使"容量"从单一数值变成区域(第 6 章);量子场地里,叠加与纠缠使"比特"让位给量子比特,不可克隆定理重写了保密的刻度(第 7 章);智能场地里,互信息成为解释神经网络表征的工具,信息瓶颈把"学习"重新表述为压缩(第 8 章)。
语义的重返:香农亲手关上的门被重新推开
一九四九年,香农与韦弗为理论划界时明确说:工程问题不处理语义。这句话在当时是解放——含义无法公理化,砍掉它理论才能成立。但七十多年后,门被重新推开,推手是两个现实变化。
其一是资源约束的极端化。远程手术的控制系统不需要毫米级点云的每个比特,只需要"目标移了、方向偏了"这类任务相关信息的及时到达。按比特称重的体系会为无用精度支付带宽,而任务导向的通信想问的是:这条消息对决策有多大贡献?其二是智能接收端的出现。当接收方是模型而非人,传输目标从"忠实重建"变成"让模型推断准确",语义度量(任务损失、信息年龄、目标价值)开始与比特度量并立。
要注意分寸:语义通信并不是推翻香农,而是在他划定的工程问题之外新开一秤。比特之秤仍然决定底层链路的物理边界,语义之秤决定上层"该传什么"。两层秤叠放而非互相取代——这是本册第 9 章收尾时的立场。
本节要点回顾
- 莫尔斯码的考古演算显示十九世纪手感编码已贴近静态逐字母设计的熵界(约百分之九的时间开销),霍夫曼码把这项工艺做到最优(约千分之七超出);
- 三层演进分别以抽象、逼近、扩容为主题:第一层立秤与剥离,第二层把距极限的分贝数变成工程 KPI,第三层把秤搬进网络、量子与智能系统;
- 每次扩容都源于前一层饱和:点对点理论完成后工艺追赶,工艺贴线后理论向结构与语义延展;
- 语义重返秤盘由资源极端约束与智能接收端两个现实变化推动,但它与比特之秤是叠放关系,不是取代关系;
- 判断一个新概念的位置,先问它称的是符号概率、工艺距离、交互结构还是任务效用——这个四象定位法贯穿全册。