2.1 自信息与熵:给单条消息定重量
2.1 自信息与熵:给单条消息定重量
本节摘要:从"罕见者重、独立可加"两条朴素要求推出自信息的对数形式,定义信源熵并梳理其非负性、对称性与极值性质,用 Python 对三种典型分布称出读数,并说明信息熵与热力学熵的同源关系。
先提两条称重要求
把一条消息放上秤盘之前,先得回答"重量"该满足什么要求。设想化验员对报文里的事件定重量,有两条朴素要求几乎无法拒绝。
第一条:越罕见越重。"明早太阳升起"几乎必然发生,知道了它等于什么也没说;"明早有流星雨"概率极小,一旦证实,改动你对世界的预期就大得多。重量应该随概率单调递减,概率趋近一时重量趋近零。
第二条:独立事件重量可加。两次独立抛掷的联合结果,其重量应当是两次重量之和——先知道第一次的结果,再知道第二次,惊讶度应该叠起来而非乘起来。这条"可加"要求与第一条的"递减"放在一起,几乎锁死了唯一的函数形式:重量必须正比于概率的负对数。取二为底,单位就是比特——自信息定义为概率倒数的对数。
这个推导值得停一秒。它说明对数刻度不是聪明人的发明,而是要求的必然——就像质量单位不是被发明的,是被"可加与守恒"逼出来的。香农的公理化证明(一九四八年附录)做的正是这件事:再补上连续性与对分布的连续依赖,满足全部公理的形式只有熵这一族。
从单块矿石到整批:熵的登场
自信息称的是单个事件,但信源吐出的是源源不断的符号流,工程上要的是这批货的平均重量。对自信息按概率加权求平均,得到的就是香农熵。它读作"每符号平均不确定度",单位比特每符号。
# 三种典型分布的熵读数:同一符号集,重量迥异 from math import log2 def entropy(probs): return -sum(p * log2(p) for p in probs if p > 0) uniform = [1/8] * 8 # 八符号完全均匀 tilted = [0.40, 0.20, 0.15, 0.10, 0.06, 0.04, 0.03, 0.02] # 概率倾斜 degenerate = [1.0, 0, 0, 0, 0, 0, 0, 0] # 退化:永远只出一个符号 print(f"均匀分布 H = {entropy(uniform):.4f} 比特/符号 ← 达到 log2(8) = {log2(8):.1f} 的最大值") print(f"倾斜分布 H = {entropy(tilted):.4f} 比特/符号 ← 规律出现,重量下降") print(f"退化分布 H = {entropy(degenerate):.4f} 比特/符号 ← 零不确定,零重量") # 输出: # 均匀分布 H = 3.0000 比特/符号 ← 达到 log2(8) = 3.0 的最大值 # 倾斜分布 H = 2.4298 比特/符号 ← 规律出现,重量下降 # 退化分布 H = 0.0000 比特/符号 ← 零不确定,零重量
三个读数放在一起,熵的性格一目了然。同样的符号集,均匀分布最重——每个符号都不可猜;概率一旦倾斜,高频符号的短自信息被加权放大,总读数下降;极端退化时熵归零——信源永远只会说一句话,听第一句之后就没有任何悬念。熵称的是"不可猜的程度",而不是"内容的多少",这是初学者最容易拧错的一个旋钮。
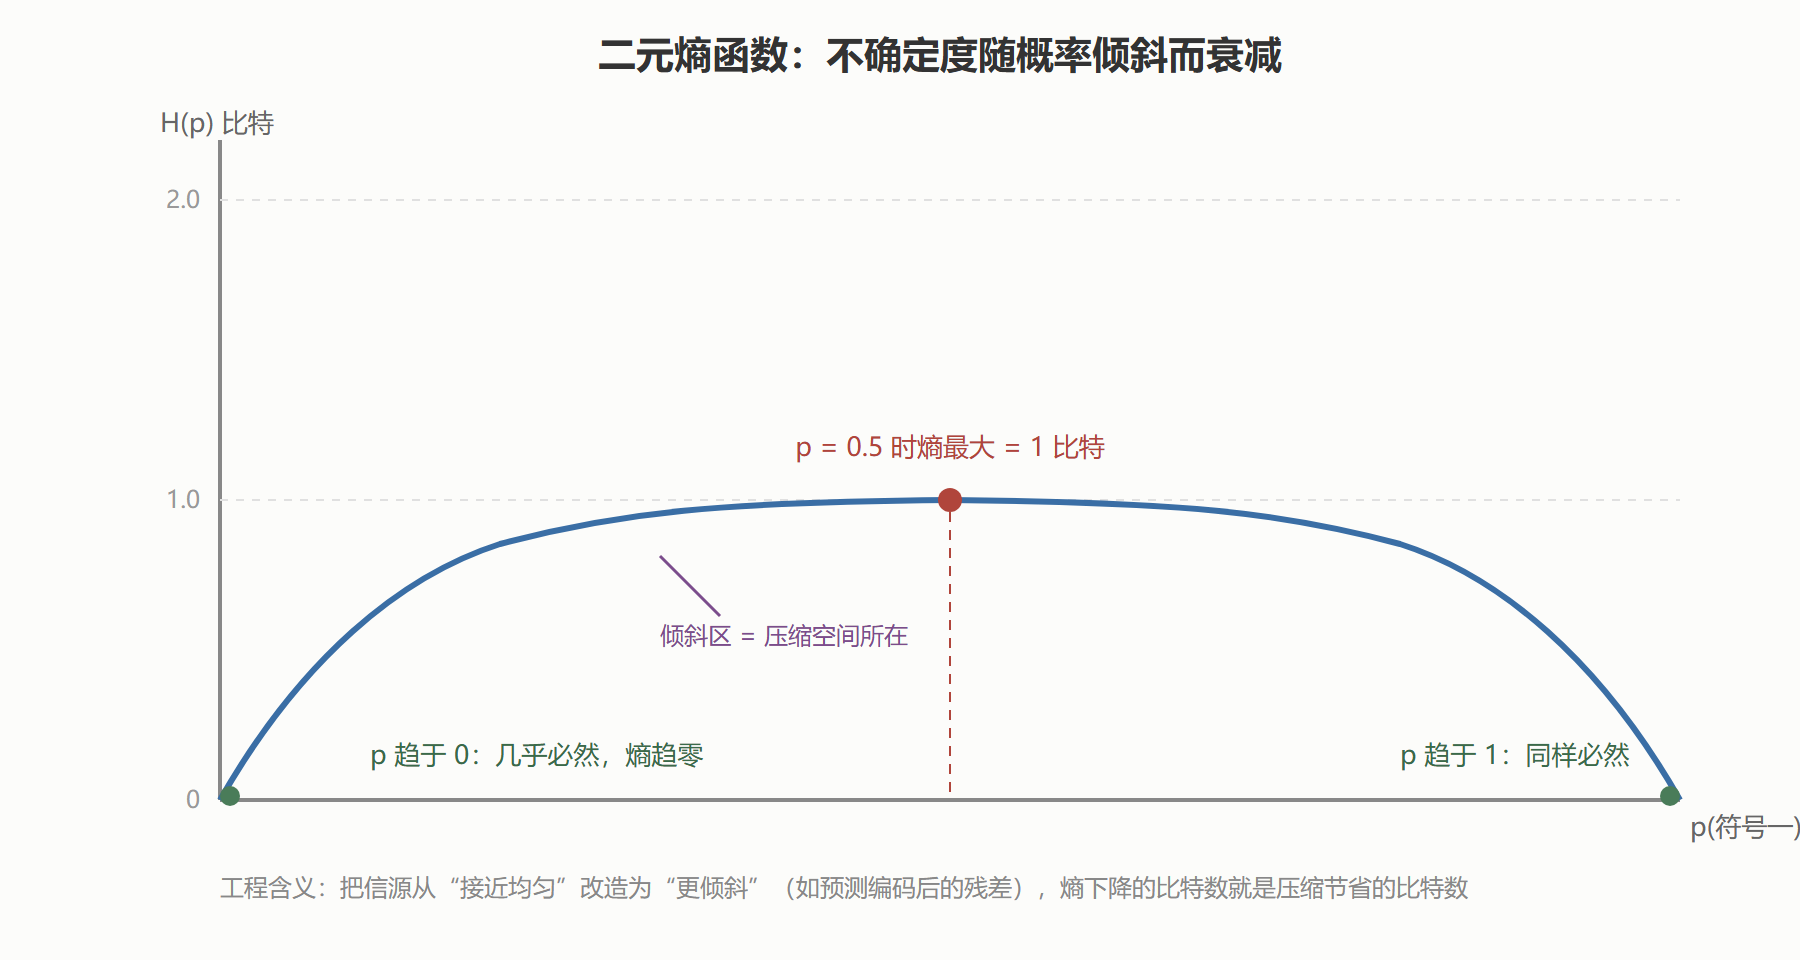
熵随概率倾斜的衰减曲线
二元信源(只有零与一两种符号)是理解熵性质的最小实验室。下图把熵画成其中一个符号概率的函数:从零点爬升到对称轴上的最高点一比特,再对称落下。
熵的四条性质,各配一句天平解读
非负性。熵不小于零,且等号当且仅当某符号概率为一。秤上没有负重量:不存在"知道结果反而更糊涂"的分布层面现象(个别事件的自信息为零,但平均不可能是负的)。
对称性。对符号重新命名不改变熵——把骰子的红面改成蓝面,可猜程度不变。熵只看概率的排序谱,不看符号的内容,这再次印证"去语义化"的彻底。
极值性。在固定符号数的所有分布中,均匀分布的熵最大,值为符号数的对数。这条性质的工程投影是:加密后的密文、良好的哈希输出、白噪声,都应当接近均匀分布——"看起来最乱"恰恰是"信息论上最满"的状态。压缩做的是反向运动:让输出分布尽可能倾斜,熵尽可能低。
可加性(独立情形)。两个独立信源的联合熵等于各自熵之和。两个不相干的化验员各称各的矿样,总重量就是两次读数相加;一旦两个信源相关,联合熵就会低于熵之和——省下的那部分正是第 2.3 节的互信息。
💡 一条常被忽视的直觉:熵是"平均最少要问几个是非问题才能猜中结果"的度量。对均匀的八符号信源,最优策略是三分的二分询问,恰好三个问题——与熵的读数一致。这个"二十问题游戏"视角把抽象的期望对数变成了可玩的游戏,也解释了为什么压缩与猜测是同一件事的两面。
与热力学熵的同源关系
信息熵的公式与统计力学里的玻尔兹曼熵形式几乎相同,这不是巧合。玻尔兹曼熵统计的是微观状态分布的均匀程度,香农熵统计的是消息分布的均匀程度;两者都以"负对数概率的平均"为核心。一九五七年,杰恩斯把这种形式同源升华为最大熵原理:在已知约束下,应当选择熵最大的分布作为推断——不引入任何约束之外的主观假设。这个原理让熵从通信的量具变成了统计推断的一般方法论,物理、生态、语言学里都能看到它的应用。方向上要分清:热力学第二定律说孤立系统熵趋于增加,而通信里我们努力让信源熵降低(压缩)或让信道熵最大化(加密与扰码)——同一枚砝码,在不同车间朝不同方向使用。
用"二十个问题"把熵玩出来
熵的"平均是非问题数"读法值得亲手玩一遍。规则:对手心里想一个对象,你只能问是非题,目标是用最少的问题猜中。对均匀的六十四选一(比如猜一个六位二进制数),最优策略是每次对半分——六个问题必中,与熵的读数(六比特)一致。但如果对象分布倾斜(常见对象占大头),聪明的问法是先问概率大的那一半——平均问题数会低于均匀情形的对数值,且严格等于该分布的熵(霍夫曼码的提问版本)。
这个游戏直接对应压缩:最优提问策略就是最优前缀码,每个问题是一次"零或一"的回答,一串回答就是码字。第 3 章的霍夫曼算法因此可以读成"最优问问题策略的构造"——把最不可能的两个对象合并成一个问题节点,逐层向上。反过来,玩过这个游戏的人对"熵是不确定度的货币单位"不会再有隔阂:每比特就是一次完美对分提问的答案。
常见问题三则
**熵可以是负数吗?**不可以。自信息对单个事件非负(概率在一到零之间,负对数非负),加权平均继承非负性;熵为零当且仅当分布退化。注意区分"事件的信息量"(非负)与"信息量之差"(可为负,如条件作用让某具体情形的不确定度上升)。
**加一个零概率符号会改变熵吗?**不会。约定零概率项贡献为零(对应极限),熵只由"实际会出现的符号"决定。代码实现里要显式跳过零概率项,否则零的对数未定义——这是初学者复现熵计算时最常见的报错来源。
**比特是"信息量"还是"存储单位"?**两者相通但语境不同:存储里的一比特是物理单元(一个触发器、一个磁畴);信息论里的一比特是抽象量纲(一次完美对分提问的答案)。一台一千吉比特的硬盘装满均匀随机数据,信息量就是一千吉比特;装满全零,信息量是零——存储占满了,信息没有。两个语境的区分在讨论压缩极限时尤其重要。
本节要点回顾
- 自信息是对数刻度的必然:由"罕见者重"与"独立可加"两条要求唯一确定,概率倒数的对数,单位比特;
- 熵是概率加权的平均自信息,称的是"不可猜程度"而非内容多少,与语义无关;
- 均匀分布熵最大、退化分布熵为零:规律与倾斜都让熵下降,全部压缩空间来自熵的下降;
- 四条基本性质——非负、对称、极值、独立可加——每条都有直接的工程投影(密文的均匀性、重命名不变性、加密与压缩的反向运动);
- 与热力学熵形式同源,经最大熵原理升华为统计推断的一般方法论。
单个信源的砝码铸好了。下一节把第二台秤推上来:两个随机变量联合作业时,联合熵、条件熵与链式法则如何拆解"总重量"与"剩余不确定度"。