2.2 联合熵与条件熵:批量消息的称量术
2.2 联合熵与条件熵:批量消息的称量术
本节摘要:把度量从单个随机变量扩展到成对变量:联合熵称两批货的总重,条件熵称已知一侧后另一侧的剩余不确定度,链式法则给出分解公式。用一个天气与通勤的完整数值例子把四种熵一次算清,并导出"条件作用使熵不增"的关键不等式。
两个车间共享一条传送带时会怎样
设想两条生产线共用一条传送带出货:一边是天气预报车间(输出晴或雨),一边是通勤建议车间(输出坐地铁或开车)。传送带上的货物是成对出现的——每个早晨,天气与通勤决策一起经过海关。要给这条传送带上的货物称重,单个信源的熵不够用了:我们需要联合的秤(联合熵),还需要"先看了天气货单、再看通勤货单时还需要称多少"的秤(条件熵)。
这个设定不是玩具。通信系统里,发送端符号与接收端符号就是成对出现的两个随机变量;语音识别里,声学特征与音素标签成对;推荐系统里,用户与物品的交互成对。凡是要回答"一端对另一端知道多少",本节的两把秤都是先决工具——而它们合成的读数(互信息)要到下一节才正式亮相。
联合熵:把联合分布表整表称重
联合熵的定义是单个变量情形的直接推广:对联合分布的每个格子取负对数,按联合概率加权平均。直观读法:要猜中"一对"结果,平均需要的是非问题的个数。天气加通勤一共四种组合,全靠猜当然最贵;若两变量高度相关(雨天几乎必坐地铁),联合表里大量格子的概率趋零,总重随之下降。
条件熵:已知一侧后的剩余重量
条件熵回答的是:先告诉你天气,再让你猜通勤方式,平均还要问几个问题。计算分两步走——对每个天气取值,先算条件分布的熵(这一侧已知时,另一侧的不确定度),再按天气的概率加权平均。条件熵因此是"熵的平均",而非"平均的熵",这个次序区别在链式法则里至关重要。
链式法则把三把秤串成一句话:联合熵等于边缘熵加条件熵。先称天气的重量,再称"已知天气后通勤还剩的重量",两次读数相加就是成对货物的总重。这个分解可以按任意次序进行,也可以推广到任意多个变量——逐步条件下,一整张联合表可以拆成一串条件熵的和。语言模型正是这样逐词分解的:整句话的熵等于每个词在给定前文下的条件熵之和,"预测下一个词"的交叉熵损失由此成为训练目标,这是第 8 章的伏笔。
天气与通勤:一张表算清四种熵
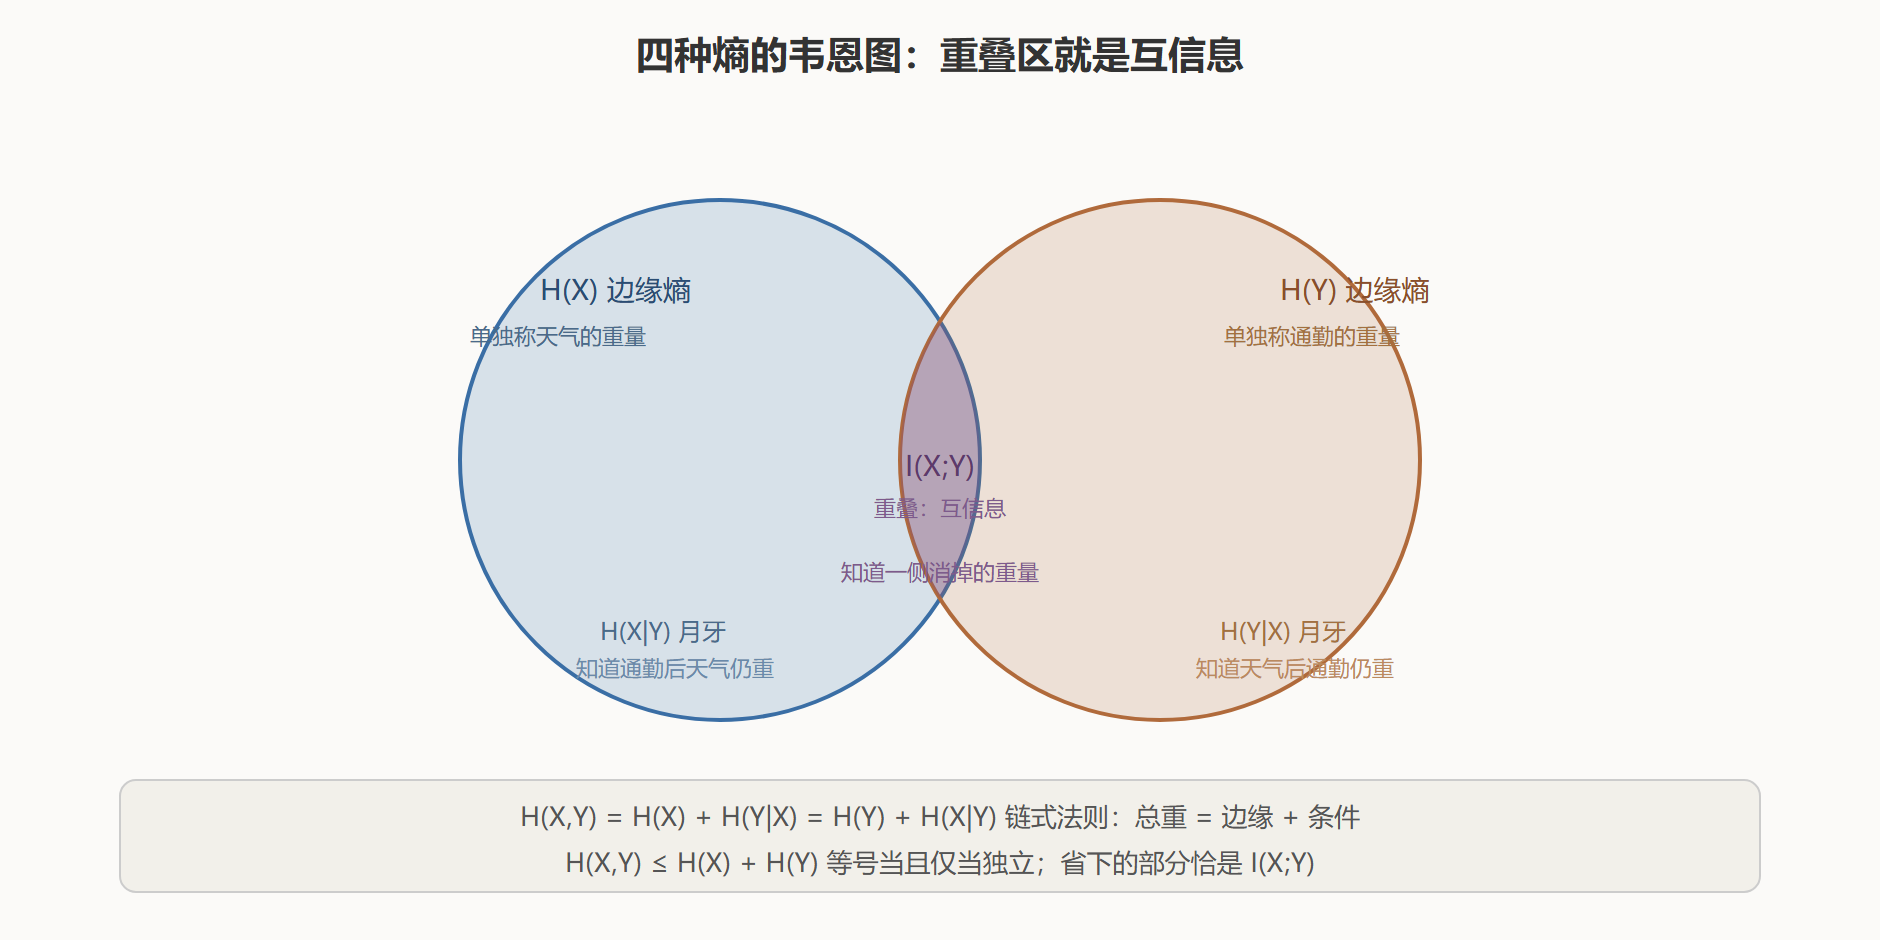
用具体数字把这张韦恩图填满。设天气晴的概率为零点七、雨为零点三;晴天里坐地铁与开车的条件概率是四六开,雨天则倒向地铁(八二开)。下面的代码把四种熵一次算清。
# 天气 X 与通勤 Y 的完整称量:四种熵一次算清 from math import log2 def ent(probs): return -sum(p * log2(p) for p in probs if p > 0) px = [0.7, 0.3] # P(X=晴), P(X=雨) py_given_x = [[0.4, 0.6], # 晴天: 地铁, 开车 [0.8, 0.2]] # 雨天: 地铁, 开车 joint = [[px[i] * py_given_x[i][j] for j in range(2)] for i in range(2)] # 联合概率表: [[0.28, 0.42], [0.24, 0.06]] H_X = ent(px) # 天气的熵 H_YgX = sum(px[i] * ent(py_given_x[i]) for i in range(2)) # 通勤的条件熵 py = [sum(joint[i][j] for i in range(2)) for j in range(2)] H_Y = ent(py) # 通勤的边缘熵 H_XY = H_X + H_YgX # 链式法则:联合熵 print(f"联合表: 晴+地铁 {joint[0][0]:.2f} 晴+开车 {joint[0][1]:.2f} 雨+地铁 {joint[1][0]:.2f} 雨+开车 {joint[1][1]:.2f}") print(f"H(X) 天气熵 = {H_X:.4f} 比特") print(f"H(Y|X) 已知天气后通勤仍重 = {H_YgX:.4f} 比特") print(f"H(Y) 通勤边缘熵 = {H_Y:.4f} 比特") print(f"H(X,Y) 联合熵(链式) = {H_XY:.4f} 比特") print(f"H(X)+H(Y) 若两者独立 = {H_X + H_Y:.4f} 比特 ← 联合熵少掉的部分就是重叠") # 输出: # 联合表: 晴+地铁 0.28 晴+开车 0.42 雨+地铁 0.24 雨+开车 0.06 # H(X) 天气熵 = 0.8813 比特 # H(Y|X) 已知天气后通勤仍重 = 0.8962 比特 # H(Y) 通勤边缘熵 = 0.9988 比特 # H(X,Y) 联合熵(链式) = 1.7775 比特 # H(X)+H(Y) 若两者独立 = 1.8801 比特 ← 联合熵少掉的部分就是重叠
读数里有三处值得停留。第一,通勤的边缘熵接近一比特——不看天气时,坐地铁还是开车几乎对半开,很难猜。第二,知道天气后条件熵仍有约零点九比特——天气只帮通勤减掉了约零点一比特的重叠,比多数人的直觉小得多:天气对通勤确实有影响,但影响远没有"决定性"那么大。第三,联合熵低于边缘熵之和——省下的零点一零二六比特正是两变量的相关部分,下一节它将获得正式名字:互信息。
条件作用使熵不增:一条重要不等式
比较 H(Y) 与 H(Y|X) 的读数会发现后者不超过前者。这不是数字巧合,而是一条一般不等式:平均而言,额外信息不会增加不确定度。证明思路是杰恩斯不等式——用错误的边缘代替真实条件分布做编码,平均码长只会更长,超出部分恰是相对熵(下一节的量具),而相对熵非负。
这条不等式有两个方向上的推论,都常被误用。推论一:逐个条件叠加,条件熵单调不增——知道得越多,剩余的不确定度越低,这支持了"特征越多模型熵越低"的直觉。推论二要谨慎:它说的是平均意义。对某个特定的条件取值,条件熵完全可能高于无条件熵——例如"晴天堵车时通勤更难猜"完全合法;平均化之后不确定性才必然下降。把平均命题误当逐点命题,是应用条件熵时最常见的翻车点。
⚠️ 常见坑:把 H(Y|X) 读成"某个 X 取值下的熵"。条件熵是对所有条件取值加权平均的结果,不对应任何单一情形。工程报告里写"已知信道输入时输出的熵",指的永远是平均版本。
多变量的推广与语言模型的伏笔
链式法则向多个变量推广毫无障碍:联合熵逐个条件下展开,每一步"给定前面所有变量"再取条件熵。变量次序可以任意选,但各项的数值随次序变化——只有总和不变。这个自由度在实践里极其有用:概率图模型选择"因果顺序"来分解,使每一项条件熵尽量小(条件分布尽量倾斜);语言模型选择"时间顺序",让每个词的条件熵贴着真实语言的熵率。
语言模型在这里的接口值得点破:整段文本的负对数概率(训练里的损失)正是链式法则各项之和——"每词平均负对数概率"就是模型给出的每词交叉熵,而它的理论下界是语言的真实熵率。语言学家对英语熵率的经典估计(香农本人的打字实验到后来的大规模语料估计)落在大约每字符一到一点五比特——远低于等概假设的四点七比特。上下文把不确定度压掉了七成以上,这就是一切文本压缩与语言建模共同追逐的那块冗余矿脉。
本节要点回顾
- 联合熵对联合分布整表称重,读作"猜中一对结果所需的平均问题数";
- 条件熵是条件分布熵的加权平均,先算各条件下的熵、再按条件概率平均,次序不可颠倒;
- 链式法则 H(X,Y)=H(X)+H(Y|X) 可按任意次序分解,是联合分布逐变量拆解的总纲,也是语言模型逐词分解的理论依据;
- 次可加性 H(X,Y) ≤ H(X)+H(Y):相关让总重变轻,省下的重叠部分即互信息;
- 条件作用平均不增熵,但逐点可以增——平均命题不能当逐点命题使用。
两把秤都已就位,重叠区还没命名。下一节正式铸造互信息这枚砝码,并带上它的孪生兄弟——相对熵。