3.1 无损压缩的极限:香农第一定理
3.1 无损压缩的极限:香农第一定理
本节摘要:建立无损编码的合法性框架——前缀码与克拉夫特不等式;给出香农码构造并证明平均码长落在熵与熵加一之间;陈述香农第一定理(无失真信源编码定理),说明块编码如何让开销消失,并澄清"突破熵界"宣称的正确打开方式。
别急着相信任何"压缩黑科技"
别以为压缩是玄学,也别相信任何宣称"对任意文件再压一半"的黑科技。任何一个声称突破熵界的压缩器,要么偷偷改变了问题(比如利用了你对文件类型的先验知识),要么在特定样本上赌赢了平均值,要么干脆是错的。这不是工程谨慎,是数学禁令——本节的任务就是把这条禁令的证明链条完整摆出来:码长怎么分配才合法(克拉夫特不等式)、合法分配里最便宜的是什么(香农第一定理)、以及怎样逼近这个最便宜(香农码与块编码)。
合法码长的户口:前缀码与克拉夫特不等式
无损编码的接收端必须能无歧义地把码字流切回符号序列。最稳妥的实现是前缀码:任何码字都不是另一个码字的前缀。这样接收端读到一个完整码字就能立即切分,不需要回溯。前缀码与"二叉树上的叶子"一一对应——每个码字是树根到某片叶子路径上的左右转序列,叶子互不包含,切分自然唯一。
并非所有"唯一可译"的码都是前缀码,但一个深刻的事实是:任何唯一可译码的码长集合,都存在一个具有相同码长集合的前缀码。因此讨论平均码长的下限时,只在前缀码里讨论不损失一般性。前缀码的码长要满足什么条件?克拉夫特不等式给出充要刻画:所有码长的二的负次幂之和不超过一。把每个码字看作二叉树上占用的一段路径,这个和就是路径占用率——树只有一棵,占用率超一的码长分配根本造不出来。
# 克拉夫特不等式:判断一组码长是否可能是合法前缀码 from math import log2, ceil def kraft_sum(lengths): return sum(2.0 ** (-l) for l in lengths) print(kraft_sum([1, 2, 3, 3])) # 0.5+0.25+0.125+0.125 = 1.0 ← 等号:满树,合法 print(kraft_sum([2, 2, 2])) # 0.75 ≤ 1 ← 合法(还有空位) print(kraft_sum([1, 1, 2])) # 1.5 > 1 ← 非法:前两个码字已占满 # 输出: # 1.0 # 0.75 # 1.5
第三个例子的非法性一眼可见:两个长度为一的码字把二叉树第一层占满,第三个码字无论怎么挂都会成为某者的前缀。克拉夫特不等式把这个几何直觉变成了可计算的判据——它是码长世界的"户口审查"。
香农码:一步到位的贴线构造
有了合法性判据,最优化问题就清楚了:在克拉夫特约束下最小化"码长按概率的加权平均"。香农给出的构造直接了当——给概率为 p 的符号分配长度为"负对数 p 向上取整"的码字。罕见符号拿长码,常见符号拿短码,长短严格跟着自信息走。
这个构造的妙处在于它自动合法:取整只增不减码长,克拉夫特和被压在一以内(下节会看到具体数字)。它的平均码长也立即可控:每个码长至多比自信息大一,平均码长至多是"熵加一"。
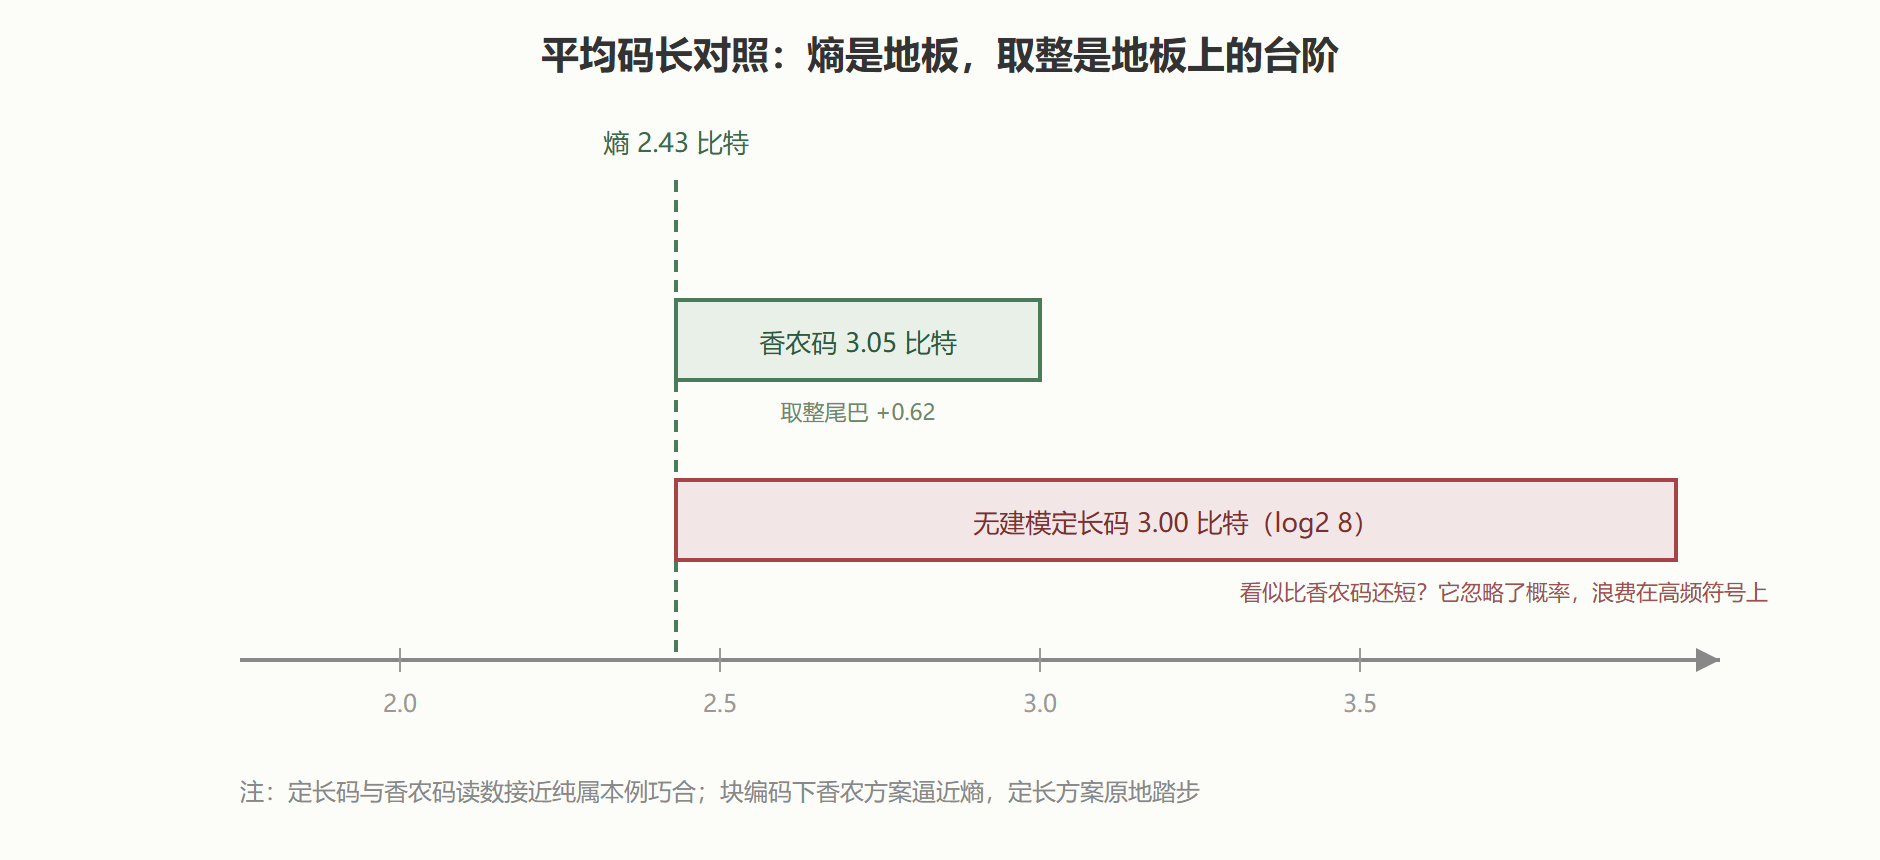
# 香农码:码长跟着自信息走,平均码长被夹在熵与熵加一之间 from math import log2, ceil probs = [0.40, 0.20, 0.15, 0.10, 0.06, 0.04, 0.03, 0.02] H = -sum(p * log2(p) for p in probs) lengths = [ceil(-log2(p)) for p in probs] avg = sum(p * l for p, l in zip(probs, lengths)) print("符号概率:", probs) print("香农码长:", lengths) print(f"克拉夫特和 = {sum(2.0**-l for l in lengths):.4f} ≤ 1 ← 合法") print(f"熵 H = {H:.4f} 香农码平均码长 = {avg:.4f} 超出熵 {avg - H:.4f}") # 输出: # 符号概率: [0.4, 0.2, 0.15, 0.1, 0.06, 0.04, 0.03, 0.02] # 香农码长: [2, 3, 3, 4, 5, 5, 6, 6] # 克拉夫特和 = 0.6562 ≤ 1 ← 合法 # 香农码平均码长 = 3.05 超出熵 0.62
三条码长的对照:熵界、香农码与定长码
下图把"八符号倾斜信源"的三种码长方案放在同一根数轴上比较——熵是地板,香农码贴着地板但带着取整尾巴,定长三比特则是无建模时代的浪费。
香农第一定理:下界的正式陈述
现在可以陈述本节的主定理(无失真信源编码定理):对熵为 H 的离散无记忆信源,任何唯一可译码的平均码长都不小于 H;反过来,存在前缀码使平均码长任意接近 H。前半句的证明只有两行——平均码长减去熵可以整理成两个分布之间相对熵的形式再加一项非负量,而相对熵非负;后半句由香农码加块编码实现。
块编码消尾巴是定理的工程要点。逐符号编码时,"向上取整"给每个符号最多添一比特的尾巴;把 n 个符号捆成一块整体编码,尾巴最多还是一比特,却摊给了 n 个符号——每符号开销不超过一除以 n,块越大尾巴越细。极限意义上,平均码长滑到熵上。代价是复杂性:n 个符号的联合分布有指数级规模,块不能无限加大——逼近熵的代价是计算资源,这是理论极限与工程现实之间的永恒汇率。现代压缩软件(上下文混合建模配上算术编码)走的正是这条路:用统计模型逼近真实分布,用算术编码磨掉整数化开销,实测效率达到熵的九成五以上。
💡 关键直觉:压缩的下界不由聪明才智决定,由你对信源的建模精度决定。模型分布与真实分布的相对熵,就是你为"不知道"付出的每一比特。所谓更好的压缩器,本质是更好的统计学家。
一个必须澄清的边界:熵界不适用于单个文件
"任何文件都压不过它的熵"——这句话常被误引。严格地说,熵界约束的是信源(概率分布)的平均码长,不是单个样本文件的长度。柯尔莫哥洛夫复杂度才是单个字符串的极限(最短生成程序长度),而它不可计算。由此产生了著名的"压缩计数论证":绝大多数随机串不可压缩,但存在极少数碰巧高度可压的串——任何声称对一切输入都有效的压缩器必然在另一些输入上膨胀。判断压缩器好坏,要看它在目标分布上的平均表现,而不是个别文件的惊艳成绩。这也是本节开头对"黑科技"保持怀疑的数学根据。
把第一定理放回全册地图
第一定理的位置值得标记清楚:它是"熵的第一次上岗"——第 2 章铸造的砝码第一次显示工程威力(给出压缩地板)。它的姊妹篇在两端:负方向的补全是柯尔莫哥洛夫复杂度(单串的极限,不可计算——本节的边界澄清);正方向的扩展是速率失真理论(允许失真后地板进一步下移——下一节)。三者合起来构成"压缩极限"的完整族谱:信源级可算、单串级不可算、有损级可算但引入失真参数。记住这张族谱,遇到任何"压缩极限"的表述就能立刻定位它在说哪一个。
本节要点回顾
- 前缀码保证即时切分,与二叉树叶子一一对应;任何唯一可译码的码长集合都有等价前缀码,讨论下界不失一般性;
- 克拉夫特不等式是码长的户口审查:二的负码长次幂之和不超过一,充要刻画合法前缀码;
- 香农码按"负对数概率向上取整"分配码长,平均码长被夹在熵与熵加一之间,合法且一步到位;
- 香农第一定理:平均码长的下界是熵,块编码让"加一"的尾巴按块长摊薄消失,逼近的代价是计算复杂性;
- 熵界约束的是信源平均而非单个文件,单串的极限是柯尔莫哥洛夫复杂度(不可计算),"对所有文件都有效"的压缩器在数学上不存在。
下界立好,工艺登场。下一节从零实现霍夫曼编码与算术编码,用一段真实文本检验它们离熵界到底有多近。