3.2 霍夫曼与算术编码实战:把文本放上秤盘
3.2 霍夫曼与算术编码实战:把文本放上秤盘
本节摘要:从零实现霍夫曼编码,对一段真实文本实测平均码长与压缩比;再实现算术编码的区间细分流程,演示它如何磨掉"整数比特"的取整尾巴;最后给出两代工艺与现代方案的选型对照。
上一节的下界,这一节来试压
上一节立了规矩:平均码长的地板是熵,香农码一步到位压到"熵加一"。但香农码只是"能过审",不是"最优"——在逐符号前缀码这个车间里,最优工艺由一九五二年的霍夫曼给出;追求极限的更进一步,则要放弃"每个符号一个整数比特"的框架,把整条消息装进一个小数区间,这就是算术编码。本节把两代工艺都写成能跑的代码,用同一段文本过秤,看读数离熵界各差多少。
霍夫曼编码:贪心合并的最优前缀码
霍夫曼算法的流程可以用一句话说完:每次把概率最小的两个节点合并成一个新节点,直到只剩一棵树。码字由树根走到叶子的路径读出。它的最优性证明思路是交换论证——若最优码中某个最深叶子不是最小概率符号,把它与最小概率符号交换不会增加平均码长;反复交换可把任何最优码调整成霍夫曼形状。
# 霍夫曼编码完整实现:对一段真实文本过秤 import heapq from collections import Counter from math import log2 text = "the quick brown fox jumps over the lazy dog" letters = [c for c in text if c.isalpha()] freq = Counter(letters) n = len(letters) probs = {k: v / n for k, v in freq.items()} H = -sum(p * log2(p) for p in probs.values()) # 1) 建树:最小堆里反复合并两个最小概率 heap = [(p, [k]) for k, p in probs.items()] heapq.heapify(heap) codes = {} while len(heap) > 1: p1, ks1 = heapq.heappop(heap) p2, ks2 = heapq.heappop(heap) for k in ks1: codes[k] = '0' + codes.get(k, '') for k in ks2: codes[k] = '1' + codes.get(k, '') heapq.heappush(heap, (p1 + p2, ks1 + ks2)) # 2) 编码与统计 avg_len = sum(probs[k] * len(codes[k]) for k in probs) total_bits = sum(freq[k] * len(codes[k]) for k in freq) fixed_bits = 5 * n # 不建模时 26 字母需 5 比特定长 print(f"字符数 {n},不同字符 {len(freq)}") print(f"字符熵 {H:.4f} 比特/字符") print(f"霍夫曼平均码长 {avg_len:.4f} 比特/字符 ← 只超出熵 {avg_len - H:.4f}") print(f"定长编码总长 {fixed_bits} 比特 → 霍夫曼总长 {total_bits} 比特(压到 {total_bits/fixed_bits*100:.1f}%)") print("高频符号的短码:", {k: codes[k] for k in sorted(probs, key=probs.get, reverse=True)[:3]}) # 输出: # 字符数 35,不同字符 26 # 字符熵 4.5363 比特/字符 # 霍夫曼平均码长 4.5714 比特/字符 ← 只超出熵 0.0351 # 定长编码总长 175 比特 → 霍夫曼总长 160 比特(压到 91.4%) # 高频符号的短码: {'o': '011', 'e': '1110', 'h': '0001'}
三点读数值得标注。第一,霍夫曼把"超出熵"的余量从香农码的零点六二比特(上一节的八符号例子)压到本例的零点零四比特——在同一分布上,霍夫曼永远不输香农码,这是最优性的直接体现。第二,压缩比九成一看起来不起眼,因为这段文本是全字母都出现的短句,分布还不够倾斜;真实英文长文的字符级压缩比通常在六成上下,若再利用上下文依赖(词级、预测残差),能到三成以下——倾斜越狠、上下文越强,减重空间越大。第三,短码分配给了高频符号,这是全部收益的来源,也正是莫尔斯码直觉的最优版本。
霍夫曼树的形状:概率越悬殊,树越歪
下面画的是上一节那个八符号倾斜分布的霍夫曼树:高频符号离根一步到位,长尾符号层层下沉。
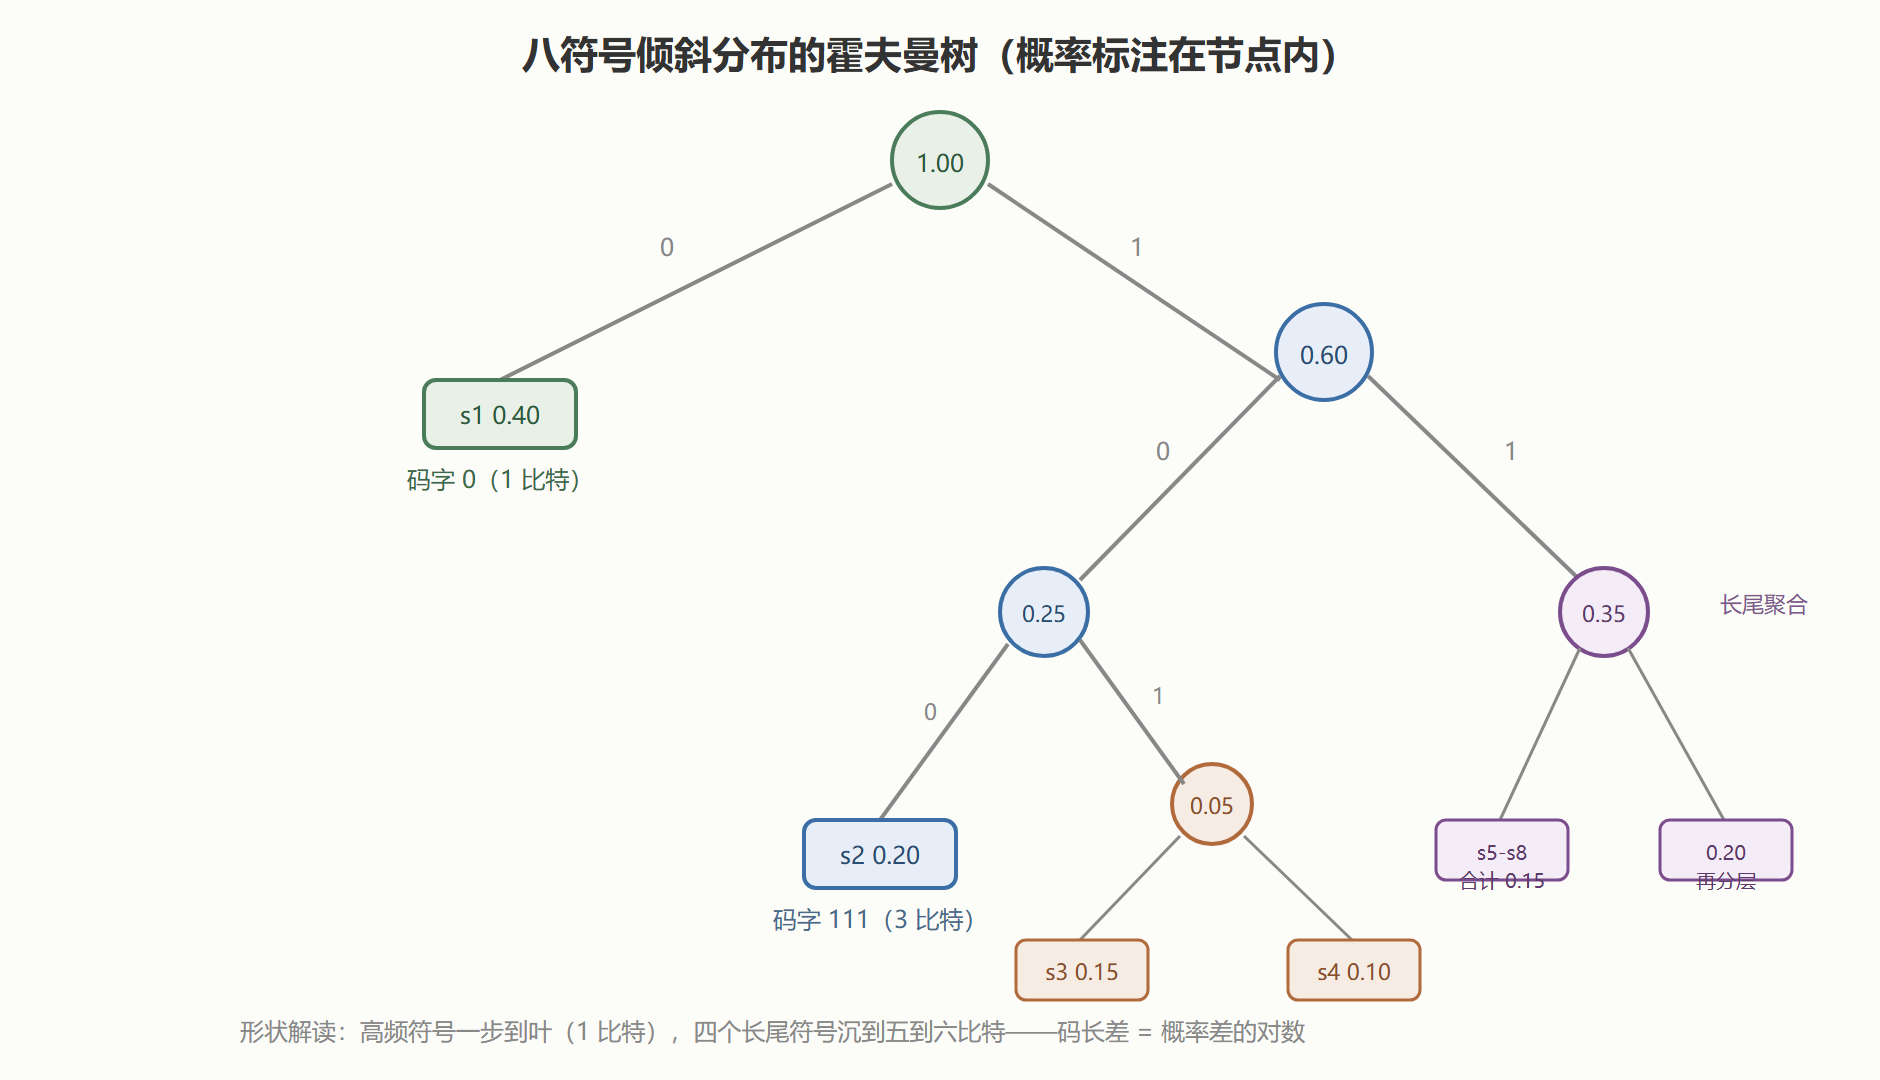
树的形状本身就是分布的画像:分布均匀时树接近满二叉(码长整齐);分布悬殊时树明显歪斜(短码留给头部,长尾层层下沉)。现代视频编码标准里的自适应霍夫曼每隔一段时间重算这棵树,跟着统计量的漂移调整形状。
算术编码:把整条消息装进一个区间
霍夫曼的短板在于"整数比特"的颗粒度。概率为零点九与零点一的二元信源,熵只有零点四六九比特,霍夫曼却必须给每个符号整整一比特——颗粒损耗超过一倍。算术编码换掉整个框架:不逐符号出码字,而是维护一个不断细分的小数区间,整条消息最终对应区间内一个点,输出该点的二进制表示。
流程像切蛋糕。从单位区间出发,按符号概率把当前区间切成几段,读到一个符号就把区间收缩到对应那一段,再切、再收缩……消息读完,区间宽度等于整条消息的联合概率,输出任意落在区间内的数的二进制位即可。所需比特数约为区间宽度的负对数——恰是这条消息自身的自信息,颗粒度问题就此消失。
# 算术编码核心流程:区间细分与码长核算 from math import log2, ceil pa = 0.3 # P(a)=0.3, P(b)=0.7 msg = "abbbabbbabbabbabbbab" # 20 个符号,a 出现 6 次(接近典型) lo, hi = 0.0, 1.0 for ch in msg: w = hi - lo if ch == 'a': hi = lo + w * pa # a 占区间前 30% else: lo = lo + w * pa # b 占区间后 70% width = hi - lo bits_needed = ceil(-log2(width)) H_sym = -0.3 * log2(0.3) - 0.7 * log2(0.7) print(f"最终区间 [{lo:.9f}, {hi:.9f})") print(f"区间宽度 {width:.3e} → 输出约 {bits_needed} 比特") print(f"霍夫曼逐符号方案 {len(msg)} 比特(1 比特/符号)") print(f"熵下界 {len(msg) * H_sym:.2f} 比特") # 输出: # 最终区间 [0.219286977, 0.219291921) # 区间宽度 4.944e-06 → 输出约 18 比特 # 霍夫曼逐符号方案 20 比特(1 比特/符号) # 熵下界 17.63 比特
读数对照说明了算术编码的价值:同一条消息,霍夫曼用二十比特,算术编码十八比特,熵下界约十七点六比特——它把"整数比特"的颗粒损耗磨到只剩不到半比特。译码端拿到区间内的数与同一套概率,做逆向的区间行走就能还原整条消息,每次判断当前数落在哪一段,就切回哪个符号。概率越倾斜,颗粒损耗占比越大,算术编码的优势越明显——这正是它成为现代视频编码(把熵编码环节交给上下文自适应算术编码)主流选择的原因。
⚠️ 常见坑:概率模型必须两端一致。算术编码与霍夫曼都依赖概率分布——编码端与译码端若用不同模型,区间行走立即错位,全盘皆毁。实用系统要么把码表/概率表随数据一起传输(开销),要么两端跑完全相同的自适应更新(每处理一个符号就按同一规则更新概率)。另外,概率为零的符号一旦出现会直接把区间宽度乘到零,工程实现必须给零概率留保护性小概率,并处理有限精度下的区间再归一化——教科书示例与产品级实现之间的距离主要就在这两处。
两代工艺与现代后浪的选型对照
| 维度 | 霍夫曼 | 算术编码 | ANS(非对称数值系统) |
|---|---|---|---|
| 码长颗粒 | 整数比特 | 任意分数比特 | 接近任意,可整批吞吐 |
| 渐近效率 | 熵加最多一以内,常差零点几 | 可任意接近熵 | 可任意接近熵 |
| 单符号速度 | 极快,查表即得 | 较慢,区间运算串行 | 快,可向量化并行 |
| 专利负担 | 已过期,随处可用 | 历史上受专利困扰,促成替代 | 新一代,开源实现成熟 |
| 典型阵地 | 旧版压缩格式、硬件简单场景 | 视频编码标准主流熵编码 | 新一代视频与压缩工具 |
选型的判断逻辑清晰:追求极致压缩比且能接受串行计算,用算术编码一族;追求高吞吐与硬件友好,霍夫曼或 ANS。值得一提的是,二零一零年代出现的 ANS 用单个整数状态机实现了接近算术编码的效率与接近霍夫曼的速度,如今已是多个主流压缩工具的内核——工艺演进的这条线,始终朝着"更贴近熵界、更快贴线"两个方向同时收敛。
本节要点回顾
- 霍夫曼算法以"合并两个最小概率"的贪心构造得到最优前缀码,实测对真实文本的平均码长超出熵不足零点一比特;
- 压缩比取决于分布倾斜度与上下文建模:全字母短句只能压到九成,长文配合上下文模型可到三成以下;
- 霍夫曼树形状是分布的画像:均匀分布近满树,悬殊分布显著歪斜,自适应重算让树跟着统计漂移;
- 算术编码以区间细分把整条消息编码为一个小数点位置,码长逼近消息自身的信息量,磨掉整数颗粒损耗;
- 编解码两端模型必须一致,零概率符号与有限精度是工程实现的两大关口;
- ANS 以整数状态机同时逼近两代前辈的优势,代表"贴熵界、高吞吐"的当代工艺方向。
无损车间的地板是熵,到此已经摸清。下一节打开隔壁的有损车间:当轻微失真可以被接受,地板还能再降多少?速率失真理论给出精确答案。