3.3 有损压缩与速率失真:接受误差换取减重
3.3 有损压缩与速率失真:接受误差换取减重
本节摘要:定义失真度量与率失真函数,推导二元信源汉明失真下的显式公式并用代码算出整条曲线;对照均匀量化、劳埃德-马克斯量化、变换编码与感知加权四类工艺在曲线上各自摘取的收益;说明速率失真思想如何进入机器学习。
一张图片少几个像素,谁会真的注意到
把一张千万像素的照片无损压缩,码率可能仍以兆计;但社交平台存储与分发的版本往往只有其零头——因为接收端的"人"并不需要每个像素都精确。音频里二十千赫兹以上的分量人耳听不见,视频里相邻帧的微小纹理差异眼睛分辨不出。这些"接收端不在乎的误差"就是有损车间的原料:允许磕碰,换更轻的包裹。
关键在于把"允许磕碰"变成数学。失真不能只是形容词,得是可计算的量——两个符号之间的失真函数(汉明失真:不同记一相同记零;平方失真:差值的平方)扩展到序列,按概率平均,就得到编码方案的平均失真。有了它,问题可以正式提出:在平均失真不超过给定值 D 的所有编码方案里,最低能达到的码率是多少——这个最小值就是率失真函数 R(D)。它是有损车间的"承重-精度"交换表,地位相当于无损车间里的熵。
率失真函数:用条件分布的语言重新提问
R(D) 的严格定义用互信息表述:在所有满足平均失真约束的条件分布里,找使输入输出互信息最小的那个。这个定义初看绕,实质是把"编码方案"抽象成"从输入到重建的随机映射"——确定性的编码是它的特例。互信息衡量的正是这套映射必须保留的信息量;约束失真,就是允许映射丢掉一部分。
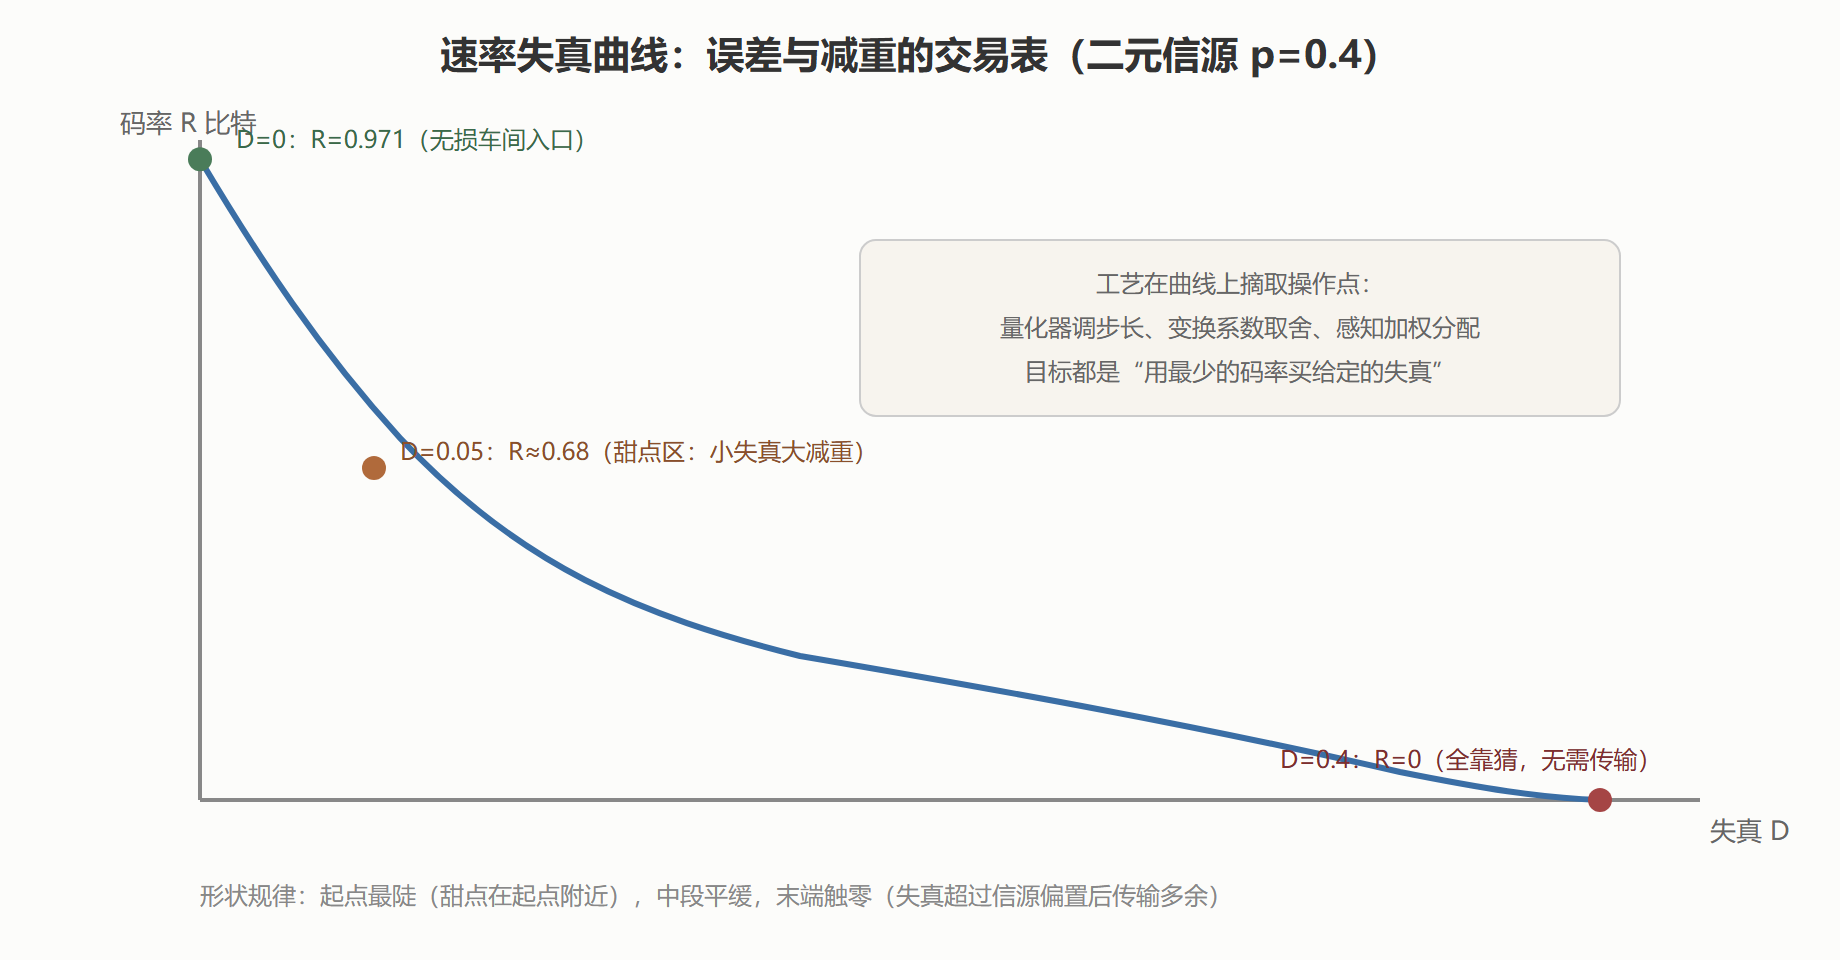
对最简单的设定——概率为 p 的二元信源配汉明失真——R(D) 有闭式解:当失真不超过 p 时,率失真函数等于二元熵函数在 p 处的值减去在 D 处的值;失真一旦达到 p,码率归零。后半句有个漂亮的解释:如果信源一的概率是零点四,那么"全部重建成零"这个看似耍赖的方案平均失真恰好零点四——什么都不传,靠猜,就能白嫖到失真 p。允许的失真超过这个数,传输就完全没必要了。
# 二元信源汉明失真下的率失真曲线:p = 0.4 from math import log2 def H2(p): return -p * log2(p) - (1 - p) * log2(1 - p) if 0 < p < 1 else 0.0 p = 0.4 print(f"信源熵 H2({p}) = {H2(p):.4f} 比特 ← D=0 时的码率上限(回到无损车间)") for D in [0.0, 0.05, 0.1, 0.2, 0.3, 0.4]: R = max(H2(p) - H2(D), 0.0) if D < p else 0.0 print(f"允许失真 D = {D:<5} 最低码率 R(D) = {R:.4f} 比特/符号") # 输出: # 信源熵 H2(0.4) = 0.9710 比特 ← D=0 时的码率上限(回到无损车间) # 允许失真 D = 0.0 最低码率 R(D) = 0.9710 比特/符号 # 允许失真 D = 0.05 最低码率 R(D) = 0.6846 比特/符号 # 允许失真 D = 0.1 最低码率 R(D) = 0.5020 比特/符号 # 允许失真 D = 0.2 最低码率 R(D) = 0.2490 比特/符号 # 允许失真 D = 0.3 最低码率 R(D) = 0.0897 比特/符号 # 允许失真 D = 0.4 最低码率 R(D) = 0.0000 比特/符号 ← 全猜 0,白嫖到失真 p
这条曲线的形状值得细看:开头最陡——失真从零放宽一点点,码率就大幅跳水(本例放宽到零点零五就省三成码率);中段平缓——继续放宽失真,节省越来越边际;末端触零——到达 p 后传输完全多余。"最甜的收益在起点附近"是有损压缩的普遍经验:现代编码器把质量从"完美"降到"极好",码率常常减半;从"可接受"再往下降,体验崩坏的速度远快于码率节省。
速率失真曲线与工艺操作点
四类工艺如何在曲线上作业
量化是最古老的有损操作:把连续取值映射到有限的代表点。均匀量化等间距摆代表点,简单但对非均匀分布浪费;劳埃德-马克斯量化(即 k 均值的一维前身)按"代表点是各自辖区的概率质心"迭代摆放,对高斯类分布能逼近失真下界的渐近公式。量化的本质是在失真曲线上主动选择一个操作点:步长越粗,D 越大、R 越低。
变换编码先换坐标系再量化。图像的像素域里能量摊得很平,但离散余弦变换或小波变换后,能量集中到少数低频系数上——同样的失真预算,集中量化头几个系数远比均摊给所有像素划算。变换本身不压缩(可逆),它做的事是把分布变得更倾斜,让随后的量化与熵编码在更低的熵上工作。这是"变换+量化+熵编码"三段式成为一代标准的结构性原因。
感知加权更换失真的度量衡。汉明与平方误差把所有位置一视同仁,但人眼对平坦区域的误差敏感、对纹理区迟钝,人耳有响度掩蔽。把失真函数本身改成感知加权的形式,曲线整体下移——同样的主观质量,码率更低。心理声学模型在音频编码中决定"哪些分量可以大胆扔",就是给 R(D) 换了一套更贴近接收端的坐标。
预测与上下文则从时间维度收集倾斜:视频帧间预测把"运动补偿残差"送给量化器,残差分布远比原始像素倾斜,同样失真下码率更低。它与无损车间里的建模思想完全同源——有损与无损的差别只在"是否多了一个失真约束",建模逻辑一脉相承。
率失真思想的现代迁徙
这套"花失真买码率"的记账方式早已越过压缩的地界。机器学习里的自编码器,目标函数常写成"重建误差加隐层码长"的加权和——前者是失真项,后者是码率项,调节权重就是在 R(D) 曲线上滑动操作点。信息瓶颈理论(第 8 章展开)更进一步:把"重建输入"换成"保留标签相关信息",得到了关于表征学习的一整套分析工具。控制与通信交叉的"远程操控"研究也用它刻画传感精度与带宽的分配。可以说,凡是要在"精度"与"资源"之间做交易的场合,率失真都是天然的记账语言。
💡 一条容易被忽略的洞见:R(D) 是可达性的下界,不是某个具体算法的输出。工程上"当前编码器离 R(D) 还有多远"与"离 Shannon 极限还差几分贝"同构——理论给的是地板,工艺的成绩单要用与地板的距离来写。
一张图片的完整减重旅程
把四类工艺串成一条真实的流水线——这正是主流图像压缩标准的骨架。变换先行:图像切成八乘八的小块,逐块做离散余弦变换,能量集中到左上角少数低频系数。量化接棒:按量化表对系数做粗化——低频系数步长细(人眼敏感)、高频系数步长粗(人眼迟钝),这张表就是"感知加权"的具象化,也是质量参数实际拨动的旋钮。预测穿插其间:直流系数与相邻块差分编码,把分布进一步倾斜。熵编码收官:对量化后的系数序列跑自适应算术编码(现代标准)或霍夫曼(旧标准),磨掉整数化尾巴。四个车间各司其职:变换造倾斜、量化换失真、预测收时间相关、熵编码贴熵界——第 3 章的全部理论在一张 JPEG 图片里各就各位。变体只是车间组合不同:视频加帧间预测、无损模式去掉量化、新一代标准换更精细的预测与更聪明的熵编码器——流水线的拓扑从未变过。
本节要点回顾
- 失真函数把"允许磕碰"变成可计算的约束,率失真函数 R(D) 给出"失真换码率"的精确交换表;
- 二元汉明失真的闭式解 R(D)=H2(p)−H2(D),失真到达 p 后码率归零——全猜单边即可白嫖;
- 曲线形状规律:起点最陡、中段平缓、末端触零,最划算的减重在"从完美到极好"的第一段;
- 四类工艺(量化、变换、感知加权、预测)分别以选操作点、制造倾斜、换度量衡、收时间倾斜的方式在曲线上作业;
- 率失真记账法已迁徙到自编码器、信息瓶颈与远程传感,成为一切"精度换资源"问题的通用语言。
减重车间到此完整。下一章走进承重检测室:信道容量如何定义、香农第二定理为何保证"低于容量即可靠",以及工程上逼近这条线的纠错工艺。