4.2 香农第二定理:可靠传输的边界线
4.2 香农第二定理:可靠传输的边界线
本节摘要:陈述并解释信道编码定理的双向结论——低于容量存在可靠编码、高于容量差错无从压制;用随机编码与联合典型性讲清正定理的证明图像,用法诺不等式勾勒逆定理的逻辑;以重复码的数值实验反衬"聪明的码本"为何必不可少。
噪声存在,差错却可以任意小
一个初听像悖论的断言:信道里噪声永远存在,但只要速率低于容量,就能把差错概率压到任意小——不用提高功率,不用换线路,只要把码字取得足够长。噪声没有消失,它被稀释了:单个比特的翻转是随机灾难,而一个长达数千比特的码字里,噪声的集体行为变得高度可预测(大数定律),统计规律替你完成了纠错。
这就是香农第二定理(信道编码定理)的正向部分:对任何速率低于容量的传输,存在码长足够大的编码方案,使平均差错概率任意接近零。反向部分同样锋利:速率高于容量时,任何编码的差错概率都被压在某个正下界之上——可靠传输在数学上不可能。两条合起来,容量就是可靠与不可靠的分界线,没有中间地带。
正定理的证明图像:随机码本与球体装箱
香农的证明技巧在当时石破天惊——他不去构造好码,而是证明随机抽出来的码平均而言是好的。流程分三步。
第一步,随机生成码本:按输入分布独立抽出大量候选码字,发给消息编号。第二步,译码用"联合典型性"判据:接收序列与真实码字应当在统计上"长得像搭档"(经验分布接近联合分布)。第三步,统计错误来源:码字间互相冒充的概率随码长指数衰减,把所有坏事件的概率加总,只要速率低于容量,总错误率随码长趋于零。
几何图像是"球体装箱":高维空间里,围绕每个码字有一个由典型序列构成的噪声球,速率低于容量时这些球互不重叠、装得下;速率超过容量,球必然互相挤压——挤压处就是无法消除的差错。维度越高,球的相对体积越规整——这正是长码的魔力所在:高维统计比低维更守规矩,噪声的集体行为可以被码本的统计设计精确利用。
💡 随机编码证明的副产品:好码不仅存在,而且在所有码中占比不小——否则随机抽取不会以高概率抽到好码。坏的不是"好码稀少",而是"找到它们并高效译码"很难。这直接预告了后六十年编码理论的主战场:显式构造与可计算译码。
逆定理:法诺不等式如何关门
反方向的证明靠一条小巧的不等式。法诺不等式说:若从输出 Y 猜输入 X 的差错概率是 Pe,则剩余条件熵不超过"二元熵在 Pe 处的值加 Pe 乘以符号数对数"——直观读法是**"猜错一点点,才会剩一点点不确定;想几乎不猜错,输出必须几乎锁定输入"**。
把它接到传输链上:条件熵是速率的守门员,输出若锁不住输入,传信速率就被顶在容量之下;反过来,速率一旦超过容量,法诺不等式强制 Pe 高于一个正下界——门就这样关上了。两级(信源与信道)类似论证合起来还顺带证明了信源信道编码定理:只要信源熵低于信道容量,端到端可靠传输可行——这句总纲是第 5 章分离定理的前半句。
朴素的可靠有多贵:重复码的反面教材
"把每个比特发三遍,少数服从多数"——这是最直觉的纠错方案。它确实有效,但代价表惊人。下表在翻转概率零点一的 BSC 上实测(码率一除以 n,差错率为多数判决后的比特错误概率)。
# 重复码在 BSC 上的实测:朴素可靠的代价曲线 from math import comb, log2 def H2(p): return -p * log2(p) - (1 - p) * log2(1 - p) if 0 < p < 1 else 0.0 p = 0.1 C = 1 - H2(p) print(f"BSC 翻转概率 {p},容量 C = {C:.3f} 比特/使用 —— 重复码离它有多远?\n") for n in [1, 3, 5, 7, 9, 11]: # 多数判决出错 = 翻转数过半(奇数 n 无平局) err = sum(comb(n, k) * p**k * (1-p)**(n-k) for k in range(n//2 + 1, n + 1)) print(f"重复 {n:>2} 遍: 码率 {1/n:.3f} 比特差错率 {err:.5f}") # 输出: # BSC 翻转概率 0.1,容量 C = 0.531 比特/使用 —— 重复码离它有多远? # 重复 1 遍: 码率 1.000 比特差错率 0.10000 # 重复 3 遍: 码率 0.333 比特差错率 0.02800 # 重复 5 遍: 码率 0.200 比特差错率 0.00856 # 重复 7 遍: 码率 0.143 比特差错率 0.00273 # 重复 9 遍: 码率 0.111 比特差错率 0.00089 # 重复 11 遍: 码率 0.091 比特差错率 0.00030
读这张表要用两把尺子。可靠性尺:重复码确实把差错从零点一压到万分之三,有效。效率尺:为此付出的代价是码率从一跌到零点零九——而香农保证在零点五三一的码率下同样能做到差错任意小。重复码把冗余花在"每个比特的自我复读"上,随机编码思想则把冗余摊在整个码本的统计结构上——前者是每个士兵自带干粮,后者是整个后勤系统的统筹。差距是本质性的:想要差错率降一个数量级,重复码要多花五倍带宽,好码只需要把码长加长一截,码率几乎不动。
可靠性与速率的交易地图
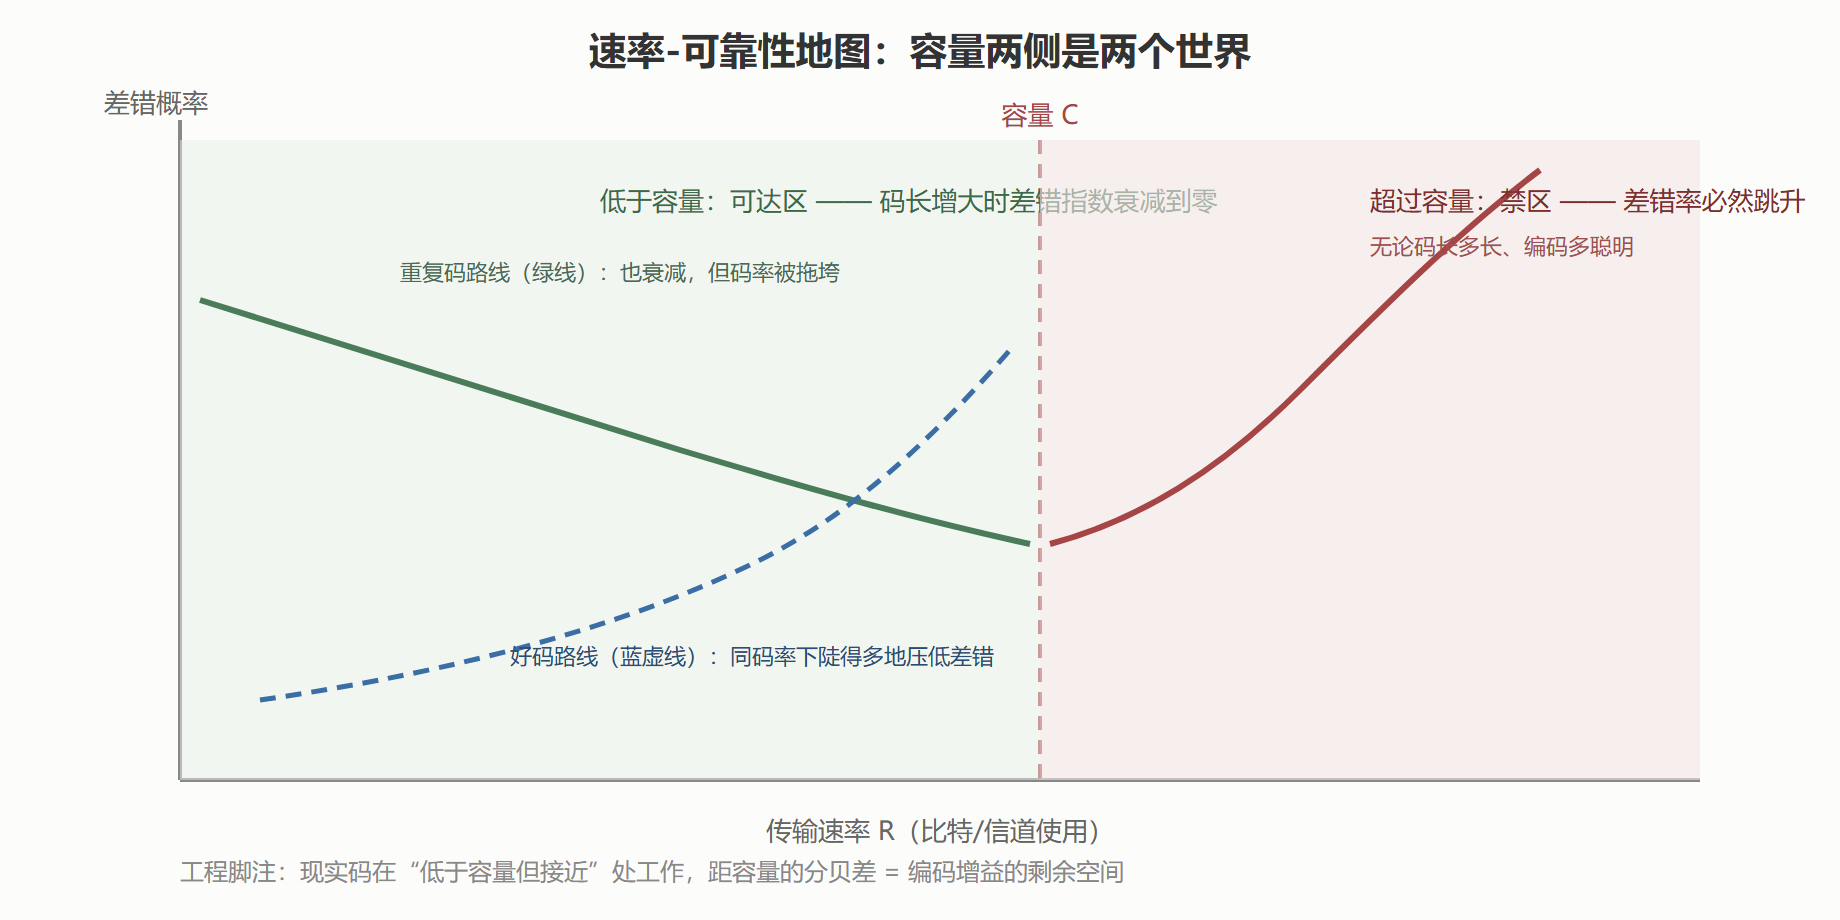
定理的边界与常见误读
**误读一:"低于容量就没有错误"。**错。定理是渐近命题:固定码长的系统仍有错误,只是码长越长错误越指数稀少。工程上"零差错"永远是规格化的说法(低于某阈值),不是绝对零。
**误读二:"容量是硬墙,贴着它工作也一样可靠"。**可靠性在接近容量时需要码长暴涨——差错指数随"容量减速率"的间隙衰减,间隙趋零,需要的码长与译码复杂度趋于无穷。实用的操作点永远留有余量,这个余量就是现代编码竞逐的战场。
**误读三:"有了反馈就能超过容量"。**下一章会严格讨论:无记忆信道的因果反馈不增加容量,它改善的是差错衰减速度与复杂度,不是极限承重。
误差指数:差错衰减的速度学
定理说差错概率随码长趋零,工程追问的是"多快"。随机编码的误差指数给出答案的形状:差错概率按码长的负指数衰减,指数是"容量与速率之差"的函数——离容量越远,跌得越陡。这条性质解释了瀑布曲线(第 4.3 节)的存在:速率固定、信噪比扫过瀑布点时,指数从近乎零瞬间变大,差错率在几分贝内掉几个数量级——曲线的"陡"不是画图技巧,是指数律的直观呈现。
反方向的"强逆定理"同样值得记一笔:速率超过容量后,差错率不仅不趋零,还被压在一个随码长指数上升趋于确定的水平——超过容量的长码传输不是"勉强出错",是"必然出错"。两条指数律一上一下,把容量这条分界线焊死在一个点:左边指数下降,右边指数上升,中间没有过渡带。这是渐近信息论最锋利的一张图。
本节要点回顾
- 香农第二定理双向划界:速率低于容量存在任意可靠的编码;高于容量差错率有正下界,可靠传输不可能;
- 正定理的证明是随机化的:随机码本平均表现好,联合典型性给出译码判据,噪声球在高维空间互不重叠是核心图像;
- 好码不稀少,难在显式构造与高效译码——这是六十年编码理论的日程表;
- 法诺不等式是逆定理的钥匙:"几乎不猜错"强制"输出几乎锁定输入",速率因此被容量封顶;
- 重复码是反面教材:以码率崩塌换可靠性,与好码"码率几乎不动、码长换可靠性"的路线形成对照;
- 定理是渐近的,贴线工作需要爆炸的码长,实用系统永远留余量。
边界线既已划出,下一节检阅六十年工艺史:汉明码起步、维特比提速、turbo 与 LDPC 贴线、极化码给出达到容量的显式构造。