4.3 纠错码工艺:从汉明码到LDPC与极化码
4.3 纠错码工艺:从汉明码到 LDPC 与极化码
本节摘要:从零实现汉明(七,四)码的编码与伴随式译码并在 BSC 上实测增益;随后检阅卷积码与维特比译码、turbo 码、LDPC 与极化码三代工艺的逼近机理,给出一张选型对照表与工艺史的完整脉络。
从一个周末的愤怒说起
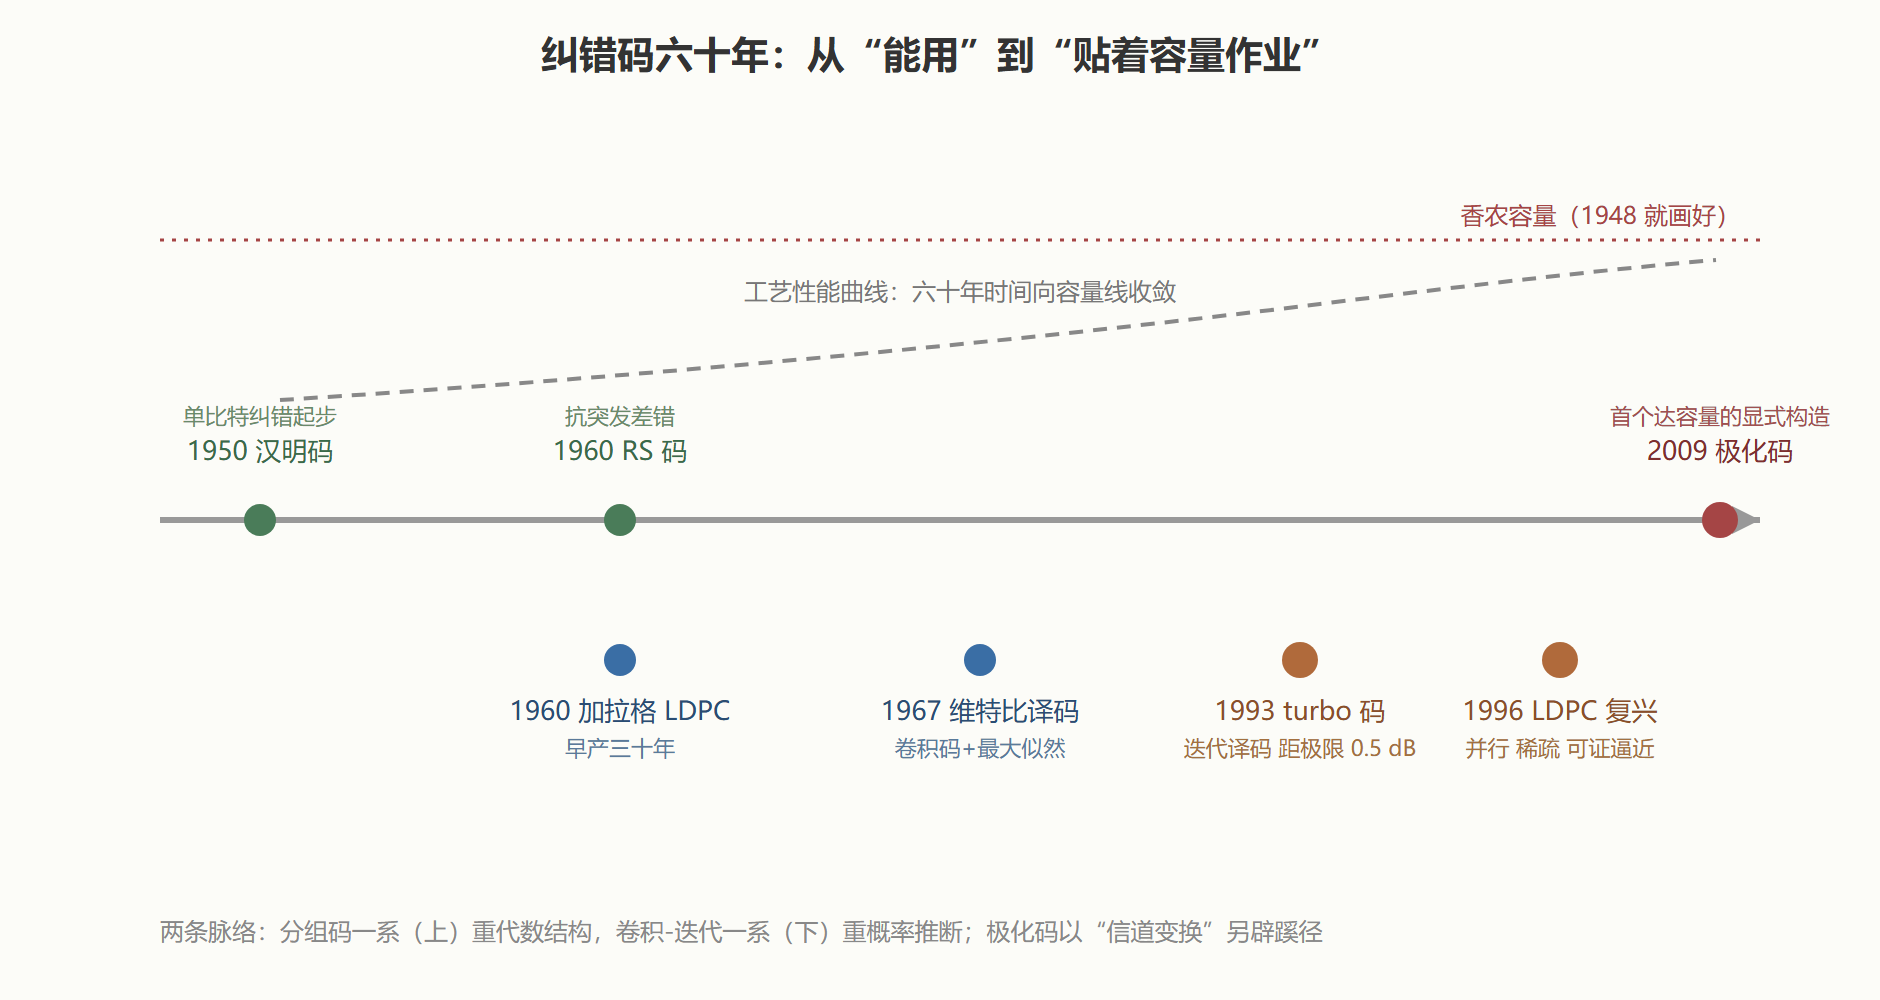
一九五零年前后,贝尔实验室的理查德·汉明在用穿孔卡片机算题,机器每逢读错就把整批作业退回重来。愤怒出工艺:他发明了让机器自己发现并改正单比特错误的编码——汉明码,纠错码历史的开篇。这个故事的启示在于纠错码的诞生动机:错误不是异常而是常态,工程要做的不是祈祷无误,而是设计能吸收错误的码字结构。
汉明(七,四)码把四个信息比特扩展成七比特码字,多出的三个校验位负责"给每个位置编号":接收端计算伴随式,若非零,其数值直接指出错在哪一位。下面是完整实现与实测。
# 汉明(7,4) 码:编码、伴随式译码与 BSC 实测 import random G = [[1,0,0,0,1,1,0], [0,1,0,0,1,0,1], [0,0,1,0,0,1,1], [0,0,0,1,1,1,1]] # 生成矩阵:左半单位阵(系统码),右半校验 H = [[1,1,0,1,1,0,0], [1,0,1,1,0,1,0], [0,1,1,1,0,0,1]] # 校验矩阵:H 的列 = 位置的二进制编号 COLS = {(H[0][j], H[1][j], H[2][j]): j for j in range(7)} def encode(m): return [sum(m[i] * G[i][k] for i in range(4)) % 2 for k in range(7)] def syndrome(r): return tuple(sum(H[i][j] * r[j] for j in range(7)) % 2 for i in range(3)) def decode(r): r = list(r) s = syndrome(r) if s != (0,0,0): r[COLS[s]] ^= 1 # 伴随式直接定位出错位,翻正它 return r[:4] # 自检:所有单比特错误都应被纠正 for m_int in range(16): m = [(m_int >> i) & 1 for i in range(4)] c = encode(m) assert syndrome(c) == (0,0,0) for flip in range(7): r = list(c); r[flip] ^= 1 assert decode(r) == m print("自检通过:16 个码字 × 7 个错位全部正确纠正") # BSC 实测 random.seed(42) for p in [0.03, 0.05, 0.10]: words = 50000 bit_err = word_err = 0 for _ in range(words): m = [random.randint(0,1) for _ in range(4)] r = [b ^ (1 if random.random() < p else 0) for b in encode(m)] d = decode(r) bit_err += sum(1 for a, b in zip(m, d) if a != b) word_err += (m != d) print(f"p={p:<5} 未编码差错率 {p:.4f} → 汉明码后 {bit_err/(words*4):.5f}" f"(码字错误率 {word_err/words:.5f},码率 4/7 ≈ 0.571)") # 输出: # 自检通过:16 个码字 × 7 个错位全部正确纠正 # p=0.03 未编码差错率 0.0300 → 汉明码后 0.00760(码字错误率 0.01748,码率 4/7 ≈ 0.571) # p=0.05 未编码差错率 0.0500 → 汉明码后 0.01854(码字错误率 0.04204,码率 4/7 ≈ 0.571) # p=0.10 未编码差错率 0.1000 → 汉明码后 0.06482(码字错误率 0.14616,码率 4/7 ≈ 0.571)
读数要对照容量看:翻转概率零点零五时 BSC 容量约零点七一四,汉明码码率零点五七一——离容量还有零点一四的间隙,但差错率已从百分之五降到不足百分之二。同一个码在更差的信道上会反噬:p 零点一时码字错误率高达百分之十五,因为两位错误会被伴随式"误纠"成另一位——纠错码的增益有适用区间,越界使用比不编码更糟的情形是存在的(这一点在 p 趋近零点五时尤为明显)。
卷积码与维特比译码:把编码变成流水线
分组码把信息切成块各自编码;卷积码则让校验位"记住历史"——当前输出由当前输入与之前若干输入共同决定,码字像卷积一样在时间上铺开。它的天然优势是流式处理与软判决友好:接收端拿到的不只是"判了零还是一",还有置信程度(软信息),把它用足能多赚约两分贝。
最优译码由维特比算法完成——在网格图上找最大似然路径的动态规划,每步只保留每个状态的最优路径("幸存路径")。维特比算法的深刻之处在于把指数级的路径搜索压成与状态数成线性的递推,这个思想后来遍布序列标注、语音识别与生物信息学的比对算法。深空任务从七十年代起长期采用卷积码级联里德-所罗门码的组合,直到 turbo 与 LDPC 接棒。
Turbo 码与 LDPC:迭代译码的胜利
一九九三年的 turbo 码带来范式转移:两个简单的卷积码通过交织器并联,译码器让两个译码器互相传递"外信息"、反复迭代——每次迭代都把对方的上次判决当作先验,置信度像滚雪球一样累积,几轮之后差错率陡降。当时评审一度不敢相信仿真结果:距离香农极限只差零点五分贝。
LDPC 的故事更曲折。加拉格一九六零年代就提出了低密度校验码与迭代译码,但受限于当时的计算条件被冷落;一九九六年被重新发现后,其"稀疏校验矩阵上的置信传播"算法与 turbo 思想殊途同归,且具备并行化与理论分析上的优势——置信传播与容量逼近的联系后来被证明:规则 LDPC 在足够长码长下可任意逼近容量。如今的无线与卫星标准、千兆级存储,LDPC 几乎是默认选项。两代码共同确立的洞见是:逼近容量不必依赖天文数字的联合译码,局部消息传递的迭代就够。
极化码:第一个"证明达到容量"的显式构造
二零零九年,阿里坎提出极化码,补上了最后一块理论拼图:第一个被构造性证明达到容量的码。核心操作是信道极化——把同一信道拷贝多份做特定变换,变换后的子信道会向两个极端分化:一部分变成近乎无噪的"好信道",另一部分变成近乎全噪的"坏信道"。把信息只放在好信道上、坏信道冻结成收发已知的固定值,码长趋于无穷时差错率趋于零,速率趋于容量。
极化码的实用优势还包括短码长下的性能与高效的连续消除列表译码。它被五 G 控制信道采纳(短码场景),而数据信道的大块传输则交由 LDPC——两大现代码分场景共存,这是通信标准里活生生的"工艺选型"。
六十年工艺族谱
选型对照:工程视角的收束
| 维度 | 汉明/BCH | RS 码 | 卷积+维特比 | turbo | LDPC | 极化码 |
|---|---|---|---|---|---|---|
| 逼近程度 | 远 | 中 | 中 | 贴线 | 贴线 | 达容量(渐近) |
| 译码复杂度 | 极低 | 低 | 中 | 中高 | 中(可并行) | 低到中 |
| 短码性能 | 一般 | 好(突发错) | 好 | 一般 | 一般 | 好 |
| 时延 | 极低 | 低 | 低 | 高(迭代+交织) | 中 | 低 |
| 典型阵地 | 内存纠错、条码 | 光盘、深空级联 | 深空旧标准 | 移动通信早期 | 五 G 数据、存储 | 五 G 控制信道 |
选型的第一问永远是场景:短控制消息要时延与确定行为,极化码占优;大块数据要吞吐与贴线性能,LDPC 占优;极端简单的硬件场景,汉明码至今未被淘汰。"哪代码最强"是没有意义的问题,"哪个操作点上哪个码最划算"才是。
⚠️ 常见坑:纠错码不是免费的保险。码率开得越低,冗余越多,有效吞吐越低——给不差的信道上强纠错是浪费带宽;给很差的信道上弱纠错则可能因"误纠"放大错误。工程做法是自适应编码调制:实时测信道质量,在"码率-调制阶数"的网格上滑动操作点,始终工作在当前信道容量下方一点点的位置。
本节要点回顾
- 汉明码用伴随式定位错误:校验矩阵的列就是位置编号,单比特错误被数值直接指出,实测把百分之五的差错压到不足百分之二;
- 纠错增益有适用区间,信道恶化到一定程度时误纠反而放大错误,操作点必须跟随信道状态调整;
- 卷积码+维特比把编码变成时间上的流水线,动态规划译码思想外溢到序列标注等多个领域;
- turbo 与 LDPC 确立迭代译码范式:局部消息传递即可逼近容量,置信传播成为连接编码理论与概率图模型的桥梁;
- 极化码通过信道极化构造给出首个达容量的显式证明,与 LDPC 在五 G 标准中分场景共存;
- 选型看操作点而非代际:短消息重时延、大块数据重吞吐、简单硬件重成本,各自有最优工艺。
至此,减重与承重两条线各自完整。下一章把它们放到同一张工作台上:分离定理说两间车间可以彻底解耦,而反馈与多天线则展示"改造信道本身"的另一种增益思路。