6.2 分布式源编码:分开称重合并报数
6.2 分布式源编码:分开称重合并报数
本节摘要:陈述斯莱普里安-沃尔夫定理——相关信源分开编码、联合译码可达联合熵的速率下界;用第 2 章的天气与通勤分布复算速率区域并与朴素方案对比;引出有损扩展(怀纳齐夫编码)与传感网络应用,说明"代价搬家"的架构含义。
两个观测员不能说话,却要合写一份报告
一片农田里装了两台传感器:一台测温、一台测湿。温度与湿度强相关(雨后都低、曝晒都高),但两台设备之间没有互相通信的带宽——各自只能闷头把读数压缩后发往基站。直觉强烈抗议:相关性必须靠商量才能利用,各压各的必然重复计价。第三种方案是给两台传感器之间拉一条专线让它们先联合再压缩,但专线的成本正是问题设定里付不起的东西。
一九七三年,斯莱普里安与沃尔夫证明了这个直觉是错的:只要基站(译码端)做联合译码,分开编码的两台传感器可以达到"仿佛联合压缩过"的速率下界——两者合计只需传联合熵那么多比特,与拉了专线完全一样。定理的速率区域由三条界围出:各自的速率不低于自己给定对方时的条件熵,合计速率不低于联合熵。
复算速率区域:接着第 2 章的账本算
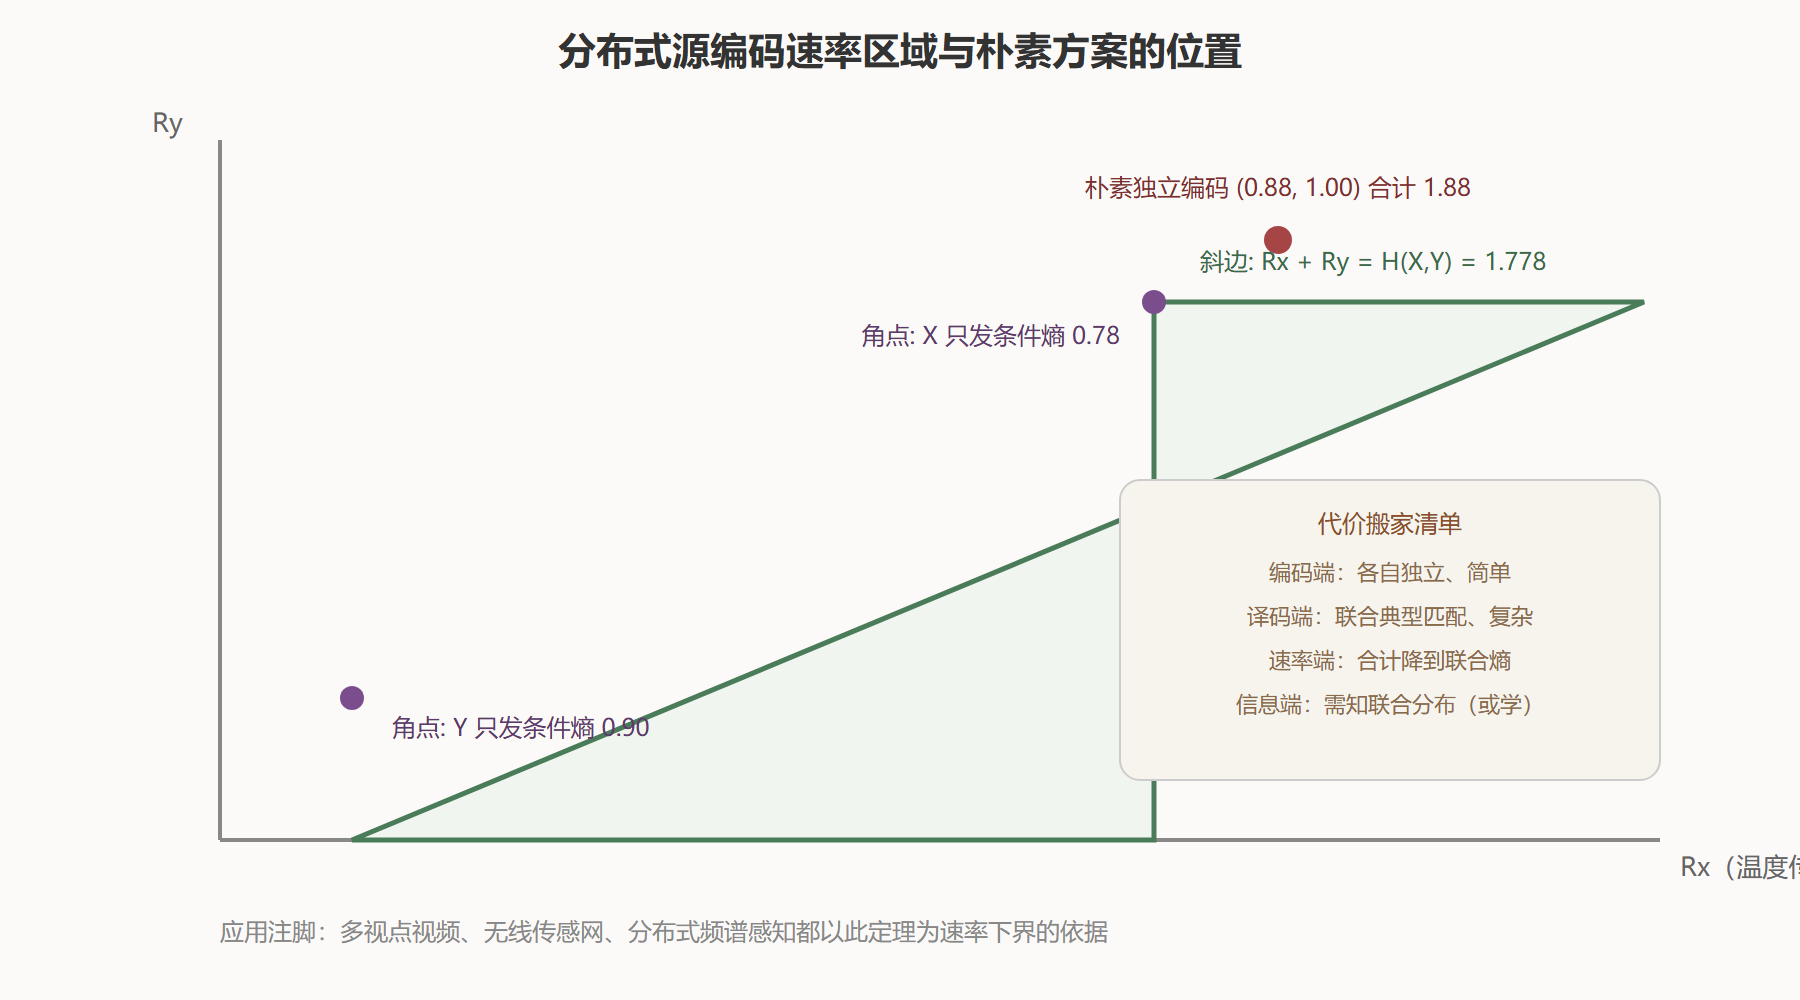
第 2 章的天气与通勤例子在这里恰好复用:H(X) 零点八八一三,H(Y) 零点九九八八,联合熵一点七七七五。套进斯莱普里安-沃尔夫的三条界。
# 分布式源编码:斯莱普里安-沃尔夫速率区域 vs 朴素独立编码 from math import log2 def ent(ps): return -sum(p * log2(p) for p in ps if p > 0) px = [0.7, 0.3] py_given_x = [[0.4, 0.6], [0.8, 0.2]] joint = [[px[i] * py_given_x[i][j] for j in range(2)] for i in range(2)] py = [sum(joint[i][j] for i in range(2)) for j in range(2)] H_X, H_Y = ent(px), ent(py) H_XY = sum(ent([joint[i][j], 1 - joint[i][j]]) * joint[i][j] for i in range(2) for j in range(2)) # 直接按定义算联合熵更清楚: H_XY = -sum(joint[i][j] * log2(joint[i][j]) for i in range(2) for j in range(2) if joint[i][j] > 0) H_XgY, H_YgX = H_XY - H_Y, H_XY - H_X print(f"边缘熵: H(X) = {H_X:.4f} H(Y) = {H_Y:.4f}") print(f"联合熵: H(X,Y) = {H_XY:.4f}") print(f"条件熵: H(X|Y) = {H_XgY:.4f} H(Y|X) = {H_YgX:.4f}") print(f"斯莱普里安-沃尔夫区域: Rx ≥ {H_XgY:.4f},Ry ≥ {H_YgX:.4f},Rx+Ry ≥ {H_XY:.4f}") print(f"朴素独立编码合计: H(X)+H(Y) = {H_X + H_Y:.4f}") print(f"联合压缩(理想专线): H(X,Y) = {H_XY:.4f}") print(f"节省 = {H_X + H_Y - H_XY:.4f} 比特,恰等于互信息 I(X;Y)") # 输出: # 边缘熵: H(X) = 0.8813 H(Y) = 0.9988 # 联合熵: H(X,Y) = 1.7775 # 条件熵: H(X|Y) = 0.7787 H(Y|X) = 0.8962 # 斯莱普里安-沃尔夫区域: Rx ≥ 0.7787,Ry ≥ 0.8962,Rx+Ry ≥ 1.7775 # 朴素独立编码合计: H(X)+H(Y) = 1.8801 # 联合压缩(理想专线): H(X,Y) = 1.7775 # 节省 = 0.1026 比特,恰等于互信息 I(X;Y)
三份账单并排放着:朴素方案一点八八零一比特,斯莱普里安-沃尔夫一点七七七五比特,理想联合压缩也是一点七七七五比特。分布式方案与拉了专线的结果完全打平,省下的零点一零二六比特恰好是两变量的互信息——相关性的收益一分没漏。而且区域的形状允许不对称分账:观测 X 的一方可以只发条件熵零点七七八七(把更多负担推给译码端去推断),观测 Y 的一方多发一些——速率的分配有自由度,总账不变。
机理:把"商量"搬进译码端
直觉上利用相关性需要商量,定理却免掉了商量,诀窍在于把商量的工作从编码端搬到译码端。编码端各自只管"我这个序列在同类里排第几"(索引到典型集即可);译码端同时拿到两份索引,在联合典型集合里找那个既匹配 X 索引又匹配 Y 索引的组合——因为相关性,联合典型集远小于两个单独典型集的乘积,正确的组合几乎总是唯一锁定。工程实现常用"边信息校验"的形式:一方全精度传,另一方只传校验比特(类似循环冗余校验的伴随式),译码端用对方数据做"陪衬"去解出一个最相容的估计——非对称式分布式编码在视频多视点压缩与传感网里有直接落地。
代价去哪了?复杂度与耦合都压到了译码端:联合译码的计算量大于分开译码,且译码器必须建模两方联合分布。这是"代价搬家"的又一例——架构选择不是消灭代价,而是决定代价落在哪一段链路上。传感网络恰好是"节点廉价、基站强大"的拓扑,代价搬家搬得称心如意。
速率区域图与代价流向
有损扩展:怀纳齐夫编码
无损版本之外,一九七六年的怀纳齐夫定理把问题推进到有损:当接收端已持有边信息(另一观测端的数据)时,编码端不需要的失真-码率下界与"编码端也能看到边信息"时相同——又一次"信息不在编码端也能省"。这是第 3 章速率失真理论的分布式版本:边信息把有效失真预算放大,正如相关性把有效熵压缩。视频编码里的"旁路帧"设计(利用另一路已解码画面做参考)是这个定理在工程界的远亲。
速率分配的实操:不对称分账怎么选
速率区域给了自由度,工程要的是选点。三个常见准则对应三种业务形状。对称准则:两传感器同等重要,各发各的边缘熵乘一个安全系数——牺牲部分节省换实现简单(不需要联合建模)。不对称准则:一方是高清主数据(如视频)、另一方是低清辅助(如深度图),主方全速发边缘熵,辅方压到条件熵——多视点编码的标准做法,辅助视图靠主视图"陪衬"解出。最小合计准则:上行带宽是瓶颈(传感网的常态),两方合计压到联合熵、分配比例按链路质量定——哪边信道好哪边多发。
无论哪种准则,联合分布的知识都从编码端搬到了系统设计端:基站要么离线学习两方相关性并下发码率配比,要么用带外信道维持一个粗的相关性跟踪。定理保证"相关性可以被利用",利用的成本与维护的机制是定理不管、工程要管的另一半——这与第 5 章分离定理"架构保最优、细节靠自己"的口径完全一致。
本节要点回顾
- 斯莱普里安-沃尔夫定理:相关信源分开编码、联合译码,合计速率可达联合熵——与拉专线联合压缩打平,相关性收益一分不漏;
- 速率区域三条界:各自不低于条件熵、合计不低于联合熵;区域形状允许不对称分账,总账不变;
- 节省量恰为互信息:朴素方案多付的部分就是没利用的相关性,数字上严丝合缝;
- 机理是"把商量搬进译码端":编码端只管索引典型集,译码端在联合典型集合里唯一锁定组合;
- 代价搬家:速率与编码复杂度双降,译码复杂度与联合分布知识集中到基站——拓扑匹配时是净赢;
- 怀纳齐夫编码是有损扩展:边信息在译码端就足以放大失真预算,编码端无需知情。
秤网的两条定理讲完。下一章走出经典疆界:分布未知时的通用编码、量子比特的称量规则、以及"信息的新鲜度"如何被定义成一个可优化的量。