8.2 数据压缩与存储:从通用工具到闪存
8.2 数据压缩与存储:从通用工具到闪存
本节摘要:实测通用压缩工具在重复文本、自然语言与随机数据上的三档表现,用熵界解释其差异;检阅硬盘与固态硬盘的纠错栈如何与介质特性共同决定容量密度的演进;以 DNA 存储为例看压缩与纠错在极限介质上的交汇。
一段文本的三张成绩单
压缩工具装机即用,很少被当作信息论的现场演示——但它恰恰是。用标准压缩库测三类数据。
# 用标准压缩库实测三类数据的压缩表现 import zlib rep = ("信息论给消息称重,熵是砝码的刻度。" * 40).encode("utf-8") # 高度重复 eng = b"Information theory measures information content. " \ b"Entropy quantifies uncertainty in probability distributions. " * 40 import random random.seed(3) rnd = bytes(random.randrange(256) for _ in range(4000)) # 均匀随机 for name, data in [("重复中文", rep), ("英文长文", eng), ("随机字节", rnd)]: c = zlib.compress(data, 9) print(f"{name}: {len(data):>5} 字节 → {len(c):>5} 字节" f"({len(c) / len(data) * 100:5.1f}%)") # 输出: # 重复中文: 2040 字节 → 81 字节( 4.0%) # 英文长文: 3240 字节 → 95 字节( 2.9%) # 随机字节: 4000 字节 → 4011 字节(100.3%)
三张成绩单正好对应熵理论的三句话。重复文本压到百分之四:短语级重复让熵率极低,字典方法(第 7 章的 LZ 家族)长出长短语,每次输出携带大量信息。英文长文同样压得动:词频倾斜与上下文依赖(真实英文的熵率远低于字符均匀假设)给出大幅压缩空间。随机字节不降反微涨:熵接近每字节八比特满载,无规律可学,压缩器的字典编号本身反而成了开销——成熟实现会检测到这一点转入"原样存储"模式,把膨胀限制在几个字节的头部。诚实的压缩器必须知道自己压不动什么,这是熵界最直白的产品化表达。
顺带把家谱接上:zip 类格式的内核是 LZ77(滑动窗口找重复)加霍夫曼或算术编码(对匹配长度与字面量再压一道)——第 3 章与第 7 章的两代工艺在这类工具里同台。新一代工具的改进集中在更强的建模(更大窗口、上下文混合、专为各数据类型训练的字典)与并行速度,方向始终是"把分布估得更准"——第 3 章那句"压缩的本质是建模"在工具演进史上逐字兑现。
存储介质的纠错栈:密度是被纠错能力买下来的
存储是"信道"最不显眼却最普遍的形态:硬盘的磁畴翻转、固态盘的浮栅电荷、磁带的介质老化,全部服从"读出的不等于写入的"——信道模型照单全收。存储密度每一代的提升,本质上都是一次"介质更密更不可靠 + 纠错更强"的联合升级。
机械硬盘用里德-所罗门码保护扇区,对付的是零星与局部的磁缺陷。固态硬盘的纠错栈则经历了两代跃迁:早期用 BCH 码(汉明码的推广,可纠多位错),随密度提升、单元电荷层级从两位变三位四位,错误率恶化,业界整体转向LDPC 码与软信息译码——闪存控制器先把单元电压读成概率(这个单元是三还是四,置信多少),再把软信息喂给 LDPC 迭代译码。这正是第 4 章"软判决比硬判决多赚约两分贝"在存储界的直接兑现:同一块晶圆,软信息译码让可接受的原始误码率放宽一个数量级,密度与寿命同步受益。控制器的"读重试"机制(换参考电压多读几次)则是第 5 章自适应思想的微缩版。
纠错栈与介质在固态盘里深度耦合,还体现在磨损管理与编码的配合上:擦写次数多的块错误率高,控制器把它迁移到存放冷数据的区域、配上更保守的编码参数——介质状态(信道统计)与编码方案实时联动,"自适应编码"在盘片内部每天上演。
存储栈的分层纠错
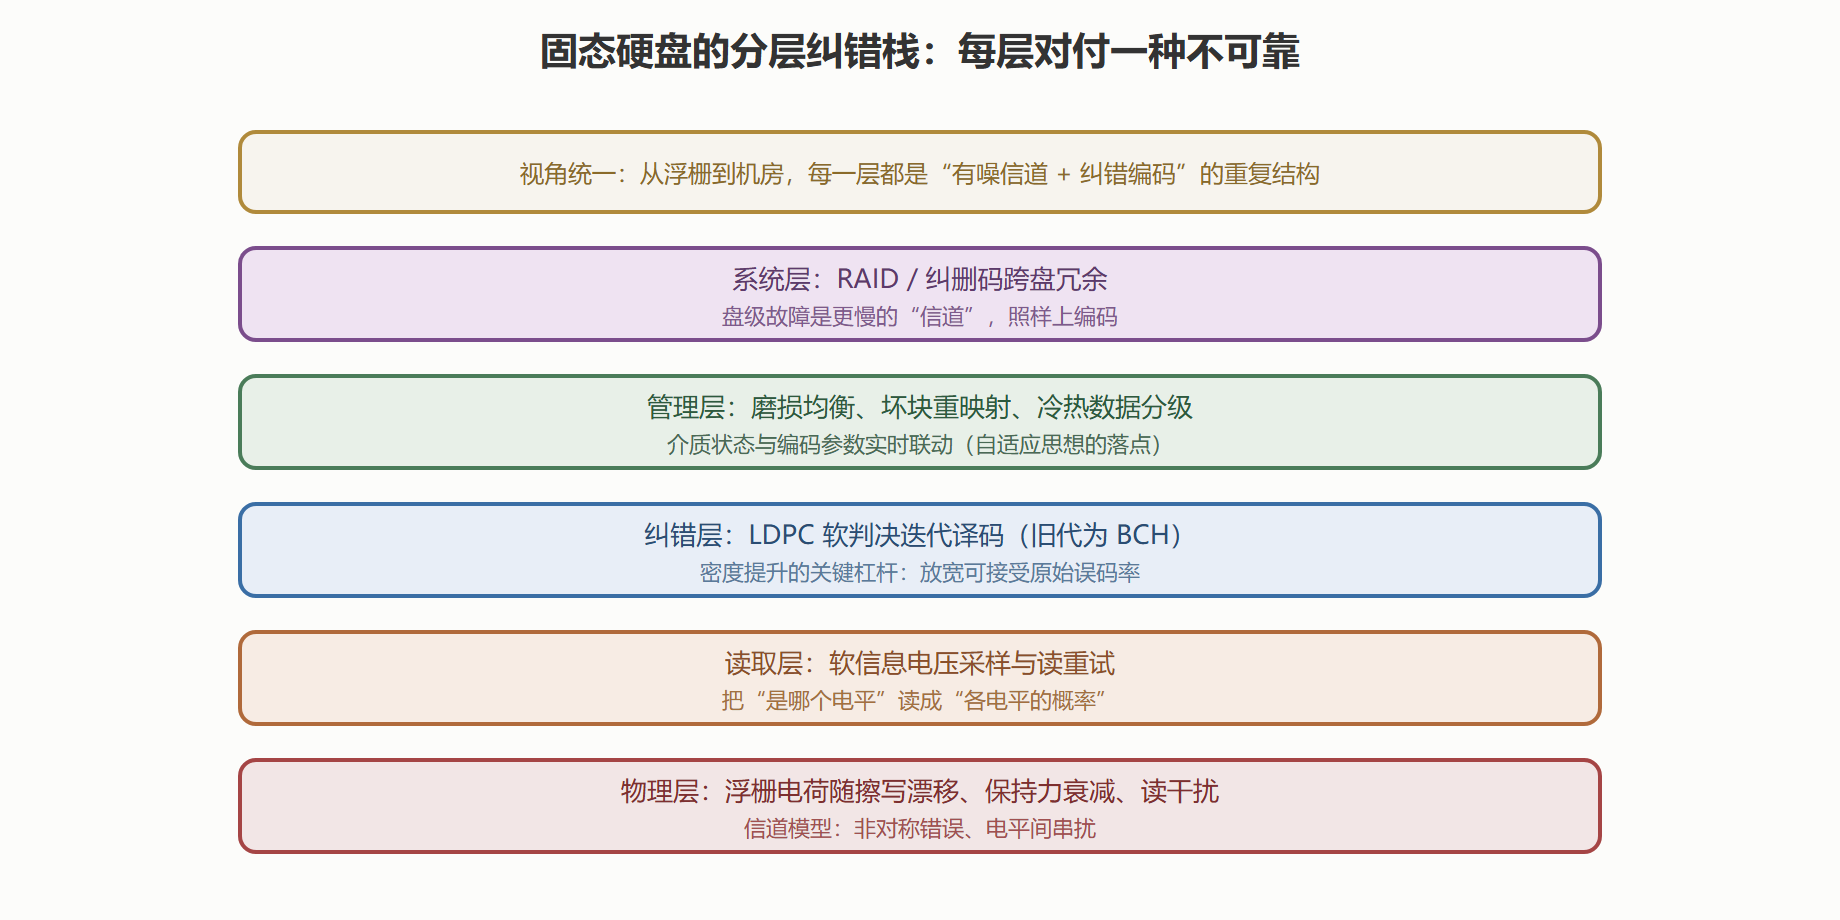
这张分层图值得从下往上读一遍,再从上往下读一遍。从下往上是物理现实的层层恶化(电荷漂移、读干扰、块老化);从上往下是纠错资源的层层部署(软信息、迭代译码、磨损管理、跨盘冗余)。每层的"信道"都由下一层的"编码"兜底——信息论的结构在整条栈上分形重复,这是它作为"通用度量衡"最壮观的产品化现场。
DNA 存储:极限介质上的两门手艺合流
把数据写进脱氧核糖核酸序列,是压缩与纠错在奇异介质上的合流实验。碱基只有四种(天然的四进制符号),合成与测序都有可观的错误率(插入、删除、置换混杂——比通信里的纯翻转更凶),且无法覆写。信息论工具在这块介质上各就各位:编码端要避开生物学的禁忌序列(同聚物长跑、限制酶位点)——这是带约束的编码,正是香农早年研究的信道容量约束问题的回声;纠错端用喷泉码与碱基池的索引编码应对合成丢失与测序错误;池索引用外部地址让海量短链可以乱序并行测序再拼装——本质上又是第 6 章分布式信源"分开存、合并读"的架构。DNA 存储离实用尚远(写入成本与速度),但它是"信息论新介质急行军"的最佳演习场:每换一种介质,容量、失真、约束三张答卷都要重答一遍,而答题框架始终是第 2 到第 4 章那一套。
压缩的经济学:备份、去重与冷热分层
存储场的信息论兑现不只是"压得更小",还包括"在哪里压、压多少"的经济学。备份系统的现代化是去重(只存唯一块,重复块存引用)——它本质是对"跨机器的重复冗余"建模压缩,企业级备份系统的去重比常见达到十比一到三十比一,远超任何单文件压缩器,因为它看到了更大的上下文(全公司的数据而非单个文件)——压缩率的天花板永远由建模视野决定,这是第 3 章"压缩即建模"在系统层的复现。冷热分层则是有损思路的机构版:热数据全精度快速可得,温数据压缩存放,冷数据高压缩比归档(可接受恢复小时级的时延)——不同层级对应速率失真曲线上不同的操作点,存储成本就是那条曲线的纵轴换了个计价单位。
闪存纠错栈的演进还有一个值得记录的细节:纠错能力决定了每一代制程的"可用寿命终点"。闪存块的擦写次数有限,错误率随擦写单调恶化;控制器在块生命周期的不同阶段动态收紧纠错参数(从轻量读重试到全量软判决迭代),把"退役判据"从固定次数变成"纠错后误码率超标"——介质寿命因此普遍延长了三到五成。纠错码在这类系统里不是保险条款,而是直接写在产品规格表第一页的容量来源。
存储纠错方案对照
| 场景 | 主用码型 | 对付的错型 | 设计要点 |
|---|---|---|---|
| 机械硬盘扇区 | 里德-所罗门 | 局部磁缺陷、零星错 | 短码快速译码 |
| 固态硬盘早期 | BCH | 电平误判、多位错 | 硬判决即可满足 |
| 固态硬盘现役 | LDPC 软判决 | 高密度电平串扰 | 软信息+迭代,密度再上一代 |
| 磁带归档 | 里德-所罗门+交织 | 长程划伤、老化 | 交织把突发摊薄 |
| 跨盘冗余 | 纠删码(如里德-所罗门推广) | 整盘故障 | 修复带宽与存储开销的权衡 |
这张表把第 4 章的码族谱系落到了介质上:没有"最强的码",只有"与错误形状匹配的码"——突发错选交织加拉长码,高密度随机错选软判决迭代,整盘故障选纠删码。选型的第一问永远是"错误长什么样"。
本节要点回顾
- 压缩工具的三档成绩单(重复压到百分之四、英文大幅可压、随机微涨)逐条对应熵理论:规律即压缩空间,满熵不可压,诚实回退是熵界的产品化表达;
- zip 类格式 = LZ77 + 熵编码,两代工艺同台;工具演进史就是"把分布估得更准"的逐字兑现;
- 固态硬盘纠错栈经历 BCH 到 LDPC 软判决的跃迁,软信息让可接受原始误码率放宽一个数量级,直接兑换成密度与寿命;
- 磨损管理与编码联动是自适应编码在盘片内部的日常演出——介质即信道,状态即输入分布;
- DNA 存储是压缩、约束编码与分布式编码在极限介质上的合流演习——换介质不换框架,这是信息论通用性的最好证明。
存储场看完,下一节进入机器学习场:互信息如何从通信量具变成神经网络的解剖刀。