第5章 · 学习范式与Sim2Real
第 5 章 · 学习范式与 Sim2Real
章节摘要:前面几章讲了感知、决策、控制,但机器人怎么"学会"这些技能,才是具身智能能否规模化的关键。这一章讲两类主流学习范式与一个绕不开的工程难题:强化学习让机器人通过试错自己摸索策略,模仿学习让机器人从人类示范里直接学动作;而无论在哪学,最终都要面对"仿真里练得很好、真机上却翻车"的 Sim2Real 现实鸿沟。读完你会知道,学习范式决定了机器人技能的来源,Sim2Real 决定了这些技能能否真正落地。
核心问题
阅读完本章,你应当能够:
- 说清强化学习与模仿学习在"技能来源"上的本质区别
- 描述强化学习在机器人任务中的奖励设计与样本效率难题
- 解释模仿学习的示范来源、行为克隆与逆强化学习的基本思想
- 识别 Sim2Real 现实鸿沟的主要来源与迁移策略
- 判断一个机器人任务更适合用 RL 还是 IL,以及如何设计仿真到现实的迁移
核心概念速览
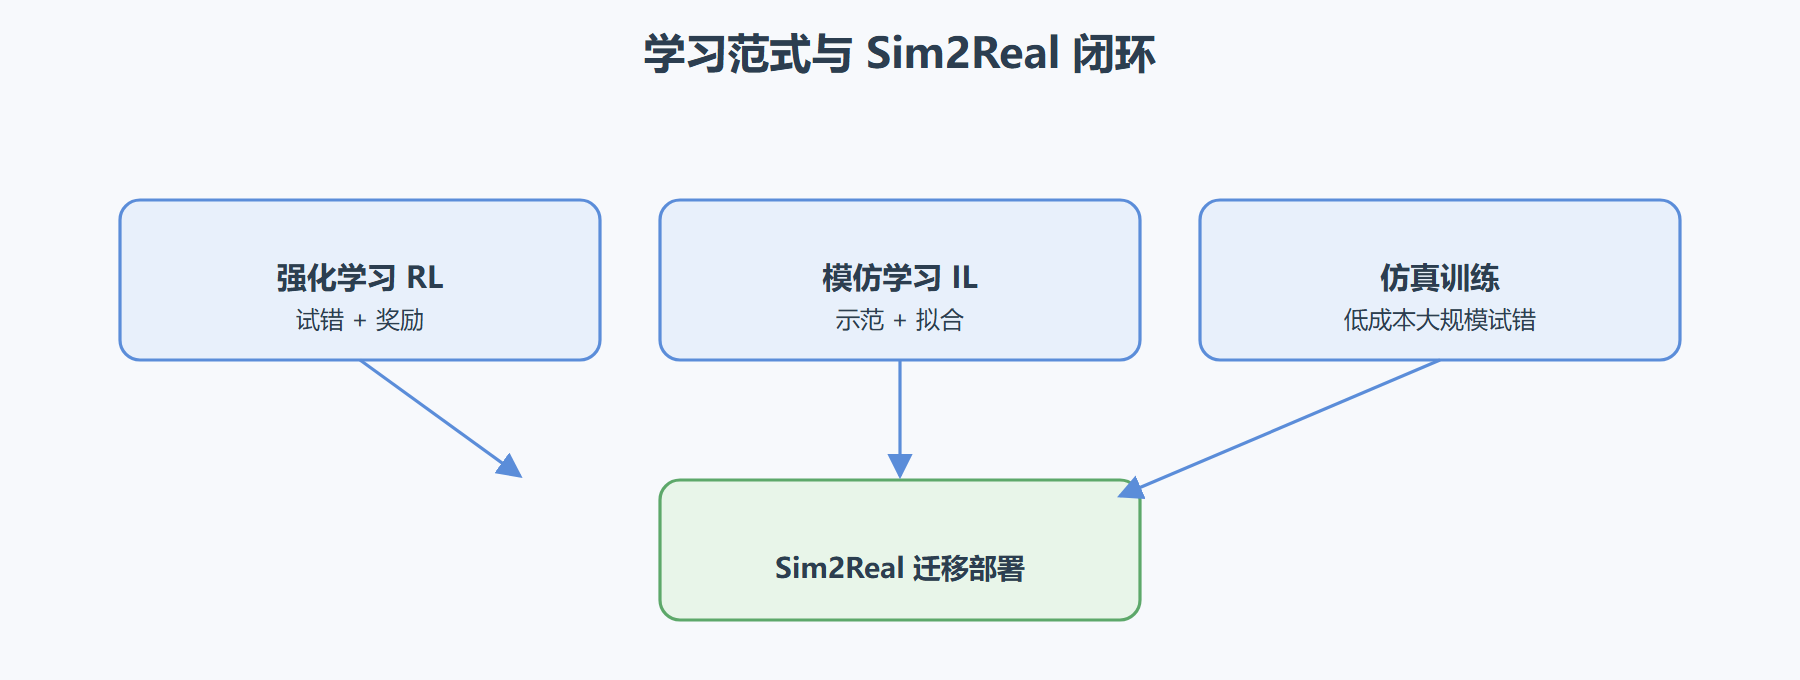
机器人技能不是写出来的,是学出来的。强化学习从奖励里学,模仿学习从示范里学,而 Sim2Real 决定学到的技能能否跨过仿真与现实的鸿沟。
图 5-1:学习范式与 Sim2Real 闭环
子章节导航
5.1 强化学习与模仿学习
讲两种学习范式的机理与取舍。强化学习靠试错和奖励信号自己探索策略,模仿学习靠人类示范直接拟合动作,二者在样本效率、泛化能力、安全性上各有优劣。
5.2 仿真训练与Sim2Real迁移
讲为什么要在仿真里训练、以及仿真到现实之间有哪些鸿沟(视觉差异、动力学差异、噪声差异),再给出域随机化、系统辨识等迁移策略。
子章节之间的逻辑关系
5.1 先解决"怎么学"(RL vs IL),5.2 再解决"在哪学、学了怎么用"(仿真训练与迁移)。前者是学习算法,后者是训练与部署的工程闭环。
5.1 强化/模仿学习 ──► 5.2 仿真与 Sim2Real (怎么学技能) (学了怎么落地)
前置知识与后续延伸
- 前置知识:需要了解基本的机器学习概念(策略、奖励、监督学习)和第 4 章的运动控制。
- 后续延伸:本章之后,附录给出术语表与主流仿真/真机平台对照,方便你动手选型。
评论区
(0)
U