5.1 强化学习与模仿学习
5.1 强化学习与模仿学习
本节摘要:让机器人学会一项技能,有两条主流路线。强化学习(Reinforcement Learning, RL)让机器人在环境里试错,靠奖励信号自己摸索出策略;模仿学习(Imitation Learning, IL)则让机器人从人类示范里直接学习动作,省去自己乱试的过程。两条路线分别对应"从结果里学"和"从榜样里学",在样本效率、泛化能力、安全性上各有鲜明的取舍。本节把两者的机理、适用场景与工程难点讲清楚,帮你在实际任务里做出选择。
阅读收获
阅读完本节,你应当能够:
- 说清强化学习与模仿学习在技能来源上的本质区别
- 描述强化学习中奖励设计与样本效率两大难题
- 区分行为克隆与逆强化学习两种模仿学习思路
- 判断一个机器人任务更适合 RL 还是 IL
- 理解 RL 与 IL 结合(先模仿后强化)的工程价值
一、问题与直觉:技能从哪里来
传统机器人编程是"工程师把每个动作都写死",这在结构化工厂里可行,但面对开放世界就捉襟见肘——你没法为"收拾一张乱七八糟的桌子"写全所有分支。于是人们转向学习:让机器人自己掌握技能,而不是靠人穷举规则。
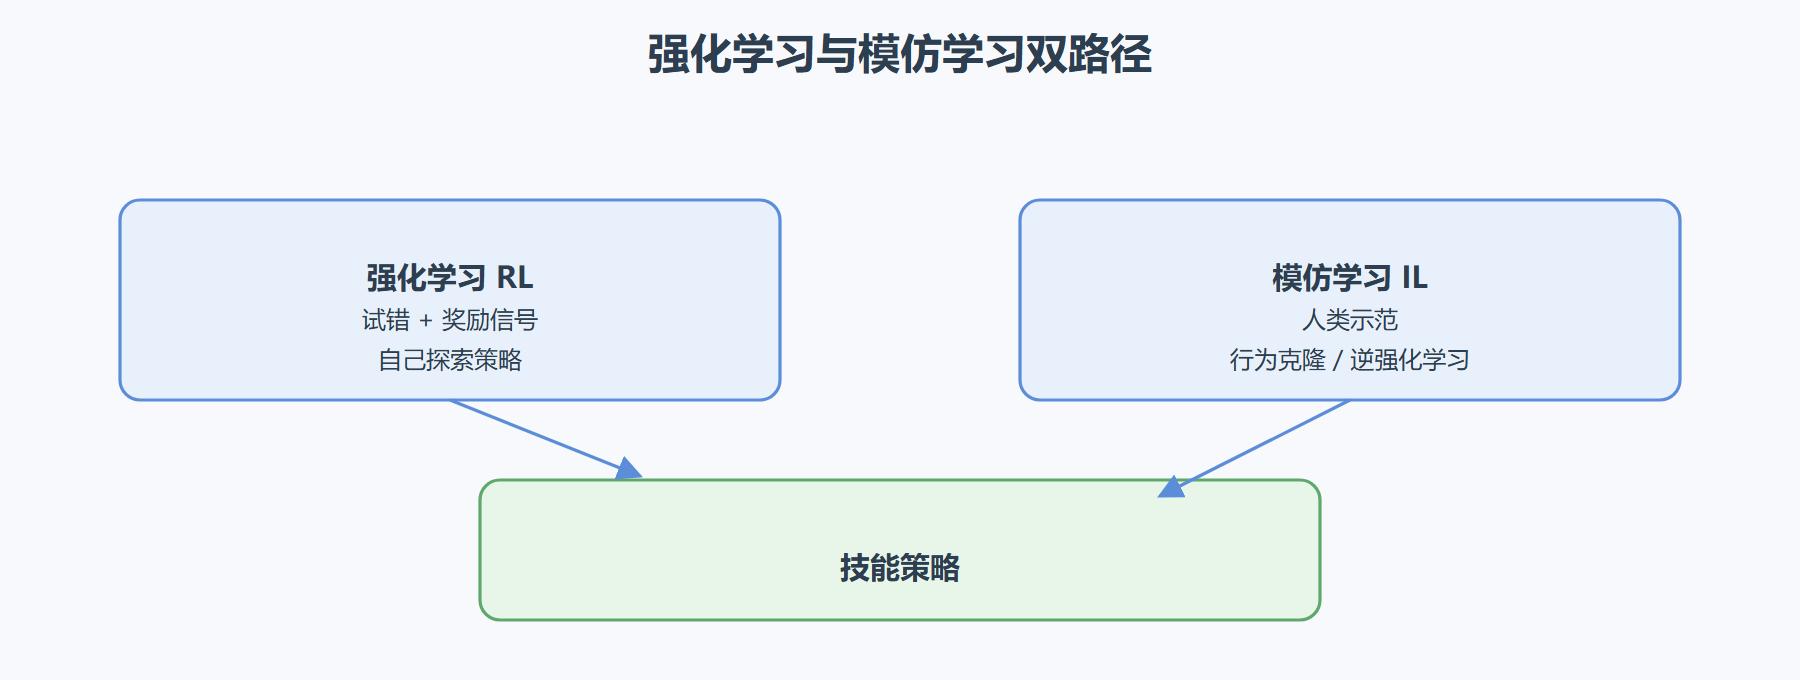
强化学习的直觉是"试错"。你给机器人一个奖励信号,比如"成功抓到杯子得 1 分,打翻扣 1 分",然后让它自己探索。一开始它乱动,偶尔碰巧成功,策略就朝成功方向更新;失败多了,它就避开失败动作。这种"从结果里学"的方式,好处是能发现人没想到的解法,坏处是试错成本高——真实机器人上随便试错,既慢又危险。
模仿学习的直觉是"看别人做"。你给机器人一批人类示范——人抓着机械臂演示几次抓杯子,机器人就学"在这种视觉状态下该输出什么动作"。这种"从榜样里学"的方式,好处是起步快、不用乱试,坏处是它只会学示范里出现过的行为,遇到没见过的场景容易崩。
二、核心原理:两条路线的机理
强化学习:奖励驱动的试错
强化学习把任务建模成马尔可夫决策过程:智能体在状态 s 下选择动作 a,环境返回新状态和奖励 r,目标是最大化累计奖励。在机器人里,状态通常是传感器观测(图像、关节角度、末端位姿),动作是关节力矩或末端速度。核心难点有两个:一是奖励设计——稀疏奖励(只有成功才给分)会让机器人很难起步,需要设计密集的引导奖励;二是样本效率——真实机器人上采样很贵,往往要借助仿真加速。
模仿学习:示范驱动的拟合
模仿学习最直接的形式是行为克隆(Behavioral Cloning):把"状态→动作"的示范对当成监督学习样本,直接训练一个策略去拟合示范。它简单有效,但有分布漂移问题——策略一旦偏离示范分布,误差会累积放大,机器人越走越偏。更进阶的是逆强化学习(Inverse RL):先反推示范背后的奖励函数,再用这个奖励函数去做强化学习。逆强化学习试图学到"为什么这么做",因此泛化更好,但计算代价更高。
三、工程实践要点:怎么选、怎么结合
选择 RL 还是 IL,关键看任务的奖励是否容易定义和示范是否容易获得。如果成功标准清晰、仿真里能大量试错(比如抓取、行走),RL 更合适,它能发现超越人类直觉的策略。如果任务很难用奖励描述、但人类示范很容易(比如精细装配、灵巧操作),IL 更合适,它起步快。安全敏感的场景里,纯 RL 的随机试错风险大,往往需要 IL 先给一个安全起点。
工程上最常见的做法是先模仿后强化:用 IL 从示范里学一个初始策略,再用 RL 在仿真里继续优化。这样既避免了 RL 冷启动的困难,又突破了 IL 的泛化天花板。此外还有 RLHF 式的扩展——用人类偏好反馈来对齐机器人的行为,但那是更进阶的话题。
| 维度 | 强化学习 RL | 模仿学习 IL |
|---|---|---|
| 技能来源 | 试错 + 奖励信号 | 人类示范 |
| 优点 | 能发现超越直觉的策略 | 起步快、安全 |
| 难点 | 奖励设计、样本效率 | 分布漂移、泛化差 |
| 适用场景 | 奖励易定义、可大量试错 | 示范易得、难以写奖励 |
| 典型结合 | 先 IL 冷启动,再 RL 优化 | 作为 RL 的初始策略 |
⚠️ 常见坑:以为"示范越多模仿学习越好"。行为克隆在示范分布内表现好,一旦遇到分布外状态就会累积误差,单纯堆示范并不能解决泛化问题。
💡 关键直觉:RL 从"结果"里学,IL 从"榜样"里学。最实用的路线往往是先让机器人看榜样起步(IL),再让它自己在结果里打磨(RL),而不是二选一。
图 5-2:强化学习与模仿学习双路径
常见问题
为什么真实机器人上很少直接做强化学习
因为真实试错又慢又贵又危险,而且不能并行采样。强化学习需要海量交互才能收敛,真机上跑不起。所以通常先在仿真里做 RL 再迁移到真机,或者先用模仿学习从示范里冷启动一个策略,减少随机试错的次数。直接裸 RL 只在极少数简单、安全、采样快的任务里可行。
行为克隆为什么会分布漂移
行为克隆只拟合示范数据出现的状态分布,一旦策略在某一步犯错、偏离了示范轨迹,后面遇到的都是没见过的新状态,误差就会像滚雪球一样累积,机器人越走越偏。这也是为什么单纯堆更多示范数据并不能根治问题——示范再多,也覆盖不了策略犯错后到达的那些分布外状态。
强化学习和模仿学习能结合吗
能,而且是最实用的路线。工程上常常"先模仿后强化":用模仿学习从人类示范里学一个安全起点,再用强化学习在仿真里继续优化,突破模仿学习的天花板。这样既避免了 RL 冷启动的困难,又弥补了 IL 泛化不足的短板。
稀疏奖励下 RL 怎么起步
稀疏奖励意味着只有任务完成才有反馈,机器人很难碰巧成功。常用办法是设计密集的引导奖励(如离目标越近奖励越高),或者用模仿学习先给一个能偶尔成功的初始策略,再让 RL 在此基础上探索,这样就能突破冷启动困境。
要点串联
- 要点一:强化学习靠试错与奖励自己探索策略,模仿学习靠人类示范直接拟合动作。
- 要点二:RL 的两大难点是奖励设计与样本效率,真实机器人上通常要借仿真加速。
- 要点三:行为克隆简单但会分布漂移,逆强化学习泛化更好但计算更贵。
- 要点四:选择 RL 还是 IL 看奖励是否易定义、示范是否易获得。
- 要点五:工程上常"先模仿后强化",用 IL 冷启动、RL 继续优化,兼顾安全与泛化。
下一节我们看这些技能在仿真里练出来后,怎么跨越仿真与现实的鸿沟,真正部署到真机上。