7.1 延迟与吞吐量瓶颈
7.1 延迟与吞吐量瓶颈
本节把第 1 章的"时延四栏分账"升级为可定位、可复算的审计工具:给出一次具体会话的 RTT 分解脚本与瓶颈定位决策树,再用"带宽时延积"把时延与吞吐连接起来——两者共享同一个瓶颈。
RTT 分解:把抱怨变成数字
用户说"卡",调度台听到的是一串待分解的账目。下面这段脚本把三种典型场景的往返时延逐栏列出:
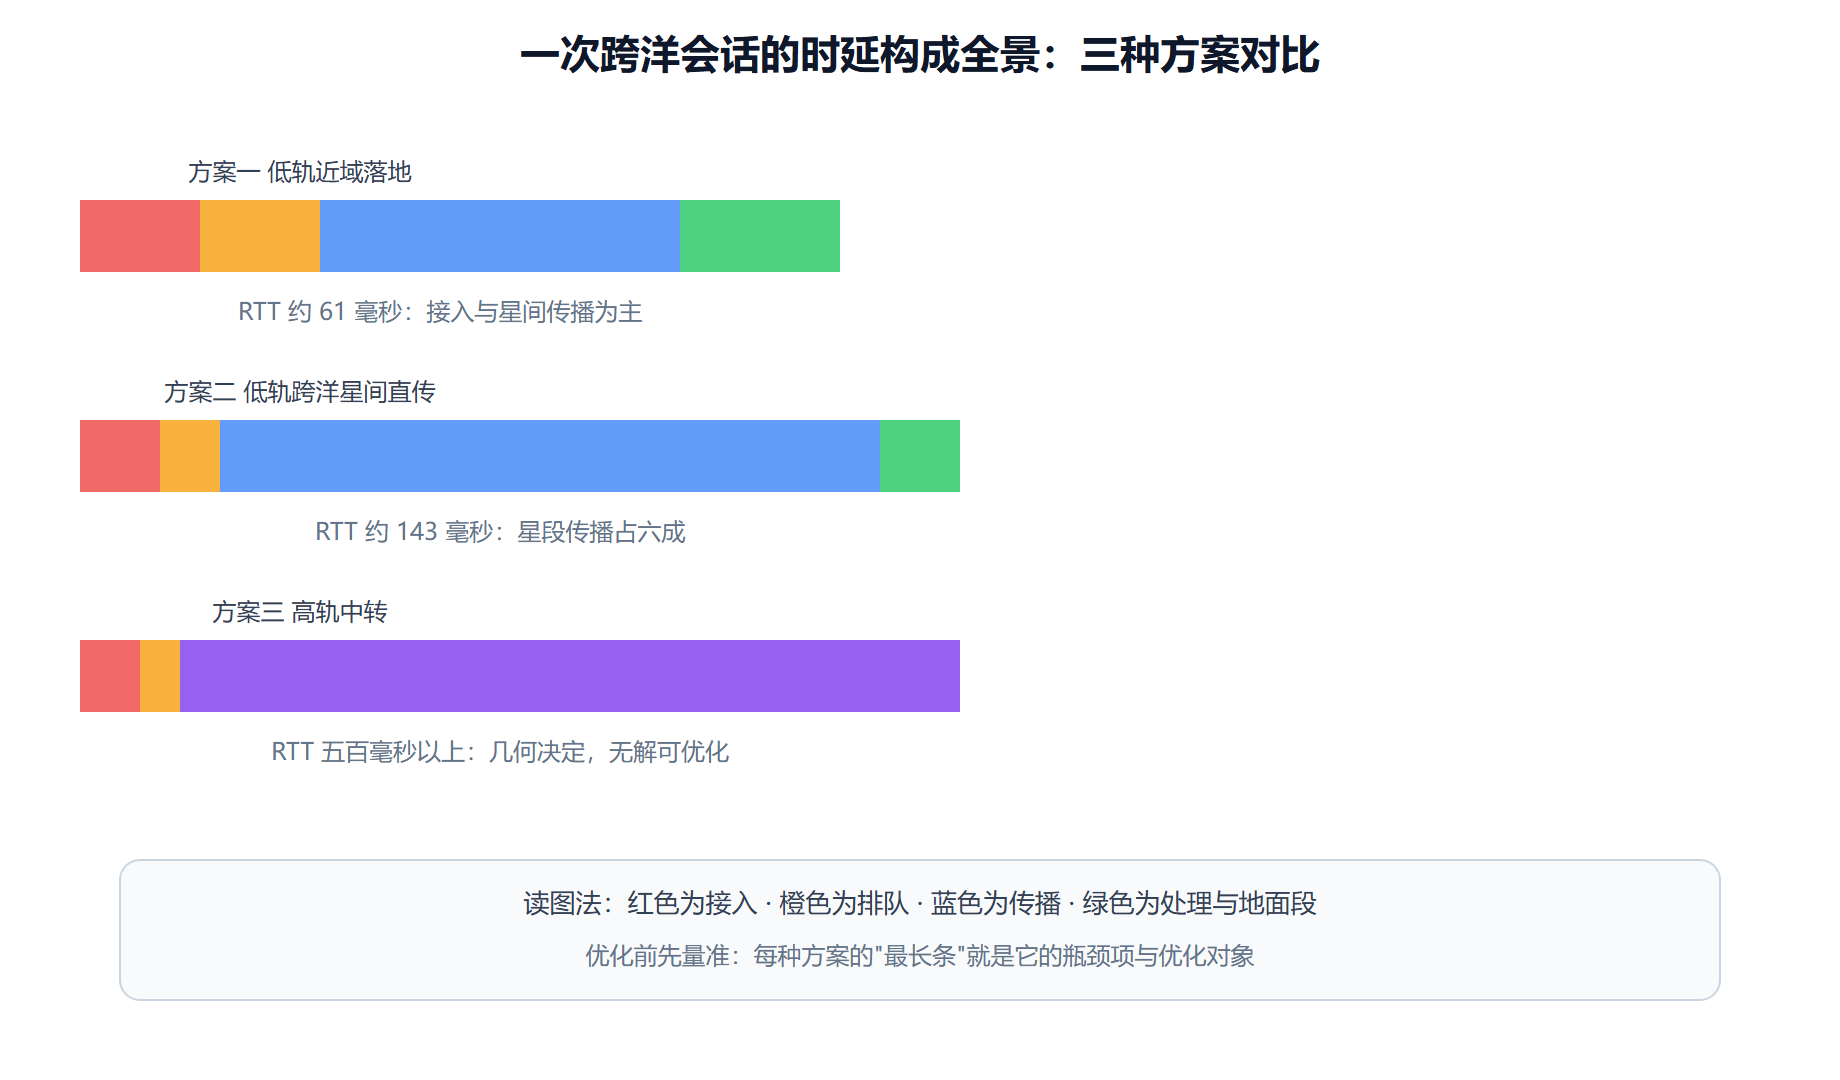
C = 299792.458 # 公里每秒 def rtt_breakdown(h_km, hops, dist_km, access=10.0, queue=3.0, proc=0.5, ground=8.0): prop_space = 2 * (1.3 * h_km + hops * 4500 + 1.3 * h_km) / C * 1000 prop_ground = 2 * dist_km * 1.5 / C * 1000 # 地面光纤,光速按三分之二计 return { "接入": 2 * access, "排队": 2 * queue, "星段传播": prop_space, "处理": 2 * hops * proc, "地面段": 2 * ground, "地面传播": prop_ground, } scenarios = [ ("近距:同城信关站,2 跳星间", rtt_breakdown(550, 2, 50)), ("远距:跨洋星间直传,25 跳", rtt_breakdown(550, 25, 0)), ("远距:地面网绕行,8000 公里光纤", rtt_breakdown(550, 2, 8000)), ] for name, acc in scenarios: total = sum(acc.values()) top = max(acc, key=acc.get) print(f"{name} | RTT 合计 {total:6.1f} ms | 最大单项:{top} {acc[top]:.1f} ms") for k, v in sorted(acc.items(), key=lambda x: -x[1]): print(f" {k}: {v:5.1f} ms({v/total*100:4.1f}%)") # 典型输出: # 近距:同城信关站,2 跳星间 | RTT 合计 61.0 ms | 最大单项:接入 20.0 ms # 远距:跨洋星间直传,25 跳 | RTT 合计 143.5 ms | 最大单项:星段传播 88.5 ms # 远距:地面网绕行,8000 公里光纤 | RTT 合计 139.5 ms | 最大单项:地面传播 80.0 ms
三行输出揭示三个瓶颈形态:近距业务卡在接入栏(优化对象是第 4 章的接入流程与第 6 章的调度);跨洋直传卡在星间传播(优化对象是第 5 章的省跳与信关站加密);地面绕行的地面传播栏与星间直传的星段栏几乎打平——真空光速比光纤快约一半的优势,恰好抵消了更长的折线路径,这就是"低轨长距与地面骨干网打平手"的定量出处,也解释了为什么跨洲时延敏感业务是低轨最难赢的战场、而"无覆盖区域"才是它的必赢盘。
瓶颈定位决策树
拿到实测数据后按序排查:先看基础 RTT(ping 星关站侧网关)是否异常——异常则查星历与切换日志;再比对不同时段(排除拥塞);再测大包吞吐(带宽时延积与限速策略);最后查应用层(DNS、TLS、代理)。经验上"时延正常但网页慢"多半是首屏串联请求叠加(每个请求都交一次接入与握手税),"吞吐上不去但 RTT 正常"多半是窗口或限速策略,"间歇性卡顿"九成是切换事件或雨衰降档。把这三条经验与上面的分解脚本对照使用,大部分"网慢"投诉可以在十秒内归类。
时延审计的总纲:先分栏、再定位、后优化——顺序反了就会把钱花在不产生体验的栏上。下一节把镜头从"快"转向"多与稳"。
时延构成透视:一张全景条带图
抖动与时延的第二维度
平均值之外,抖动(时延的波动)与长尾(百分位时延)才是体验的隐形杀手。低轨链路的抖动来源有四:切换尖峰(周期性、可预测)、路由换片(跳数变化的阶跃)、排队波动(负载相关)、雨衰降挡(天气相关)。语音与游戏对抖动的敏感远超对均值——两百毫秒的稳定时延可忍,五十毫秒的正负摆动不可忍。抖动的治理与均值不同:均值靠优化路径,抖动靠平滑机制(终端侧接收缓冲、播放缓冲、包级双播择优)。审计网络时永远同时看三个数:均值、九十九分位、抖动方差——三个都健康才是真健康,只报均值的报表值得警惕。
一个端到端优化案例:首屏从三秒到六百毫秒
把本章工具用于一个完整优化案例。起点:某卫星宽带用户反馈网页首屏约三秒。分解:DNS 解析一个 RTT、TCP 建连一个 RTT、TLS 一个 RTT、首请求一个 RTT、串行子请求再两三个 RTT——六个往返乘六十毫秒就是三百六十毫秒的"往返税",叠加慢启动爬坡与内容下载,总账约三秒。优化分三刀:第一刀网络侧,信关站前置 DNS 与 TLS 终结(5.3 节的缓存节点),砍掉两个往返;第二刀协议侧,启用 QUIC 零额外往返握手与大初始窗口,再砍一个往返并加速爬坡;第三刀应用侧,首屏资源合并与预取(这部分是应用团队的传统手艺)。三刀下来首屏降到六百毫秒级——注意三刀分属三个团队、三层栈,任何一刀单独砍都到不了终点。这个案例是"性能优化是全栈协作"的最短证明,也示范了 7.1 节分解脚本在真实排障里的用法:先分解定位,再分层认领。
脚本扩展:加上排队论的一层
把 7.1 的分解脚本升级一档,加入排队论的近似:排队时延随利用率非线性上升(M/M/1 型系统的经典关系,平均排队约等于服务时间乘以利用率除以一减利用率)。含义立即可读:利用率百分之五十时排队温和,百分之八十时排队翻四倍,百分之九十以上呈雪崩——这就是"容量用到八成就该扩容"这条行业经验公式(著名的排队墙)的出处。把它接到 RTT 账本上:忙时利用率若逼近九成,排队栏会从个位数毫秒暴涨到几十毫秒,成为压倒一切的第一瓶颈。性能工程师的护城河从来不是背下这些数,而是知道每个数随哪个变量怎样弯——利用率曲线是最常救命的这一条。
指标口径备忘:测量的三个坑
时延测量本身有三个经典坑,审计报表时先排这三个。坑一"测点位置":从终端测包含无线接入与全部星段,从信关站测只含星段,两者差一个接入时延——对比不同来源的数字先对齐测点。坑二"样本口径":平均值、中位数与九十九分位在同一网络里可以差一个数量级,报数必须带口径(第 7 章开篇的"带口径"原则在测量层的落地)。坑三"负载条件":空载测量是理想值,忙时测量才是承诺值,标注测量时的网络利用率才公平。三个坑都排掉,一条时延曲线才值得解读——而解读的方法,就是本节的分栏分解加瓶颈定位树。